2. 3D视觉基础
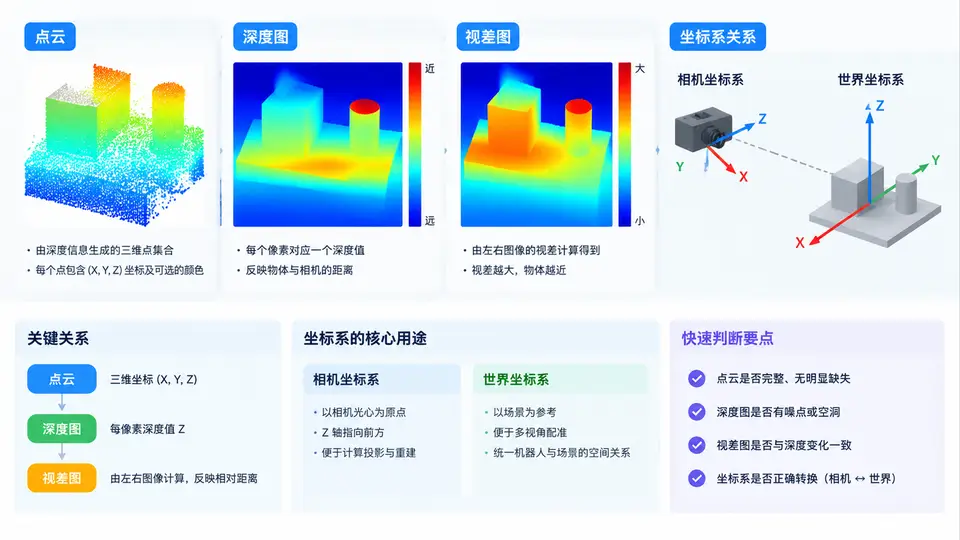
在进入Halcon的3D抓取位姿计算之前,必须先建立对3D视觉数据表示与空间坐标体系的清晰认知。抓取位姿的本质,是在三维空间中描述物体相对于机器人基座的六自由度(6DOF)位置与姿态。而这一描述,必须建立在统一的坐标系与可靠的数据源之上。本章将围绕四种核心概念展开:点云、深度图、视差图,以及相机坐标系与世界坐标系的变换逻辑。
2.1 三种3D数据表示:点云、深度图、视差图
3D视觉系统输出的原始数据,通常以三种形式呈现。它们描述同一场景的不同维度,但数据结构、精度特性与适用算法截然不同。
2.1.1 深度图(Depth Map)
深度图是一张单通道灰度图像,每个像素的灰度值代表该像素对应空间点到相机光心(或参考平面)的距离。深度图与RGB图像天然对齐(若使用RGB-D相机),因此可以直接利用2D图像处理经验进行ROI提取。但深度图存在两个显著问题:
- 缺失值(空洞):反光表面、黑色吸光物体或遮挡边缘会产生无效像素(通常为0或NaN)。
- 精度随距离衰减:基于结构光或ToF的深度相机,在远距离(>3m)时深度误差呈二次方增长。
2.1.2 视差图(Disparity Map)
视差图是双目立体视觉的中间产物。它记录左右相机图像中对应匹配点的水平像素偏移量。视差值与深度成反比关系,由三角测量原理决定:
Z = (f * B) / d其中,Z为深度,f为焦距(像素单位),B为基线距离(米),d为视差值(像素)。视差图本身不是最终产品,但它是计算深度图的前置步骤。Halcon中通过binocular_disparity算子生成视差图,再通过disparity_to_point_3d转换为3D点云。
2.1.3 点云(Point Cloud)
点云是三维空间点的集合,每个点包含(X, Y, Z)坐标,可选包含RGB颜色或法向量信息。点云是抓取位姿计算中最常用的数据形式,因为它直接提供了物体的几何形状。Halcon中,点云以Object3D模型存储,支持通过xyz_to_object_model_3d从三通道图像(X、Y、Z图)创建。
| 数据形式 | 维度 | 精度特点 | Halcon典型算子 | 适用场景 |
|---|---|---|---|---|
| 深度图 | 2D(单通道) | 像素级,有空洞 | read_depth_image | 快速ROI提取、遮挡判断 |
| 视差图 | 2D(单通道) | 与基线/焦距相关 | binocular_disparity | 双目系统中间产物 |
| 点云 | 3D(N×3) | 空间精度高,数据量大 | xyz_to_object_model_3d | 位姿估计、表面匹配 |
sample_object_model_3d降采样以提升处理速度。
2.2 相机坐标系与世界坐标系
位姿计算的本质是坐标变换。在3D视觉抓取中,至少涉及四个坐标系:图像坐标系、相机坐标系、世界坐标系(标定板坐标系)、机器人基坐标系。本章重点阐述前两者与后两者的关系。
2.2.1 相机坐标系(Camera Coordinate System)
相机坐标系以光心为原点,Z轴指向相机前方(主光轴方向),X轴向右,Y轴向下(遵循右手定则,但Y轴方向与图像坐标系一致)。点云数据默认就在相机坐标系下。Halcon中,通过标定得到的相机内参(焦距、主点、畸变系数)可以将2D像素坐标反投影到相机坐标系下的3D坐标:
// 像素坐标 (row, col) 转相机坐标 (X, Y, Z)
// 假设已读取相机内参 CameraParam
image_points_to_world_plane (CameraParam, PoseCamera, Row, Col, 1, X, Y)
// 其中 PoseCamera 为相机在世界坐标系中的位姿,此处若为单位变换则得到相机坐标
2.2.2 世界坐标系(World Coordinate System)
世界坐标系是人为定义的绝对参考系,通常设置在标定板平面或机器人基座上。在Halcon中,世界坐标系通过Pose(位姿)来描述。一个Pose包含三个平移量(X, Y, Z)和三个旋转量(RX, RY, RZ),表示从世界坐标系到相机坐标系的变换关系。
相机坐标系与世界坐标系的转换关系为:
P_cam = Pose_to_HomMat3d(Pose) * P_world其中,Pose_to_HomMat3d将位姿转换为4×4齐次变换矩阵。Halcon中常用vector_to_rigid或hand_eye_calibration来求解该变换。
2.3 核心原理:从像素到空间点的完整链路
理解3D视觉抓取,必须掌握从2D像素到3D空间点的完整映射链路。该链路分为三步:
- 内参标定:确定焦距、主点、畸变系数,消除镜头畸变。
- 外参标定:确定相机在世界坐标系中的位姿(即
Pose)。 - 反投影:利用内参和外参,将像素坐标映射为世界坐标。
在Halcon中,这一链路被封装为以下流程:
// 1. 读取标定好的内参
read_cam_par (CameraParam, 'camera_param.dat')

// 2. 读取外参(相机在世界坐标系中的位姿)
read_pose (PoseWorld, 'pose_world.dat')

// 3. 将深度图转换为3D点云(相机坐标系)
xyz_to_object_model_3d (X, Y, Z, ObjectModel3D)

// 4. 将点云变换到世界坐标系
rigid_trans_object_model_3d (ObjectModel3D, PoseWorld, ObjectModel3DWorld)xyz_to_object_model_3d算子需要三张单通道图像(X图、Y图、Z图),而不是一张深度图。X图和Y图分别存储每个像素对应的X和Y坐标值。通常由depth_to_xyz或disparity_to_point_3d生成。
2.4 案例场景:双目视觉抓取中的坐标统一
假设一个典型的抓取场景:双目相机安装在机器人手臂上方,抓取传送带上的随机摆放的工件。系统流程如下:
1. 双目相机采集左右图像
   grab_image (LeftImage, LeftAcqHandle)
   grab_image (RightImage, RightAcqHandle)

2. 计算视差图
   binocular_disparity (LeftImage, RightImage, Disparity, Score)

3. 视差图转深度图(Z图),并生成X、Y图
   disparity_to_point_3d (Disparity, CameraParamLeft, CameraParamRight, PoseLeft, X, Y, Z)

4. 生成点云
   xyz_to_object_model_3d (X, Y, Z, ObjectModel3D)

5. 点云滤波(去除离群点)
   remove_outliers_object_model_3d (ObjectModel3D, ObjectModelFiltered, 'distance_3d', 2.0, 0.5)

6. 在点云中搜索工件模型(3D形状匹配)
   find_surface_model (SurfaceModel, ObjectModelFiltered, PoseHypotheses, Score)

7. 将匹配到的位姿从相机坐标系变换到机器人基坐标系
   pose_to_hom_mat3d (PoseHypotheses, HomMat3D)
hom_mat3d_compose (HomMat3D, PoseRobot, PoseFinal)其中,第7步的PoseRobot是机器人基坐标系相对于世界坐标系的变换,通常通过手眼标定获得。最终PoseFinal即为机器人抓取所需的六自由度位姿。
2.5 常见误区与复盘
surface_matching会失败,因为深度图丢失了物体背面和侧面的几何信息。正确做法是先将深度图转换为点云,再进行3D匹配。
pose_to_hom_mat3d得到的矩阵是P_cam = H * P_world。若需要将相机坐标下的点变换到世界坐标,必须使用hom_mat3d_invert求逆矩阵。初学者常犯的错误是直接使用标定得到的Pose,导致抓取位置偏移。
disparity_to_point_3d转换为实际距离。
visualize_object_model_3d检查点云是否畸变。若点云出现扭曲,优先检查相机标定精度,而非算法参数。另外,务必在抓取前用标准块(如陶瓷方块)验证坐标变换的重复精度,确保Pose的旋转分量(RX, RY, RZ)符合右手定则,避免因旋转方向定义不一致导致抓取姿态翻转。
本章所建立的概念是后续所有3D抓取算法的基础。点云提供了几何数据,深度图与视差图是获取点云的手段,而坐标系变换则是将视觉结果转化为机器人动作的桥梁。在Halcon中,熟练掌握xyz_to_object_model_3d、pose_to_hom_mat3d与rigid_trans_object_model_3d这三个算子,即可打通从像素到机器人位姿的完整链路。