4. 数据分类分级治理方案设计与落地
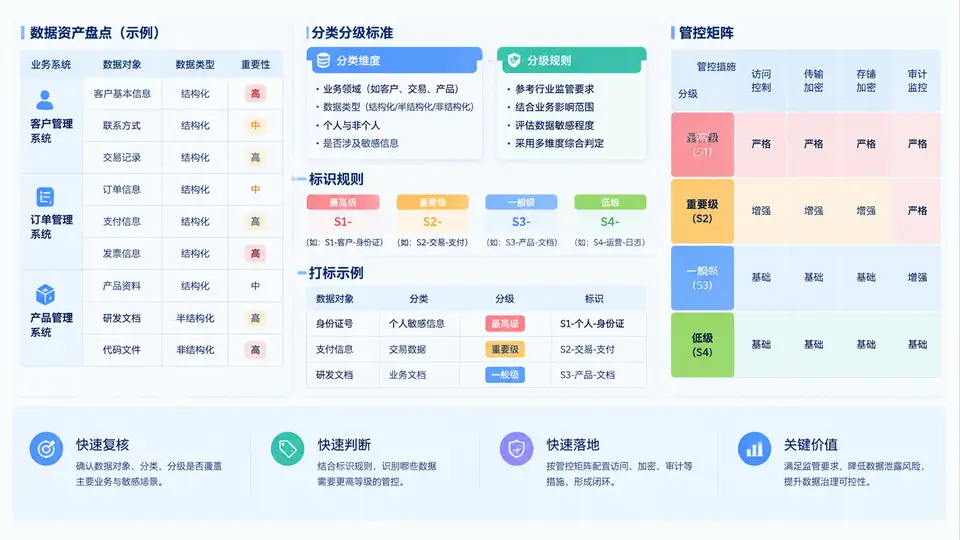
从监管要求到可执行的分级标准
数据分类分级不是给数据贴一个“秘密/公开”的标签,而是把监管要求翻译成企业可执行的四层结构:分类维度(数据属于什么业务对象)、分级依据(泄露/篡改/滥用造成的影响程度)、标识规则(如何在系统与文件中落地标记)、管控矩阵(不同级别对应什么访问、加密、审计、共享要求)。设计时先对齐《数据安全法》《个人信息保护法》及行业监管细则中的“重要数据”“核心数据”“个人信息”等法定概念,再结合企业业务特点扩展内部级别,避免标准悬空。
识别流程:从数据资产盘点到达标
标准设计完成后,需要一套可重复执行的识别流程,把“未知数据”变成“已分级数据”。流程分五步:资产盘点(梳理系统、库表、字段、文件、API)、业务访谈(确认数据用途与流转路径)、自动扫描(用正则/字典/机器学习识别身份证、手机号、银行卡等敏感模式)、人工复核(业务负责人确认级别与分类)、打标入库(写入元数据并同步到管控策略)。其中自动扫描负责效率,人工复核负责准确性,两者缺一不可。
业务系统数据资产盘点与分级打标示例
以某电商企业的“订单中心”系统为例,选取 6 个代表性字段进行盘点与打标。假设该企业已定义 L1–L4 四级标准,且行业监管要求“用户身份证号、银行卡号”必须达到 L3 及以上。
| 字段名 | 业务含义 | 分类维度 | 识别方式 | 影响判断 | 定级 | 标识规则 |
|---|---|---|---|---|---|---|
| order_id | 订单编号 | 业务运营 | 元数据扫描 | 泄露无实质影响 | L1 | level=L1 |
| product_name | 商品名称 | 业务运营 | 元数据扫描 | 公开可查 | L1 | level=L1 |
| user_phone | 用户手机号 | 客户数据 | 正则匹配(1[3-9]\d{9}) | 可识别个人,骚扰风险 | L3 | level=L3; type=PI |
| user_id_card | 身份证号 | 客户数据 | 正则+校验位 | 身份盗用,监管重点 | L3 | level=L3; type=PI |
| bank_card_no | 银行卡号 | 客户数据 | Luhn 算法校验 | 资金风险,监管重点 | L3 | level=L3; type=PI |
| cost_price | 商品成本价 | 业务运营 | 业务访谈确认 | 泄露影响定价与利润 | L2 | level=L2 |
打标落地要点:标识必须写入数据目录(如 DataHub、Atlas)的元数据属性中,并与访问控制引擎联动。例如 user_phone 标记为 L3 后,查询接口应自动触发脱敏规则(中间四位掩码),导出操作需审批,且所有访问写入审计日志。
常见误区:只做一次盘点就认为分级完成。数据会新增字段、业务会变化、监管要求会更新,建议每季度对核心系统做增量扫描,每年做一次全量复核,并将分级结果纳入数据上线评审卡点。
管控矩阵的落地校验
设计完成后,用三个问题校验矩阵是否可执行:第一,每个级别是否有明确的技术控制手段(如 L3 的存储加密是否已配置)?第二,控制措施是否可被自动化工具验证(如扫描未加密的 L3 字段)?第三,业务部门是否知道自己的数据属于哪一级、该走什么流程?若答案是否定的,说明标准还停留在文档层面,需要补充工具配置与培训宣贯。