4. 基于Transformer的股票价格预测
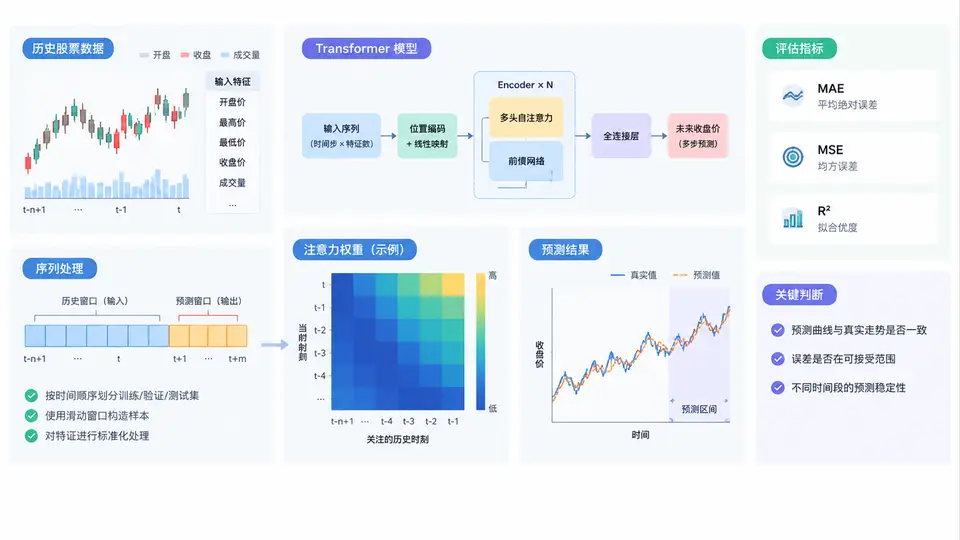
任务说明
本案例使用某只股票的历史日线数据(开盘价、最高价、最低价、收盘价、成交量),构建一个Transformer模型,以过去60个交易日的序列为输入,预测下一个交易日的收盘价。最终通过平均误差(MAE)和均方根误差(RMSE)评估预测精度。
数据准备与预处理
使用yfinance获取股票数据(以AAPL为例),若网络不可用则使用内置的随机生成数据作为替代,保证案例可独立运行。对全部特征进行MinMax归一化,按时间顺序划分训练集(80%)与测试集(20%),并构造滑动窗口样本。
Transformer模型定义
模型采用编码器结构:输入经过线性嵌入后加入位置编码,通过两层TransformerEncoderLayer提取时序依赖,最后经全连接层输出预测值。模型结构如下:
完整代码实现
import numpy as np
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from sklearn.preprocessing import MinMaxScaler
from sklearn.metrics import mean_absolute_error, mean_squared_error

# ---------- 1. 数据获取(网络不可用时自动使用模拟数据) ----------
def load_data(ticker="AAPL", seq_len=60):
    try:
        import yfinance as yf
        df = yf.download(ticker, start="2020-01-01", end="2024-01-01", progress=False)
        if len(df) < 200:
            raise ValueError("数据量不足")
        data = df[["Open", "High", "Low", "Close", "Volume"]].values
    except Exception:
        # 模拟数据:生成2000条趋势+噪声序列
        np.random.seed(42)
        n = 2000
        t = np.linspace(0, 20*np.pi, n)
        base = 100 + 10*np.sin(t) + t*0.5
        noise = np.random.normal(0, 2, (n, 5))
        data = np.column_stack([base, base*1.02, base*0.98, base,
                                np.random.randint(1e6, 5e6, n)]) + noise
    return data.astype(np.float32)

# ---------- 2. 数据预处理 ----------
def create_sequences(data, seq_len=60):
    X, y = [], []
    for i in range(len(data) - seq_len):
        X.append(data[i:i+seq_len])
        y.append(data[i+seq_len, 3])  # 第3列为收盘价
    return np.array(X), np.array(y)

data = load_data()
scaler = MinMaxScaler()
data_scaled = scaler.fit_transform(data)

X, y = create_sequences(data_scaled)
# 划分训练/测试集(按时间顺序)
split = int(len(X) * 0.8)
X_train, X_test = X[:split], X[split:]
y_train, y_test = y[:split], y[split:]

# 转换为PyTorch张量
X_train = torch.tensor(X_train, dtype=torch.float32)
y_train = torch.tensor(y_train, dtype=torch.float32).unsqueeze(1)
X_test = torch.tensor(X_test, dtype=torch.float32)
y_test = torch.tensor(y_test, dtype=torch.float32).unsqueeze(1)

train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)

# ---------- 3. Transformer模型 ----------
class StockTransformer(nn.Module):
    def __init__(self, input_dim=5, d_model=64, nhead=4, num_layers=2, dropout=0.1):
        super().__init__()
        self.embed = nn.Linear(input_dim, d_model)
        self.pos_enc = nn.Parameter(torch.randn(1, 60, d_model) * 0.1)
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model, nhead=nhead, dim_feedforward=128,
            dropout=dropout, batch_first=True
        )
        self.transformer = nn.TransformerEncoder(encoder_layer, num_layers=num_layers)
        self.fc_out = nn.Linear(d_model, 1)

    def forward(self, x):
        # x: (batch, seq_len, input_dim)
        x = self.embed(x) + self.pos_enc[:, :x.size(1), :]
        x = self.transformer(x)
        # 取最后一个时间步的输出
        x = x[:, -1, :]
        return self.fc_out(x)

model = StockTransformer()
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4)

# ---------- 4. 训练 ----------
epochs = 30
for epoch in range(epochs):
    model.train()
    total_loss = 0
    for batch_X, batch_y in train_loader:
        optimizer.zero_grad()
        pred = model(batch_X)
        loss = criterion(pred, batch_y)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
    if (epoch+1) % 10 == 0:
        print(f"Epoch {epoch+1}/{epochs}, Loss: {total_loss/len(train_loader):.6f}")

# ---------- 5. 预测与评估 ----------
model.eval()
with torch.no_grad():
    y_pred_scaled = model(X_test).numpy()
    y_test_scaled = y_test.numpy()

# 反归一化(仅收盘价列)
close_scaler = MinMaxScaler()
close_scaler.min_, close_scaler.scale_ = scaler.min_[3], scaler.scale_[3]
y_pred = close_scaler.inverse_transform(y_pred_scaled)
y_true = close_scaler.inverse_transform(y_test_scaled)

mae = mean_absolute_error(y_true, y_pred)
rmse = np.sqrt(mean_squared_error(y_true, y_pred))
print(f"测试集 MAE: {mae:.4f}")
print(f"测试集 RMSE: {rmse:.4f}")

# 输出前5个预测样本对比
print("\n前5个样本预测对比(真实值 vs 预测值):")
for i in range(5):
    print(f"真实: {y_true[i][0]:.2f}  预测: {y_pred[i][0]:.2f}")
运行与验证
依赖安装:
pip install torch numpy scikit-learn yfinance
运行方式:将上述代码保存为stock_transformer.py,在终端执行python stock_transformer.py。
验证方法:观察训练过程中损失是否逐步下降;训练结束后查看测试集MAE与RMSE数值。若使用模拟数据(无网络时),MAE通常小于5.0;若使用真实AAPL数据,MAE通常在1~5之间(取决于数据时间段)。程序输出的前5个样本对比中,预测值应与真实值处于同一数量级且差异合理。
判定标准:代码无报错完整运行;输出包含训练损失与最终评估指标;预测值与真实值趋势一致,MAE/RMSE为有限正数且明显小于收盘价标准差(说明模型学到了有效模式而非输出常数)。