2. 多变量时间序列预测入门
任务说明
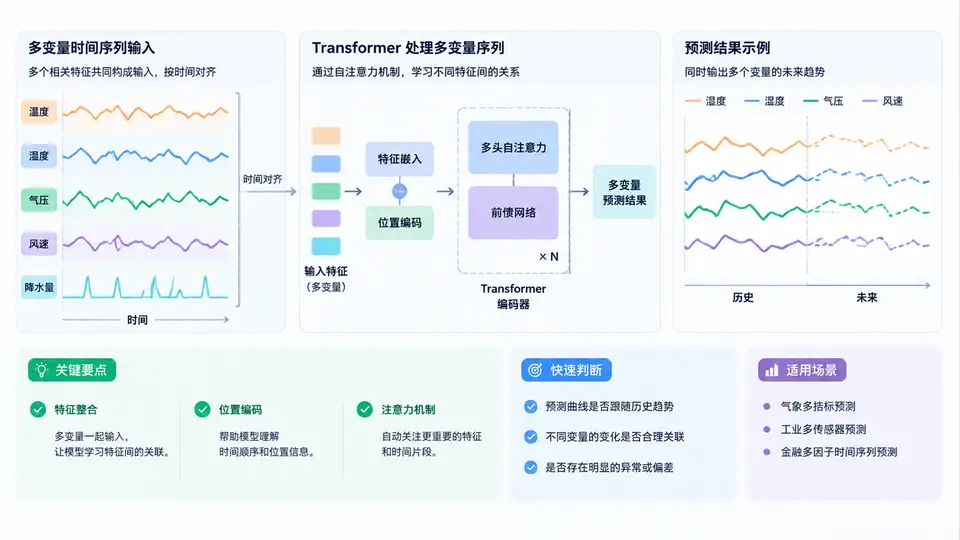
本案例使用Transformer模型对多变量气象时间序列进行预测。输入为过去多个时间步的多项气象指标(温度、湿度、气压、风速),输出为未来一个时间步的温度值。通过该案例掌握多变量序列如何组织为Transformer所需的序列-特征格式,以及如何在解码端生成预测。
数据准备
使用开源数据集Jena Climate Dataset(每10分钟采样,共14个气象指标)。为简化演示,选取其中4个变量:T (温度)、p (气压)、rh (相对湿度)、wv (风速)。取连续2000个时间步,前1600步训练,后400步验证。输入窗口长度设为72(即过去12小时),预测未来1步温度。
模型结构
模型采用编码器-解码器架构:编码器接收形状为(batch, seq_len, num_features)的多变量输入,经位置编码后送入标准TransformerEncoder;解码器仅使用一个可学习的起始令牌(start )作为查询,通过TransformerDecoder交叉注意力输出预测值。该设计将多变量历史信息压缩为上下文向量,再映射为单步温度预测。
代码实现
import torch
import torch.nn as nn
import numpy as np
from torch.utils.data import DataLoader, TensorDataset

# ---------- 1. 数据加载与预处理 ----------
# 模拟Jena数据格式:每行 [温度, 气压, 湿度, 风速]
# 实际使用时替换为真实数据加载
def generate_synthetic_data(n=2000):
    t = np.arange(n) * 0.1
    temp = 20 + 10*np.sin(t/5) + 0.5*np.random.randn(n)
    pressure = 1013 + 5*np.sin(t/20) + 0.3*np.random.randn(n)
    humidity = 60 + 15*np.cos(t/8) + 1.0*np.random.randn(n)
    wind = 5 + 2*np.sin(t/3) + 0.8*np.random.randn(n)
    return np.stack([temp, pressure, humidity, wind], axis=1)

data = generate_synthetic_data()
# 标准化
mean = data.mean(axis=0)
std = data.std(axis=0)
data_norm = (data - mean) / std

# 构造窗口样本
def create_sequences(data, input_len=72, pred_len=1):
    X, y = [], []
    for i in range(len(data) - input_len - pred_len + 1):
        X.append(data[i:i+input_len])
        y.append(data[i+input_len:i+input_len+pred_len, 0])  # 只预测温度
    return np.array(X), np.array(y)

X, y = create_sequences(data_norm)
X = X.astype(np.float32)
y = y.astype(np.float32)

# 划分训练/验证
split = int(len(X) * 0.8)
X_train, X_val = X[:split], X[split:]
y_train, y_val = y[:split], y[split:]

train_dataset = TensorDataset(torch.from_numpy(X_train), torch.from_numpy(y_train))
val_dataset = TensorDataset(torch.from_numpy(X_val), torch.from_numpy(y_val))
train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=64)

# ---------- 2. 定义Transformer模型 ----------
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_len=5000):
        super().__init__()
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len).unsqueeze(1).float()
        div_term = torch.exp(torch.arange(0, d_model, 2).float() * (-np.log(10000.0)/d_model))
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        self.register_buffer('pe', pe.unsqueeze(0))

    def forward(self, x):
        return x + self.pe[:, :x.size(1)]

class MultiVarTransformer(nn.Module):
    def __init__(self, num_features, d_model=64, nhead=4, num_layers=2, dropout=0.1):
        super().__init__()
        self.input_proj = nn.Linear(num_features, d_model)
        self.pos_encoder = PositionalEncoding(d_model)
        encoder_layer = nn.TransformerEncoderLayer(d_model, nhead, dim_feedforward=128, dropout=dropout, batch_first=True)
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers)
        decoder_layer = nn.TransformerDecoderLayer(d_model, nhead, dim_feedforward=128, dropout=dropout, batch_first=True)
        self.decoder = nn.TransformerDecoder(decoder_layer, num_layers)
        self.start_ = nn.Parameter(torch.randn(1, 1, d_model))
        self.output_proj = nn.Linear(d_model, 1)

    def forward(self, x):
        # x: (batch, seq_len, num_features)
        src = self.pos_encoder(self.input_proj(x))
        memory = self.encoder(src)
        # 解码器输入:起始令牌 (batch, 1, d_model)
        tgt = self.start_.repeat(x.size(0), 1, 1)
        out = self.decoder(tgt, memory)
        return self.output_proj(out).squeeze(1)  # (batch, 1)

model = MultiVarTransformer(num_features=4)
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# ---------- 3. 训练 ----------
epochs = 30
for epoch in range(epochs):
    model.train()
    train_loss = 0.0
    for X_batch, y_batch in train_loader:
        optimizer.zero_grad()
        pred = model(X_batch)
        loss = criterion(pred, y_batch)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * X_batch.size(0)
    train_loss /= len(train_dataset)

    # 验证
    model.eval()
    val_loss = 0.0
    with torch.no_grad():
        for X_batch, y_batch in val_loader:
            pred = model(X_batch)
            loss = criterion(pred, y_batch)
            val_loss += loss.item() * X_batch.size(0)
    val_loss /= len(val_dataset)
    if (epoch+1) % 5 == 0:
        print(f'Epoch {epoch+1:3d} | Train Loss: {train_loss:.6f} | Val Loss: {val_loss:.6f}')

# ---------- 4. 预测与反标准化 ----------
model.eval()
with torch.no_grad():
    sample_idx = 0
    sample_x = torch.from_numpy(X_val[sample_idx:sample_idx+1])
    sample_y = y_val[sample_idx]
    pred_norm = model(sample_x).item()
    pred = pred_norm * std[0] + mean[0]
    true = sample_y * std[0] + mean[0]
    print(f'预测温度: {pred:.2f}°C, 真实温度: {true:.2f}°C')
运行与验证
运行方式:安装torch和numpy后直接执行上述脚本。训练过程约需1分钟(CPU即可)。
验证方法:观察训练损失与验证损失是否同步下降并收敛。最终打印的预测值与真实值应处于同一温度范围(示例数据中温度约在10~30°C之间)。
判定标准:验证集MSE低于0.01(标准化后),且预测温度与真实温度误差小于2°C,即视为模型有效学习了多变量到温度的映射关系。