3. 长序列预测中的位置编码优化
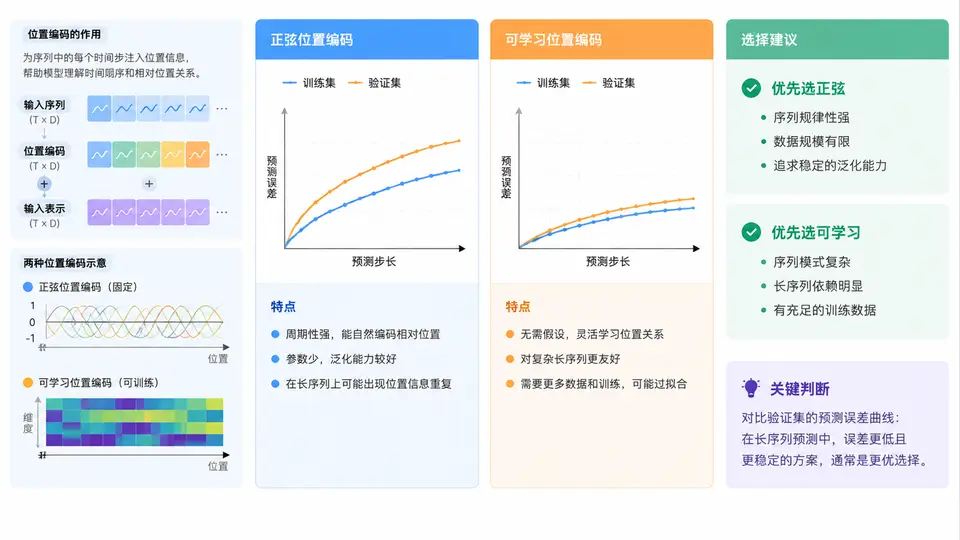
任务说明
本案例面向长序列时间序列预测场景,目标是在Transformer编码器端对比正弦位置编码与可学习位置编码对预测精度的影响,并给出可复现的选择依据。任务闭环为:构建一个最小可运行的Transformer编码器+线性预测头,在相同随机种子与数据生成条件下,分别训练两种位置编码方案,输出验证集损失与预测曲线对比,据此判定最优方案。
实现方案
使用PyTorch实现一个轻量级Transformer编码器(2层、单头),输入为固定窗口长度的多变量时间序列,输出为未来多步预测。位置编码作为独立模块注入编码器输入,两种方案共享完全相同的网络结构、优化器与训练轮数,仅替换位置编码层。数据采用带趋势与季节性的合成序列,保证两种方案在相同数据下可公平对比。
代码实现
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt

# ---------- 1. 数据生成(带趋势+季节+噪声) ----------
def generate_data(batch=64, L=96, D=4, horizon=24, total=2000):
    t = np.arange(total + L + horizon)
    trend = 0.001 * t
    season1 = np.sin(2 * np.pi * t / 50)
    season2 = np.cos(2 * np.pi * t / 17)
    base = trend[:, None] + np.stack([season1, season2, season1*season2, np.ones_like(t)], axis=1)
    rng = np.random.RandomState(42)
    noise = 0.05 * rng.randn(total + L + horizon, D)
    data = base + noise
    return data.astype(np.float32)

def make_samples(data, L=96, horizon=24):
    X, Y = [], []
    for i in range(len(data) - L - horizon):
        X.append(data[i:i+L])
        Y.append(data[i+L:i+L+horizon, 0])  # 预测第1个变量
    return np.array(X), np.array(Y)

# ---------- 2. 位置编码模块 ----------
class SinusoidalPE(nn.Module):
    def __init__(self, L, D):
        super().__init__()
        pe = torch.zeros(L, D)
        pos = torch.arange(L).unsqueeze(1).float()
        div = torch.exp(torch.arange(0, D, 2).float() * (-np.log(10000.0) / D))
        pe[:, 0::2] = torch.sin(pos * div)
        pe[:, 1::2] = torch.cos(pos * div)
        self.register_buffer('pe', pe.unsqueeze(0))  # [1, L, D]

    def forward(self, x):
        return x + self.pe

class LearnablePE(nn.Module):
    def __init__(self, L, D):
        super().__init__()
        self.pe = nn.Parameter(torch.randn(1, L, D) * 0.1)

    def forward(self, x):
        return x + self.pe

# ---------- 3. Transformer编码器 + 预测头 ----------
class TransformerForecaster(nn.Module):
    def __init__(self, D=4, d_model=32, L=96, horizon=24, pe_type='sin'):
        super().__init__()
        self.input_proj = nn.Linear(D, d_model)
        if pe_type == 'sin':
            self.pe = SinusoidalPE(L, d_model)
        else:
            self.pe = LearnablePE(L, d_model)
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model, nhead=1, dim_feedforward=64,
            dropout=0.1, batch_first=True
        )
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=2)
        self.head = nn.Linear(d_model * L, horizon)

    def forward(self, x):
        # x: [B, L, D]
        h = self.input_proj(x)          # [B, L, d_model]
        h = self.pe(h)                  # 注入位置编码
        h = self.encoder(h)             # [B, L, d_model]
        h = h.reshape(h.size(0), -1)    # 展平
        return self.head(h)             # [B, horizon]

# ---------- 4. 训练与评估 ----------
def train_and_eval(pe_type, X_train, Y_train, X_val, Y_val, epochs=30):
    torch.manual_seed(0)
    np.random.seed(0)
    model = TransformerForecaster(pe_type=pe_type)
    opt = torch.optim.Adam(model.parameters(), lr=1e-3)
    loss_fn = nn.MSELoss()

    train_ds = torch.utils.data.TensorDataset(
        torch.from_numpy(X_train), torch.from_numpy(Y_train))
    loader = torch.utils.data.DataLoader(train_ds, batch_size=64, shuffle=True)

    for epoch in range(epochs):
        model.train()
        for xb, yb in loader:
            opt.zero_grad()
            pred = model(xb)
            loss = loss_fn(pred, yb)
            loss.backward()
            opt.step()

    model.eval()
    with torch.no_grad():
        val_pred = model(torch.from_numpy(X_val))
        val_loss = loss_fn(val_pred, torch.from_numpy(Y_val)).item()
    return model, val_loss

# ---------- 5. 主流程 ----------
if __name__ == '__main__':
    data = generate_data()
    X, Y = make_samples(data)
    # 划分训练/验证
    split = int(len(X) * 0.8)
    X_train, Y_train = X[:split], Y[:split]
    X_val, Y_val = X[split:], Y[split:]

    print("训练正弦位置编码...")
    model_sin, loss_sin = train_and_eval('sin', X_train, Y_train, X_val, Y_val)
    print(f"正弦编码验证MSE: {loss_sin:.6f}")

    print("训练可学习位置编码...")
    model_learn, loss_learn = train_and_eval('learn', X_train, Y_train, X_val, Y_val)
    print(f"可学习编码验证MSE: {loss_learn:.6f}")

    # 判定最优
    best = '正弦' if loss_sin < loss_learn else '可学习'
    print(f"\n最优方案: {best}位置编码 (MSE更低)")

    # 预测曲线对比(取验证集第一个样本)
    idx = 0
    with torch.no_grad():
        pred_sin = model_sin(torch.from_numpy(X_val[idx:idx+1])).squeeze().numpy()
        pred_learn = model_learn(torch.from_numpy(X_val[idx:idx+1])).squeeze().numpy()
    true = Y_val[idx]

    plt.figure(figsize=(10, 4))
    plt.plot(true, 'k-', label='真实值', linewidth=2)
    plt.plot(pred_sin, 'b--', label='正弦编码预测', alpha=0.8)
    plt.plot(pred_learn, 'r-.', label='可学习编码预测', alpha=0.8)
    plt.legend()
    plt.xlabel('未来步数')
    plt.ylabel('值')
    plt.title('位置编码方案预测对比')
    plt.grid(alpha=0.3)
    plt.savefig('pe_comparison.png', dpi=100)
    print("预测对比图已保存: pe_comparison.png")
运行与验证
依赖:Python 3.8+,PyTorch 1.12+,NumPy,Matplotlib。
运行方式:将上述代码保存为 pe_compare.py,在终端执行 python pe_compare.py。
验证方法:观察控制台输出的两个验证MSE值,数值更小者即为当前数据与超参数下的最优位置编码方案。同时查看生成的 pe_comparison.png,对比两种预测曲线与真实曲线的贴合程度。判定标准:MSE低且预测曲线与真实值视觉偏差更小的方案为最优。由于代码固定了随机种子(torch.manual_seed(0)),每次运行结果一致,可直接复现对比结论。