1. 课程导入
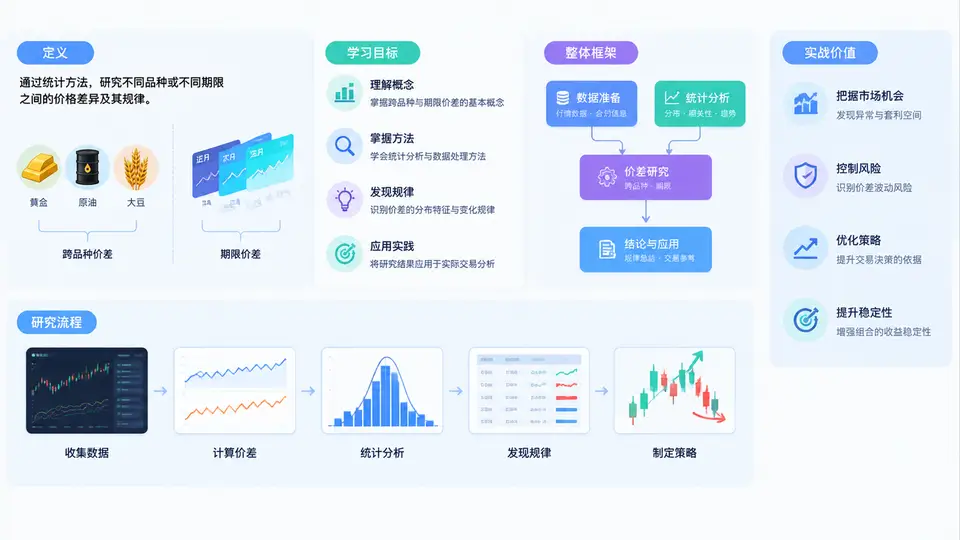
1.1 什么是跨品种与期限价差统计研究
在期货、期权、ETF、可转债以及部分商品现货市场中,价格从来不是孤立存在的。同一资产在不同到期月份上的价格差异,构成期限价差;不同但经济逻辑相关的品种之间的价格差异,构成跨品种价差。例如,原油与燃料油、豆粕与菜粕、螺纹钢与热卷、IF与IC、近月合约与远月合约,这些价格关系背后都隐藏着可被统计刻画的结构。
所谓跨品种与期限价差统计研究,是指以价差序列为研究对象,综合运用描述统计、相关性分析、协整检验、误差修正模型、季节性分解、波动率建模、极值分析与机器学习等方法,识别价差的均值回复特征、周期规律、结构突变与风险边界,并据此构建可复现、可回测、可风控的实战策略。它既不是单纯的技术指标叠加,也不是只做理论推导,而是把统计推断与交易执行连接起来的一整套工作流。
从研究对象的粒度看,价差研究通常分为三个层次:第一层是数据层,处理合约拼接、主力切换、复权、缺失值与异常值;第二层是统计层,估计价差的中心、离散度、半衰期、协整关系与状态转移概率;第三层是决策层,把统计输出转化为开仓阈值、止损边界、仓位权重与退出条件。三层缺一不可,很多失败策略的根源并不是模型不复杂,而是数据层与决策层脱节。
1.2 学习目标:从会算到会判、会做、会复盘
本课程的学习目标不是让大家记住若干公式,而是建立一套可迁移的研究能力。完成本课程后,你应当能够:
- 会定义:针对任意两个相关品种或两个到期月份,明确价差构造方式、经济含义与适用边界。
- 会检验:独立完成平稳性检验、协整检验、Granger因果检验与结构突变检验,并正确解读p值与统计量。
- 会建模:根据价差特征选择均值回复模型、状态切换模型或机器学习模型,而不是盲目套用。
- 会回测:设计包含交易成本、滑点、保证金与换月规则的完整回测框架,避免“纸面收益”。
- 会复盘:对策略失效进行归因,区分是统计关系漂移、流动性变化还是风控参数失当。
1.3 整体框架:一条从数据到决策的完整链路
本课程共30章,整体框架可以概括为“四阶段九模块”。四阶段分别是:数据准备、统计建模、策略构建、实盘复盘。九模块包括:价差定义、数据清洗、描述统计、平稳性与协整、均值回复建模、季节性分析、波动率与风险、组合与仓位、回测与归因。下面用一张表把框架、核心问题与典型输出对齐。
| 阶段 | 核心模块 | 要回答的问题 | 典型输出 |
|---|---|---|---|
| 数据准备 | 价差定义、数据清洗 | 价差怎么构造?数据是否可比、连续、干净? | 价差序列、换月规则、异常值清单 |
| 统计建模 | 描述统计、平稳性与协整、均值回复 | 价差是否均值回复?回复速度多快? | 半衰期、ADF统计量、协整向量 |
| 策略构建 | 季节性、波动率、组合与仓位 | 何时开仓?仓位多大?风险边界在哪? | 阈值表、仓位权重、止损规则 |
| 实盘复盘 | 回测与归因 | 策略是否稳健?失效原因是什么? | 净值曲线、回撤归因、参数敏感性 |
这条链路的关键在于闭环。统计建模的输出必须能直接进入策略构建,策略构建的假设必须能在回测中被检验,回测的归因结果又要能反向修正数据清洗与模型选择。任何一环断裂,研究就会退化为“为了建模而建模”。
1.4 核心原理:价差为什么可以被研究
价差研究的底层逻辑来自三个经济学与统计学事实。第一,经济替代与套利约束:相关品种在消费、生产或交割上存在替代关系,长期价格不会无限偏离,否则会引发套利或替代行为。第二,持有成本与便利收益:期限价差受仓储、资金、保险与便利收益影响,这些因素具有可观测的周期性与季节性。第三,统计上的均值回复与协整:即使单个价格序列非平稳,其线性组合仍可能平稳,这为价差交易提供了统计基础。
但必须强调,均值回复不是永恒定律。结构突变、政策调整、交割规则变化、产业格局重塑,都可能让原本稳定的价差关系失效。因此,统计研究的目标不是证明“价差一定回归”,而是估计在什么条件下、以多大概率、在多长时间内回归,并为“不回归”准备预案。
1.5 方法流程:一个可复用的最小工作流
为了让后续章节有统一的语言,这里给出一个最小可复用的研究流程。你可以把它当作模板,在每一章中逐步填充细节。
- 定义价差:明确是价差(P1-P2)还是价比(P1/P2),是否考虑合约乘数、汇率与税费。
- 数据对齐:统一时间戳、处理非同步收盘、拼接主力合约、复权处理。
- 描述统计:计算均值、标准差、偏度、峰度、分位数与滚动统计。
- 平稳性检验:ADF、PP、KPSS,判断价差是否适合均值回复建模。
- 协整检验:Engle-Granger或Johansen,估计协整向量与误差修正项。
- 建模与估计:OU过程、AR(1)、马尔可夫状态切换,估计半衰期与回复速度。
- 策略映射:把统计参数转化为开仓Z值、止损Z值、最大持有期与仓位。
- 回测与归因:加入成本、滑点、换月与保证金,做参数敏感性与子样本稳健性检验。
下面是一段示意性的Python代码,用于计算价差并做初步的ADF检验。后续章节会在此基础上扩展。
import numpy as np
import pandas as pd
from statsmodels.tsa.stattools import adfuller

# 假设 df 包含两列价格:leg_a, leg_b
df['spread'] = df['leg_a'] - df['leg_b']
df['zscore'] = (df['spread'] - df['spread'].rolling(60).mean()) / df['spread'].rolling(60).std()

adf_stat, p_value, used_lag, nobs, crit, icbest = adfuller(df['spread'].dropna())
print(f"ADF统计量={adf_stat:.4f}, p值={p_value:.4f}, 滞后阶数={used_lag}")
print("临界值:", crit)
1.6 案例与场景:价差研究在实战中的位置
价差研究在实战中至少有四类典型场景。第一,套利与统计套利:利用价差偏离中枢进行反向交易,赚取均值回复收益。第二,相对价值配置:在股票多空、行业轮动与可转债中,用价差关系替代单边方向判断。第三,风险管理:用跨品种价差监控产业链利润,提前识别上游或下游的挤压风险。第四,做市与流动性提供:在期限结构上提供双边报价,赚取买卖价差与库存管理收益。
以黑色产业链为例,螺纹钢与热卷的价差常被用来观察板材与建材的需求强弱;豆粕与菜粕的价差则反映饲料配方替代与水产养殖季节性。这些价差并非永远稳定,但在特定季节与库存周期下,往往呈现可统计的规律。课程后续会逐一拆解这些案例,并给出可复现的研究脚本。
1.7 实战价值与常见复盘误区
价差统计研究的实战价值,可以概括为三点:提高胜率,因为价差交易天然对冲了部分系统性风险;改善盈亏比,因为均值回复策略的止损边界相对清晰;增强策略容量,因为价差组合可以容纳更大资金而不显著冲击单边市场。但价值能否兑现,取决于是否避开以下误区:
- 过度拟合:在历史数据上反复调参,导致样本外失效。应对方法是保留样本外区间,做滚动回测。
- 忽略成本:价差交易涉及两条腿,手续费、滑点与冲击成本往往是单边的两倍以上。
- 忽视换月:主力合约切换会带来价差跳变,必须使用复权或价差拼接规则。
- 把统计相关当因果:相关性高不代表价差一定回归,必须结合基本面与套利机制。
- 风控缺位:价差可以长期偏离,必须设置最大持有期与硬止损,避免“扛单”。
本章作为课程导入,已经给出了跨品种与期限价差统计研究的定义、学习目标、整体框架、核心原理、方法流程、实战场景与复盘误区。接下来的章节将沿着“数据—统计—策略—复盘”的主线,逐层展开,帮助你把价差研究从概念转化为可执行、可验证、可迭代的实战能力。