1. 课程导入
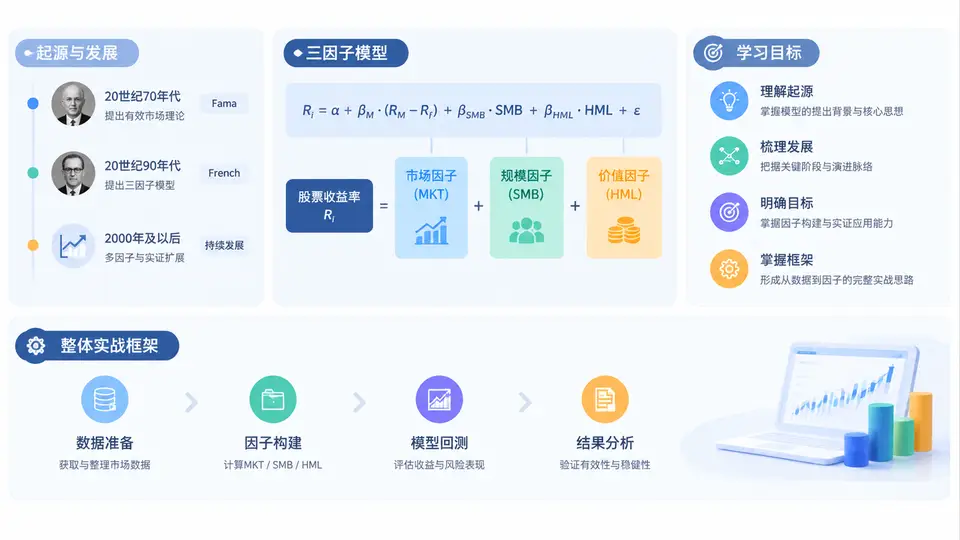
在量化投资与资产定价的学习路径中,Fama-French因子模型几乎是绕不开的一站。它既是对经典CAPM的修正,也是现代多因子体系的起点。本课程的目标不是停留在公式推导,而是带你从零复现一套可运行的风格因子研究流程:从数据获取、因子构造、组合排序,到回归检验与结果解读。作为开篇,我们先厘清这套模型“从哪里来、解决什么问题、我们接下来怎么做”。
一、核心原理:CAPM的困境与因子的诞生
资产定价的核心问题是:一项资产的预期收益,究竟由什么决定?Sharpe(1964)等人提出的资本资产定价模型(CAPM)给出了第一个简洁答案——只有市场风险被定价:
E(Ri) - Rf = βi × (E(Rm) - Rf)

其中:
  E(Ri)  资产i的预期收益
  Rf     无风险利率
  βi     资产i对市场组合的敏感度
  E(Rm)  市场组合的预期收益
CAPM逻辑优美,但实证中屡屡失效。最著名的反例来自Banz(1981)发现的“规模效应”:小市值股票的平均收益长期高于CAPM预测;以及Stattman(1980)、Rosenberg等(1985)发现的“价值效应”:高账面市值比(B/M)股票收益高于低B/M股票。这些无法被单一β解释的收益差异,被称为“异象”(anomalies)。
Fama和French(1992, 1993)系统性地将这些异象整合,提出三因子模型:在市场因子之外,加入规模因子(SMB)和价值因子(HML)。其核心洞见是:β并非唯一风险来源,规模与价值代表了额外的系统性风险补偿。1997年,Carhart加入动量因子(WML)形成四因子模型;2015年,Fama-French进一步扩展为五因子模型,纳入盈利(RMW)与投资(CMA)因子。
关键理解:因子不是“选股技巧”,而是对共同风险暴露的刻画。SMB、HML之所以能带来超额收益,是因为它们承担了特定经济风险,而非市场无效的免费午餐。这一视角决定了我们复现时的严谨态度——每一步都要经得起数据与逻辑的检验。
二、方法流程:因子复现的标准工作流
因子复现不是“跑一个回归”那么简单,它是一条从原始数据到结论的完整链路。本课程将严格遵循以下流程,后续每一章都对应其中一个环节:
- 数据准备:获取股票月度收益、市值、账面价值、无风险利率等;处理生存偏差、缺失值与异常值。
- 因子构造:按市值中位数分组(S/L)、按B/M的30%、70%分位分组(L/M/H),形成6个组合,计算SMB与HML。
- 组合排序:用因子暴露对股票排序分组,构建多空组合,检验单调性。
- 回归检验:时间序列回归估计因子载荷,横截面回归检验因子溢价。
- 结果解读:评估显著性、经济含义、稳健性,并与官方因子库对比。
以三因子构造为例,SMB和HML的计算逻辑如下:
# 6个基础组合(2×3)
SL, SM, SH  # 小市值 × 低/中/高B/M
BL, BM, BH  # 大市值 × 低/中/高B/M

SMB = (SL + SM + SH)/3 - (BL + BM + BH)/3
HML = (SH + BH)/2 - (SL + BL)/2

# 回归模型
Ri - Rf = α + β(Rm - Rf) + s·SMB + h·HML + ε
三、案例场景:一个可复现的研究起点
假设我们要研究A股市场2010—2023年的价值效应。若直接对全市场股票做回归,很可能得到与相反的结论——A股小市值长期占优,但价值因子在某些阶段失效。这正是复现的价值:它让你看到因子在不同市场、不同时期的真实表现,而非教科书上的理想结果。
本课程将以一套完整数据集为线索,带你亲手完成:
- 用Python读取并清洗月度行情与财务数据;
- 构造SMB、HML、RMW、CMA等因子序列;
- 用2×3分组法复现Fama-French官方构造逻辑;
- 对因子收益做回归与显著性检验;
- 绘制因子累积收益曲线,识别失效区间。
学习建议:不要只复制代码。每构造一个因子,先问自己三个问题——它代表什么风险?分组阈值是否合理?结果对参数敏感吗?这三个问题贯穿整个课程。
四、误区与复盘:复现中最容易踩的坑
因子复现看似机械,实则暗藏大量陷阱。以下是最常见的误区,也是本课程反复强调的检查点:
| 误区 | 表现 | 正确做法 |
|---|---|---|
| 前视偏差 | 用当期财报构造当期组合 | 财报需滞后,确保信息可得 |
| 生存偏差 | 只用当前存续股票 | 纳入退市、停牌样本 |
| 分组阈值错误 | 用均值而非中位数分市值 | 严格按Fama-French规则 |
| 忽略交易成本 | 多空组合收益虚高 | 扣除换手与冲击成本 |
| 过度拟合 | 反复调参追求显著 | 样本外检验与稳健性分析 |
复盘提醒:如果复现结果与官方因子差异巨大,先检查数据频率、复权方式、分组时点,而不是急于否定模型。多数“因子失效”其实是实现错误。
五、整体实战框架与学习目标
本课程共30章,围绕“数据—因子—检验—解读”四条主线展开。完成学习后,你应当能够:
- 独立解释Fama-French各因子的经济含义与构造逻辑;
- 用Python从原始数据复现三因子、五因子序列;
- 正确执行时间序列与横截面回归,并解读α与因子载荷;
- 识别并规避复现中的常见偏差;
- 将因子研究结果转化为可讨论的投资洞察。
因子模型不是终点,而是一套观察市场的语言。掌握这套语言,你才能在后续更复杂的多因子、机器学习选股中保持清醒的判断。接下来,我们从数据准备开始,一步步搭建属于你自己的因子研究流水线。