3. 数据挑战
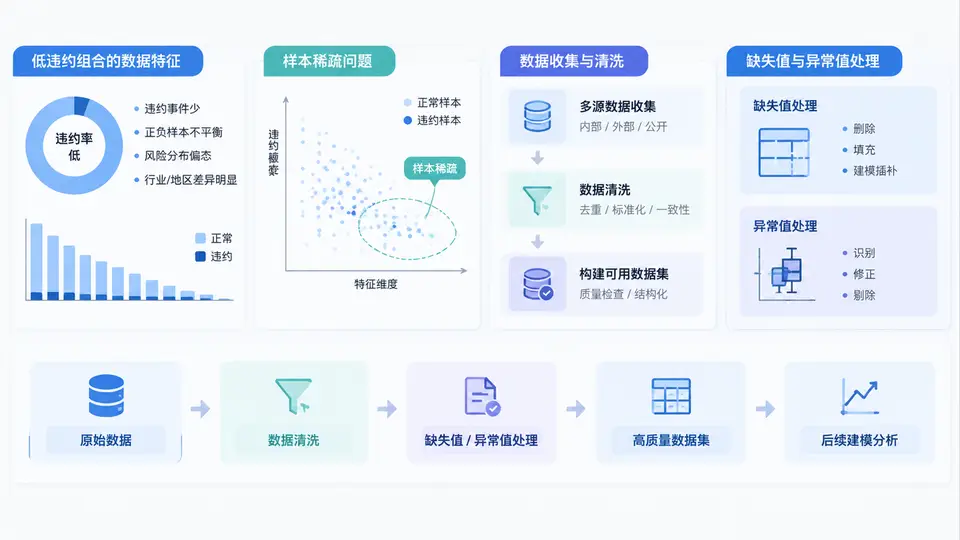
在低违约组合的PD估计中,模型算法往往不是最大的瓶颈,数据本身的质量与结构才是决定校准成败的关键。低违约组合天然具有“违约事件极少、观测周期长、样本分布高度不平衡”的特征,这导致传统基于大样本统计的PD建模方法直接套用时会出现严重偏差。本节围绕数据特征、样本稀疏、收集清洗、缺失与异常处理四个层面展开,帮助你在实战中建立可落地的数据治理框架。
一、核心原理:低违约组合的数据特征
低违约组合通常指在观察期内违约样本占比极低(例如低于1%甚至0.1%)的资产池,常见于高评级企业贷款、主权债、优质零售分期、担保类资产等。其数据特征可归纳为以下几点:
- 事件稀疏性:违约标签为1的样本极少,导致逻辑回归、评分卡等模型难以稳定估计截距与斜率。
- 时间跨度长:为积累足够违约样本,往往需要5年甚至10年以上的观测窗口,期间宏观经济、授信政策、客群结构均发生变化。
- 样本选择偏差:低违约组合常来自风控严格的准入策略,导致“好客户”被过度采样,违约样本被系统性低估。
- 定义不一致:不同时期、不同业务线的违约定义(逾期天数、重组、核销)可能不同,直接合并会引入标签噪声。
- 特征缺失严重:早期数据字段少、口径乱,关键财务或行为变量缺失率可能超过40%。
核心矛盾:低违约组合的PD估计需要“足够多的违约样本”来支撑统计推断,但现实数据恰恰“违约极少”。因此,数据治理的目标不是简单清洗,而是在有限违约信息下最大化有效信息量。
二、样本稀疏问题:影响与应对思路
样本稀疏直接导致三类问题:一是参数估计方差大,PD预测值置信区间宽;二是模型容易过拟合少数违约样本;三是校准曲线在低违约区间严重失真。应对思路包括:
- 延长观测窗口:在业务口径一致的前提下,合并多个年度样本,但需引入时间效应变量或分段校准。
- 降维与特征聚合:减少自由参数,使用行业、区域、评级等粗粒度变量替代高维稀疏特征。
- 贝叶斯先验引入:通过行业PD先验或专家经验构造弱信息先验,稳定后验估计。
- 重采样与加权:对违约样本过采样或对多数类欠采样,但需注意权重校准,避免PD绝对值偏移。
- 迁移学习:借用相似组合或高违约池的模型结构,仅微调低违约组合的截距项。
实战建议:在样本稀疏场景下,优先保证“违约定义一致性”和“观测窗口完整性”,再考虑复杂模型。数据口径混乱带来的偏差,往往比模型选择带来的差异更大。
三、数据收集与清洗方法
数据收集应遵循“先定义、后采集、再校验”的流程。建议按以下步骤执行:
| 阶段 | 关键动作 | 输出物 | 常见风险 |
|---|---|---|---|
| 需求定义 | 明确违约定义、观察点、表现期、样本粒度 | 数据字典、标签规则 | 定义漂移、口径不一致 |
| 数据采集 | 从核心系统、信贷系统、外部征信抽取字段 | 原始宽表 | 字段缺失、时间戳错乱 |
| 数据清洗 | 去重、格式统一、单位换算、逻辑校验 | 清洗后明细表 | 异常值未识别、重复计数 |
| 标签生成 | 按表现期打违约标签,处理提前还款、核销 | 建模样本集 | 标签泄漏、样本穿越 |
| 质量评估 | 缺失率、异常率、分布稳定性、PSI | 数据质量报告 | 忽视时间维度稳定性 |
清洗过程中,建议用脚本固化规则,避免人工反复操作。例如,对日期字段统一格式并检查逻辑顺序:
import pandas as pd

df = pd.read_csv("loan_raw.csv")

# 日期格式统一
df["loan_date"] = pd.to_datetime(df["loan_date"], errors="coerce")
df["due_date"] = pd.to_datetime(df["due_date"], errors="coerce")

# 逻辑校验:放款日不能晚于到期日
mask = df["loan_date"] > df["due_date"]
print("逻辑异常记录数:", mask.sum())
df = df[~mask]

# 去重:同一合同号保留最新记录
df = df.sort_values("update_time").drop_duplicates("contract_id", keep="last")
四、缺失值与异常值处理策略
缺失值处理不能“一刀切”。应先区分缺失机制:完全随机缺失(MCAR)、随机缺失(MAR)、非随机缺失(MNAR)。低违约组合中,财务字段缺失往往与客户质量相关,属于MNAR,直接均值填充会引入偏差。
- 缺失率低于5%:可删除缺失样本或使用中位数/众数填充,并增加缺失指示变量。
- 缺失率5%~30%:优先使用模型插补(如随机森林、KNN),或按业务分组填充。
- 缺失率高于30%:考虑放弃该字段,或将其转化为“是否缺失”的二值特征。
- 异常值:先用箱线图、分位数、业务阈值识别,再判断是录入错误还是真实极端值。录入错误应修正或删除;真实极端值可截断(Winsorize)或单独分箱。
注意:在低违约组合中,任何删除违约样本的操作都必须极其谨慎。违约样本本身就是稀缺资源,误删一个违约样本可能显著改变PD估计结果。建议对违约样本单独审核,非必要不删除。
以下是一个缺失值与异常值处理的参数化示例:
# 缺失值统计
missing_rate = df.isnull().mean().sort_values(ascending=False)
print(missing_rate[missing_rate > 0.05])

# 对高缺失字段生成缺失指示变量
for col in ["income", "debt_ratio"]:
    if df[col].isnull().mean() > 0.05:
        df[col + "_missing"] = df[col].isnull().astype(int)

# 中位数填充 + 异常值截断
for col in ["income", "debt_ratio"]:
    median = df[col].median()
    df[col] = df[col].fillna(median)
    lower = df[col].quantile(0.01)
    upper = df[col].quantile(0.99)
    df[col] = df[col].clip(lower, upper)
五、案例复盘:某优质零售组合的数据治理
某银行优质零售分期组合,观察期内违约率仅0.35%,原始样本12万条,违约样本约420条。初期直接建模导致PD预测值普遍偏高,校准曲线在低违约区间严重偏离。复盘发现三个数据问题:
- 不同年份违约定义不一致,早期将“逾期60天”计为违约,后期改为“逾期90天”,导致标签噪声。
- 收入字段缺失率38%,直接均值填充后与真实分布偏差大。
- 存在少量重复合同记录,导致违约样本被重复计数。
治理措施:统一违约定义为逾期90天;对收入字段采用分组中位数填充并加入缺失指示变量;按合同号去重并保留最新状态。治理后,违约样本从420条降至387条,但PD估计的校准误差下降约40%,模型稳定性显著提升。
关键结论:低违约组合的数据治理,核心不是“把数据洗得最干净”,而是“在保留违约信息的前提下,让数据口径一致、标签可靠、缺失可控”。数据治理的质量,直接决定后续贝叶斯校准的上限。