4. 验证GPU Pod调度与设备分配
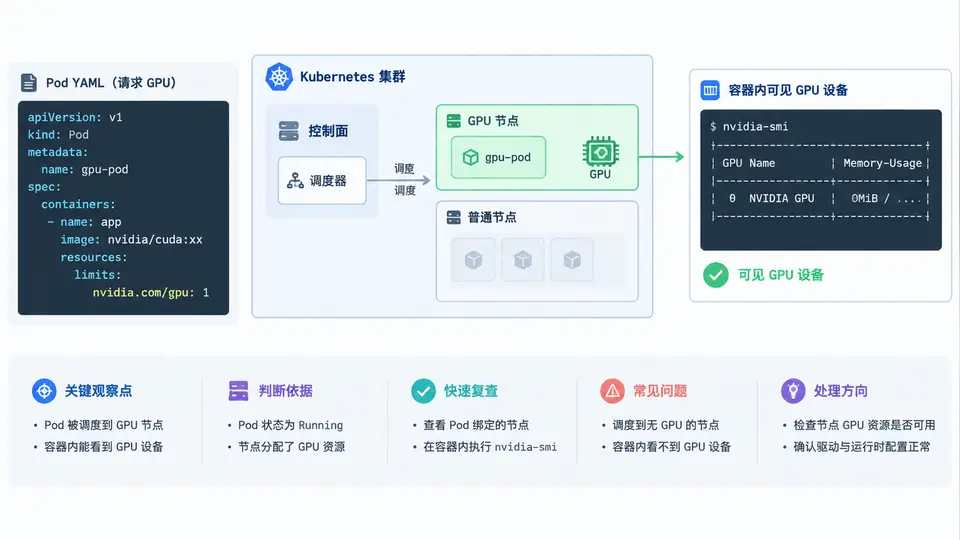
验证目标与前置检查
本例要验证的是一条完整链路:Pod 声明 nvidia.com/gpu 资源 → 调度器筛选出 GPU 节点并绑定 → kubelet 通过 Device Plugin 分配设备 → 容器内 nvidia-smi 能看到 GPU。开始前先确认节点已注册 GPU 资源:
kubectl get nodes -o custom-columns=\
NAME:.metadata.name,\
GPU:.status.allocatable.nvidia\.com/gpu,\
TAINTS:.spec.taints[*].key

# 期望:GPU 节点在 GPU 列显示 >=1,非 GPU 节点显示 <none>
# 若 GPU 列为 <none>,说明 Device Plugin 未就绪,先排查 DaemonSet
创建请求 GPU 的 Pod
GPU 属于扩展资源,必须显式声明 limits,且 requests 与 limits 必须相等(Kubernetes 对扩展资源的强制约束)。下面这个 Pod 请求 1 张 GPU,并打印容器内可见设备:
apiVersion: v1
kind: Pod
metadata:
  name: gpu-verify
spec:
  restartPolicy: Never
  containers:
    - name: cuda
      image: nvidia/cuda:12.4.0-base-ubuntu22.04
      command: ["bash", "-lc"]
      args:
        - |
          echo "=== CUDA_VISIBLE_DEVICES=$CUDA_VISIBLE_DEVICES ==="
          nvidia-smi -L
          nvidia-smi --query-gpu=index,name,uuid --format=csv
      resources:
        limits:
          nvidia.com/gpu: 1
kubectl apply -f gpu-verify.yaml
kubectl get pod gpu-verify -o wide -w观察调度与设备分配过程
Pod 从 Pending 到 Running 的过程,正是调度器与 kubelet 协作完成设备分配的过程。用下面命令逐步确认每个环节:
# 1) 调度事件:确认被哪个节点接收、为何被过滤
kubectl describe pod gpu-verify | sed -n '/Events:/,$p'

# 2) 绑定结果:NODE 列应为 GPU 节点
kubectl get pod gpu-verify -o wide

# 3) 容器内设备可见性
kubectl logs gpu-verify

# 4) 节点侧分配账本:已分配设备 UUID 与 Pod 的对应关系
kubectl describe node <gpu-node> | grep -A5 "Allocated resources"
若 Pod 一直 Pending,
describe 事件里通常会出现 0/3 nodes are available: 1 Insufficient nvidia.com/gpu,说明 GPU 已被占满或未注册;若出现 node(s) had untolerated taint,则是污点未容忍,属于后续案例的处理范围。调度与设备分配链路
下图把本例的验证对象串成一条链路:从 Pod 的资源声明出发,经调度器过滤打分、kubelet 调用 Device Plugin 分配,最终落到容器内可见的设备节点上,并标出每一步的验证命令与判读依据。
结果判读与常见异常
| 现象 | 含义 | 下一步 |
|---|---|---|
Pod 长期 Pending,事件含 Insufficient nvidia.com/gpu | 节点 GPU 已全部分配或未注册 | 检查 allocatable 与已分配账本,确认 Device Plugin 正常 |
事件含 untolerated taint | GPU 节点有污点而 Pod 未容忍 | 为 Pod 增加对应 toleration |
Pod Running 但 nvidia-smi 报 No devices were found | 设备未正确挂载进容器 | 检查运行时配置与 Device Plugin 的 CDI/挂载逻辑 |
nvidia-smi -L 列出多于请求数量的 GPU | 设备隔离未生效 | 确认 CUDA_VISIBLE_DEVICES 是否被正确注入 |
扩展资源不支持超卖:
nvidia.com/gpu 的 requests 必须等于 limits,且不能小于 1。若写成 requests: 1, limits: 2,API Server 会直接拒绝创建。清理与复验
kubectl delete pod gpu-verify
# 复验:删除后节点 GPU 分配量应回落
kubectl describe node <gpu-node> | grep -A3 "Allocated resources"
删除 Pod 后,kubelet 会释放该 GPU 的分配记录,节点 Allocated resources 中 nvidia.com/gpu 应回到删除前的空闲值。若未回落,说明存在分配泄漏,需要检查 Device Plugin 与 kubelet 的通信状态。