3. 部署NVIDIA Device Plugin DaemonSet
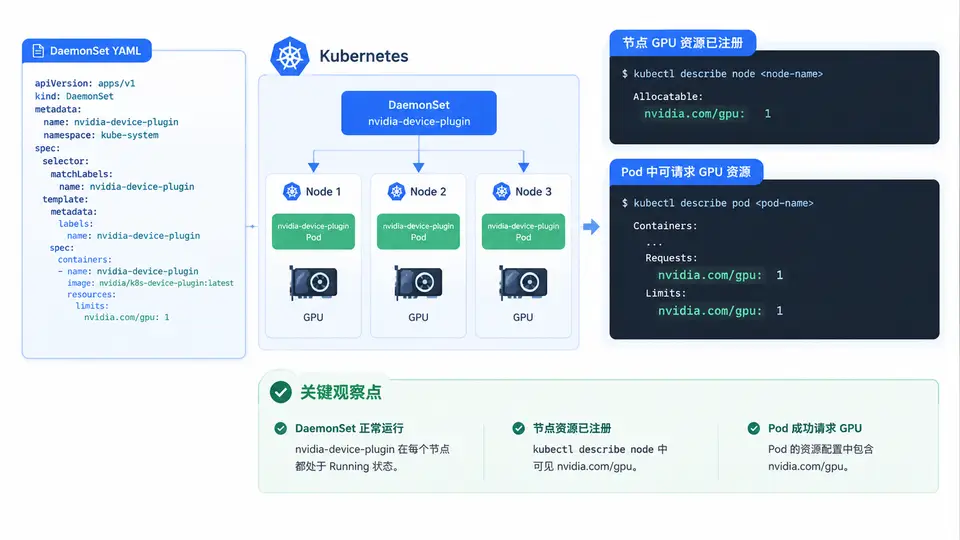
部署 NVIDIA Device Plugin DaemonSet
NVIDIA k8s-device-plugin 以 DaemonSet 形式运行在每个 GPU 节点上,它通过 kubelet 的 Device Plugin gRPC 接口注册 nvidia.com/gpu 资源。部署前需确认节点已安装驱动与 NVIDIA Container Toolkit,且 kubelet 的 --container-runtime-endpoint 指向已配置 nvidia 运行时的容器运行时。
部署清单与关键字段
官方推荐使用 Helm 或直接应用 manifest。以下为精简后的 DaemonSet 关键片段,重点在于 nodeSelector、tolerations、hostPath 挂载与 runtimeClassName 的配合:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: nvidia-device-plugin-daemonset
  namespace: kube-system
spec:
  selector:
    matchLabels:
      name: nvidia-device-plugin-ds
  template:
    metadata:
      labels:
        name: nvidia-device-plugin-ds
    spec:
      nodeSelector:
        kubernetes.io/os: linux
      tolerations:
      - key: nvidia.com/gpu
        operator: Exists
        effect: NoSchedule
      priorityClassName: system-node-critical
      containers:
      - name: nvidia-device-plugin-ctr
        image: nvcr.io/nvidia/k8s-device-plugin:v0.14.5
        securityContext:
          allowPrivilegeEscalation: false
          capabilities:
            drop: ["ALL"]
        volumeMounts:
        - name: device-plugin
          mountPath: /var/lib/kubelet/device-plugins
      volumes:
      - name: device-plugin
        hostPath:
path: /var/lib/kubelet/device-plugins--container-runtime-endpoint 指向 containerd,并在 containerd 配置中设置 default_runtime_name = "nvidia" 或为 Pod 指定 runtimeClassName: nvidia。否则 Device Plugin 虽能注册资源,但 Pod 启动时无法注入 GPU 设备。部署与验证流程
应用清单后,DaemonSet 会在每个匹配节点上创建 Pod。Device Plugin 启动后向 kubelet 注册,kubelet 再将 nvidia.com/gpu 上报到 Node 的 status.allocatable。验证分三步:确认 Pod 运行、确认节点资源注册、确认可被 Pod 请求。
验证节点 GPU 资源注册
部署完成后,执行以下命令确认 Device Plugin Pod 已运行,并检查节点是否上报了 GPU 资源:
# 1. 确认 DaemonSet Pod 状态
kubectl get pods -n kube-system -l name=nvidia-device-plugin-ds -o wide

# 2. 查看节点可分配资源
kubectl describe node <gpu-node-name> | grep -A 5 "Allocatable"

# 3. 直接查询 nvidia.com/gpu 数量
kubectl get node <gpu-node-name> -o jsonpath='{.status.allocatable.nvidia\.com/gpu}'
预期输出中 nvidia.com/gpu 的值应等于节点物理 GPU 数量。若为 0 或字段缺失,按以下顺序排查:
- Device Plugin Pod 是否处于
Running状态,日志中是否有Registered device plugin关键字。 - kubelet 的 device-plugins 目录是否被正确挂载,Pod 内
/var/lib/kubelet/device-plugins/下是否存在kubelet.sock。 - 节点是否已加载
nvidia内核模块,nvidia-smi是否正常输出。 - containerd 配置中是否已设置 nvidia 运行时为默认或可用运行时。
--fail-on-init-error=false 或资源过滤配置。默认情况下,插件会枚举所有可见 GPU。快速验证 Pod 请求 GPU
资源注册成功后,可用一个最小 Pod 验证调度与设备分配是否贯通:
apiVersion: v1
kind: Pod
metadata:
  name: gpu-test
spec:
  containers:
  - name: cuda
    image: nvcr.io/nvidia/cuda:12.2.0-base-ubuntu22.04
    command: ["nvidia-smi"]
    resources:
      limits:
        nvidia.com/gpu: 1
创建后观察 Pod 是否被调度到 GPU 节点,并查看日志确认 nvidia-smi 输出正常。若 Pod 一直 Pending,用 kubectl describe pod gpu-test 查看事件,常见原因为节点 GPU 资源不足或缺少对应 toleration。
nvidia.com/gpu → Node allocatable 出现 GPU 数量 → Pod 可请求并调度。三者缺一不可,任一环节断裂都会导致 GPU 资源不可用。