1. GPU节点基础环境检查与驱动状态确认
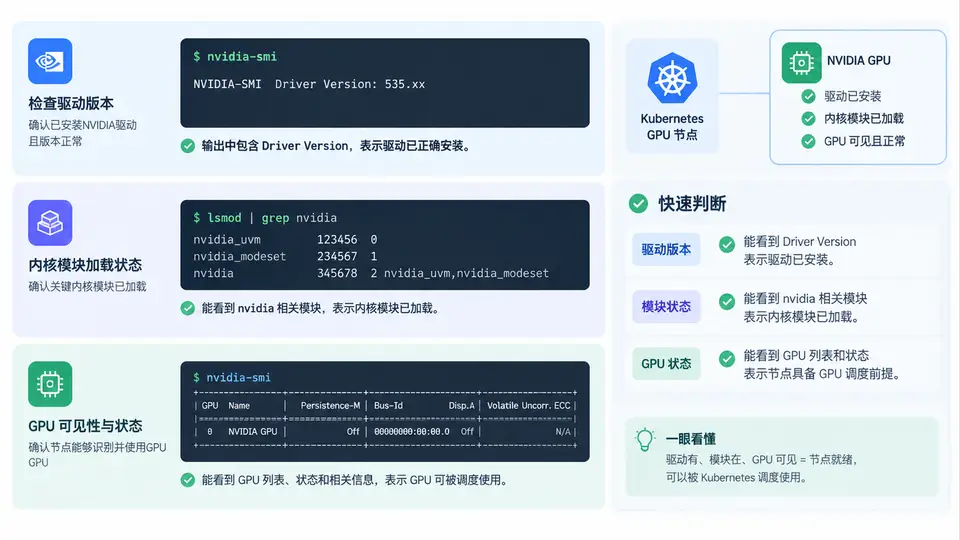
为什么先做“裸机层”检查
在 Kubernetes 把 GPU 注册成可调度资源之前,节点必须先满足三个底层前提:内核里加载了 NVIDIA 驱动模块、用户态能看到驱动版本、nvidia-smi 能枚举出 GPU 设备。这三者任一缺失,后续的 Device Plugin 都会报“no devices found”或资源为 0。因此本节的检查顺序是:内核模块 → 驱动版本 → 设备枚举,逐层向下确认。
逐层检查命令与判读
下面按三层顺序给出可直接在 GPU 节点上执行的命令,以及每层“通过”和“异常”的判读依据。示例输出中的版本号、GPU 型号均为教学示例,实际以节点真实输出为准。
第一层:内核模块是否加载
# 查看 NVIDIA 相关内核模块
lsmod | grep -E 'nvidia|nvidia_uvm|nvidia_modeset'

# 预期输出示例(模块名 + 大小 + 引用计数)
nvidia_uvm           1556480  0
nvidia_modeset       1232896  1
nvidia              56606720  2 nvidia_uvm,nvidia_modeset
判读:只要 nvidia 主模块出现即说明驱动已加载;若 nvidia_uvm 缺失,CUDA 应用可能无法使用统一内存,需检查驱动安装是否完整。若 lsmod 无任何输出,说明驱动未加载,应先排查驱动安装或 Secure Boot 拦截。
第二层:驱动版本是否可读
# 读取内核驱动版本
cat /proc/driver/nvidia/version

# 预期输出示例
NVRM version: NVIDIA UNIX x86_64 Kernel Module  535.129.03  Thu Oct  5 18:24:03 UTC 2023
GCC version: gcc version 11.4.0判读:NVRM version 给出内核态驱动版本。该版本需要与计划使用的 CUDA 运行时、容器镜像中的驱动版本保持兼容。若文件不存在,通常意味着驱动未正确安装或模块未加载。
第三层:设备能否被枚举
# 列出 GPU 设备
nvidia-smi -L

# 预期输出示例
GPU 0: NVIDIA A100-SXM4-40GB (UUID: GPU-3f2a1b8c-...)

# 查看驱动与 CUDA 版本摘要
nvidia-smi | head -12判读:nvidia-smi -L 能列出 GPU 型号和 UUID,说明用户态驱动与设备通信正常。若报 No devices were found,常见原因是模块未加载、设备被其他驱动占用或容器内未挂载设备节点。此时不要继续部署 Device Plugin,应先回到第一、二层排查。
在节点上执行
nvidia-smi 时,如果提示 Failed to initialize NVML: Driver/library version mismatch,说明内核模块版本与用户态库版本不一致,通常需要重启节点或重新加载模块,而不是重装 Device Plugin。检查结果记录表
建议把三层检查结果记录成一张简表,便于后续排障时快速定位是哪一层出了问题。
| 检查层 | 命令 | 通过判据 | 异常时优先排查 |
|---|---|---|---|
| 内核模块 | lsmod | grep nvidia | 出现 nvidia 模块 | 驱动安装、Secure Boot、模块黑名单 |
| 驱动版本 | cat /proc/driver/nvidia/version | 可读到 NVRM version | 驱动包完整性、模块加载状态 |
| 设备枚举 | nvidia-smi -L | 列出 GPU 型号与 UUID | 设备节点、NVML 版本匹配、权限 |
本节只确认节点“裸机层”具备 GPU 调度前提,不涉及容器运行时配置和 Device Plugin 部署。若三层检查均通过但 Kubernetes 中仍看不到
nvidia.com/gpu 资源,问题已不在本节范围,应转向容器运行时与插件层排查。