4. API Server 高延迟的指标分析与参数调优
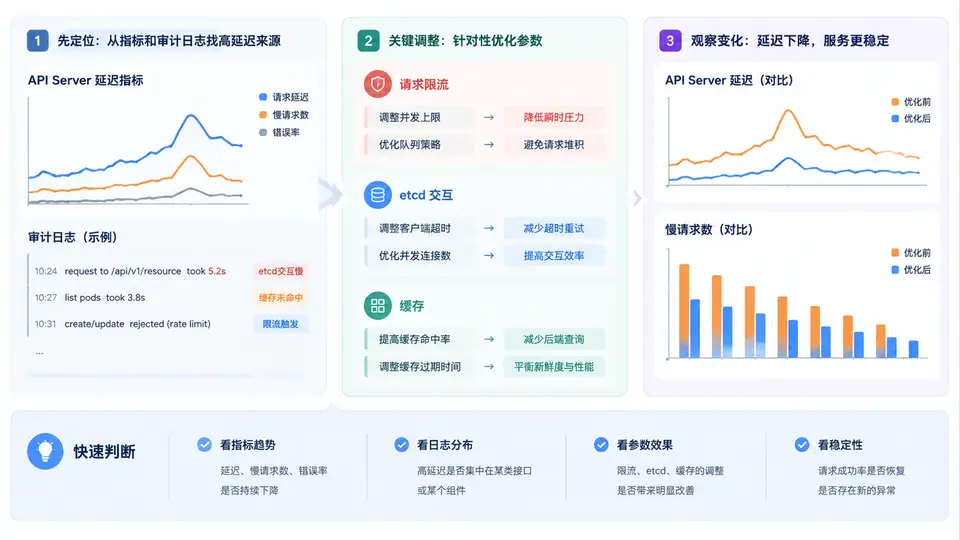
延迟指标定位:先分清 apiserver 内部耗时与 etcd 后端耗时
API Server 高延迟通常不是单一原因,而是请求在“准入 → 鉴权 → 缓存 → etcd → 序列化”链路上某一段被拖慢。排查时先看 apiserver_request_duration_seconds 的 P99 分位,再按 verb(GET/LIST/WATCH/POST)和 resource 拆分,判断是读多还是写多;随后用 etcd_request_duration_seconds 对比,若 apiserver 总延迟高但 etcd 延迟正常,瓶颈多在 apiserver 内部(限流、缓存、序列化);若两者同步升高,则重点转向 etcd 磁盘与网络。
审计日志可提供请求级证据:关注 requestReceivedTimestamp 与 stageTimestamp 的差值,以及 responseStatus.code 为 429/500 的比例。429 增多说明请求限流触发,500 增多则可能是 etcd 超时或 webhook 失败。
审计日志与指标联动:定位高延迟请求的具体来源
仅看聚合指标难以定位到具体请求。建议同时开启审计日志的 RequestResponse 级别(仅针对关键资源),并配合以下 PromQL 查询:
# 按 verb 和 resource 拆分 P99 延迟
histogram_quantile(0.99,
  sum(rate(apiserver_request_duration_seconds_bucket[5m])) by (le, verb, resource)
)

# etcd 后端 P99 延迟
histogram_quantile(0.99,
  sum(rate(etcd_request_duration_seconds_bucket[5m])) by (le, operation)
)

# 429 限流比例
sum(rate(apiserver_request_total{code="429"}[5m]))
/ sum(rate(apiserver_request_total[5m]))
若 verb="LIST" 且 resource="pods" 的 P99 显著高于其他组合,优先检查 --watch-cache-sizes 是否对该资源设置了足够条目;若 verb="POST" 且 resource="leases" 延迟高,则可能是 etcd 写入竞争,需检查 --max-mutating-requests-inflight 是否过小导致排队。
参数调优与验证闭环
以下参数调整需在控制平面节点上修改 kube-apiserver 启动参数,并滚动重启生效。建议每次只调整一组参数,观察 10 分钟后再决定下一步。
| 参数 | 默认值 | 调优方向 | 适用场景 |
|---|---|---|---|
--max-requests-inflight | 400 | 根据节点 CPU 核数适当提高 | 读请求排队严重,429 比例高 |
--max-mutating-requests-inflight | 200 | 写密集场景可提高至 300 | POST/PUT 延迟高,etcd 写入竞争 |
--watch-cache-sizes | 100(默认) | 对 pods、endpoints 等高频资源调至 500-1000 | LIST/WATCH 延迟高,缓存命中率低 |
--etcd-request-timeout | 10s | 网络稳定时可降至 5s 快速失败 | etcd 偶发慢请求导致 apiserver 线程阻塞 |
--etcd-servers-overrides | 无 | 为 watch 请求单独指定 etcd 端点 | watch 流量与普通请求争抢 etcd 连接 |
kubectl get --raw /metrics | grep apiserver_request_duration_seconds 对比调整前后的 P99 分位;同时观察 etcd_request_duration_seconds 是否保持稳定。若 P99 下降但 429 比例上升,说明限流阈值仍偏低,需继续微调。