1. Kubernetes Pod 频繁重启的根因定位与修复
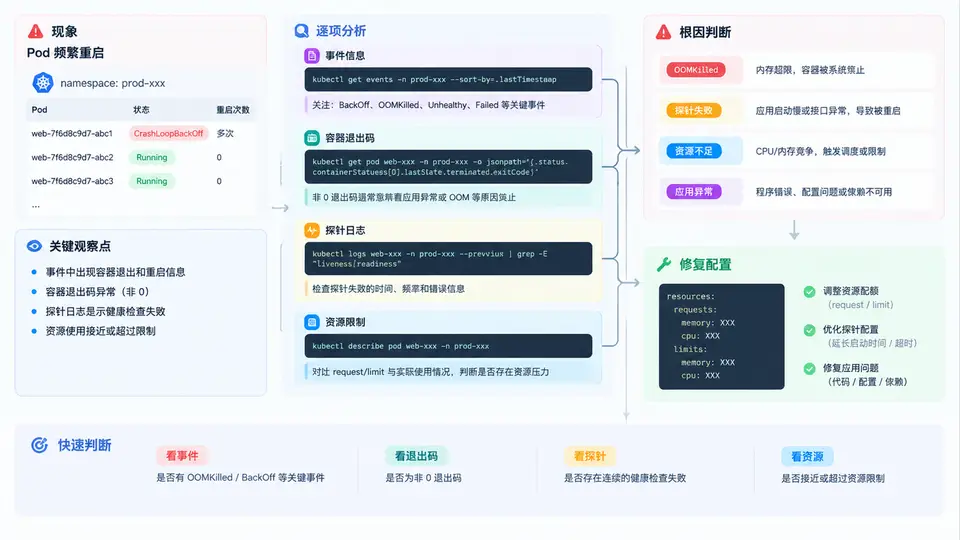
从“重启次数”到“退出码”:一条可复现的定位链
Pod 频繁重启时,RESTARTS 只是表象。真正决定根因方向的是三组证据:容器退出码(进程为什么结束)、探针事件(是进程自己退出,还是被 kubelet 判定失败后杀掉)、资源限制(是否被 OOMKilled 或 CPU 节流拖死)。下面用一条可复现的排查链,把这三组证据串起来。
第一步:用退出码锁定方向
先看 kubectl describe pod 的 Last State 字段。退出码是分诊的第一把刀:
- 137:进程收到 SIGKILL。最常见是 OOMKilled,其次是被 liveness 探针判定失败后 kubelet 杀掉。
- 143:进程收到 SIGTERM,属于正常终止流程,通常来自滚动更新、节点驱逐或手动删除,不算异常重启。
- 1 或 0:应用自己退出。0 是正常退出但容器主进程不应退出;1 是应用报错退出,需要看应用日志。
如果退出码是 137,必须再区分是 OOM 还是探针。看 Reason 字段:OOMKilled 直接指向内存;如果是 Error 且 Events 里有 Liveness probe failed,则是探针问题。
第二步:用事件和探针日志确认触发者
执行 kubectl get events -n <ns> --sort-by=.lastTimestamp,重点看三类事件:
Liveness probe failed/Readiness probe failed:探针连续失败达到failureThreshold后,kubelet 会重启容器。OOMKilling:内核 OOM killer 介入,说明容器内存超过 limit。BackOff:重启间隔被指数退避拉长,说明重启已持续一段时间。
探针失败常见于:initialDelaySeconds 太短,应用还没启动完就被判死;timeoutSeconds 太小,慢请求被误判;探针路径写错或端口不对。
第三步:核对资源限制
查看 kubectl get pod <pod> -o yaml 中的 resources。如果 limits.memory 设置过低,而应用实际峰值超过它,就会反复 OOMKilled。注意 requests 影响调度,limits 影响运行时上限,两者都要合理。
修复配置示例
假设定位结果是:应用启动需要约 40 秒,但 initialDelaySeconds 只有 10 秒,导致 liveness 探针在启动阶段就失败并触发重启。修复如下:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: demo-app
  namespace: stability-lab
spec:
  replicas: 2
  selector:
    matchLabels:
      app: demo-app
  template:
    metadata:
      labels:
        app: demo-app
    spec:
      containers:
      - name: app
        image: demo-app:1.0.0
        ports:
        - containerPort: 8080
        resources:
          requests:
            memory: "256Mi"
            cpu: "250m"
          limits:
            memory: "512Mi"
            cpu: "500m"
        livenessProbe:
          httpGet:
            path: /healthz
            port: 8080
          initialDelaySeconds: 45
          periodSeconds: 10
          timeoutSeconds: 3
          failureThreshold: 3
        readinessProbe:
          httpGet:
            path: /ready
            port: 8080
          initialDelaySeconds: 20
          periodSeconds: 5
          timeoutSeconds: 2
failureThreshold: 3关键改动:initialDelaySeconds 从 10 提到 45,覆盖应用冷启动时间;timeoutSeconds 从 1 提到 3,避免慢响应误判;failureThreshold 保持 3,给偶发抖动留余量。
验证与判断
应用修复后,用以下命令观察 5 分钟:
kubectl get pod -n stability-lab -w
kubectl describe pod -n stability-lab <pod> | grep -A5 "Last State"
kubectl get events -n stability-lab --sort-by=.lastTimestamp | tail -20通过标准:RESTARTS 不再增长;Last State 不再出现 137;Events 中不再有 Liveness probe failed。如果重启停止但 RESTARTS 计数保留历史值,这是正常的,计数不会清零。