2. 节点 NotReady 的快速排查与恢复
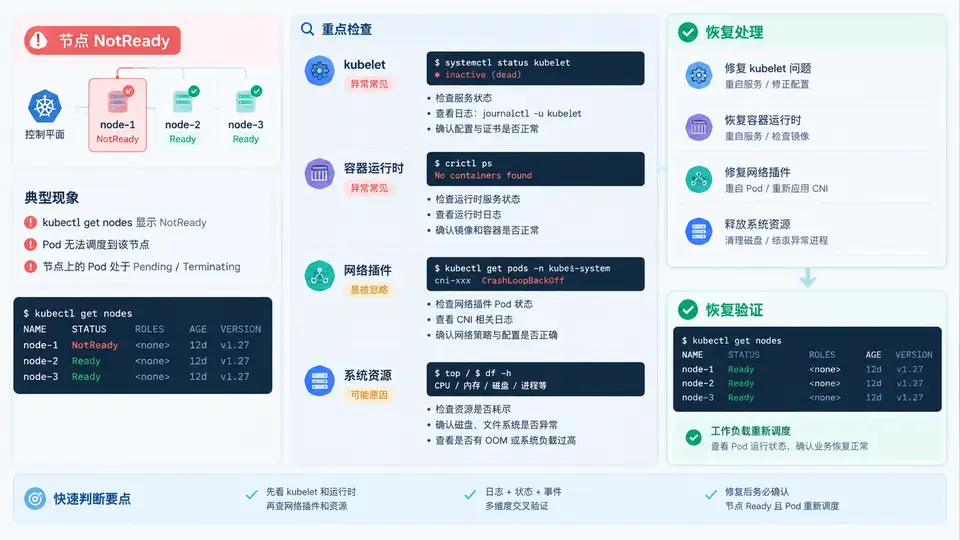
节点 NotReady 的排查路径与恢复验证
节点进入 NotReady 状态时,kubelet 会停止向 API Server 上报心跳,节点上的 Pod 被标记为不可调度,但已有 Pod 不会立即被驱逐。排查的核心是沿着 kubelet → 容器运行时 → 网络插件 → 系统资源 这条链路逐层确认,而不是直接重启节点。
排查命令与关键判读
以下命令按链路顺序执行,每一步的输出决定下一步方向。假设节点名为 worker-01,命名空间为 default。
# 1. 确认节点状态与原因
kubectl get nodes
kubectl describe node worker-01 | grep -A5 "Conditions"

# 2. 检查 kubelet 服务状态与最近日志
systemctl status kubelet
journalctl -u kubelet -n 80 --no-pager | grep -iE "error|fail|timeout"

# 3. 检查容器运行时
systemctl status containerd
crictl info
crictl ps -a | head -20

# 4. 检查网络插件 Pod 状态
kubectl get pods -n kube-system -o wide | grep -E "calico|flannel|cni"

# 5. 检查系统资源
df -h /var/lib/kubelet
free -m
dmesg -T | tail -30 | grep -iE "oom|error|fail"
判读要点:若
kubectl describe node 中 Conditions 显示 Ready=False 且 Reason 为 KubeletNotReady,优先查 kubelet 日志;若 Reason 为 NetworkPluginNotReady,优先查 CNI Pod;若节点磁盘使用率超过 85%,kubelet 可能因 DiskPressure 停止上报。
恢复操作与验证
根据排查结果执行对应修复。以下以最常见的 kubelet 配置错误和磁盘满两种场景为例。
# 场景 A:kubelet 配置错误
# 查看具体报错后修正 /var/lib/kubelet/config.yaml 或启动参数
systemctl daemon-reload
systemctl restart kubelet
systemctl status kubelet

# 场景 B:磁盘满
# 清理未使用的镜像和日志
crictl rmi --prune
journalctl --vacuum-size=200M
# 确认磁盘释放后 kubelet 自动恢复上报

# 验证节点恢复
kubectl get nodes -w
# 等待状态变为 Ready

# 验证工作负载重新调度
kubectl get pods -o wide --field-selector spec.nodeName=worker-01
kubectl get events --field-selector involvedObject.name=worker-01 --sort-by=.lastTimestamp | tail -20
注意:节点恢复 Ready 后,原本运行在该节点上的 Pod 不会自动重新调度回来,除非它们被驱逐或删除。若需要验证重新调度能力,可以手动删除一个由 Deployment 管理的 Pod,观察新 Pod 是否被调度到恢复后的节点。
快速检查清单
| 检查项 | 命令 | 正常表现 | 异常处理 |
|---|---|---|---|
| 节点状态 | kubectl get nodes | Ready | 查看 Conditions 定位原因 |
| kubelet | systemctl status kubelet | active (running) | 查日志修正配置后重启 |
| 容器运行时 | crictl info | 返回运行时信息 | 重启 containerd |
| CNI Pod | kubectl get pods -n kube-system | Running | 查看 CNI Pod 日志 |
| 磁盘 | df -h /var/lib/kubelet | 使用率 < 85% | 清理镜像与日志 |
| 内存 | free -m | 可用内存充足 | 排查 OOM 进程 |