3. 集群 DNS 解析超时的稳定性加固
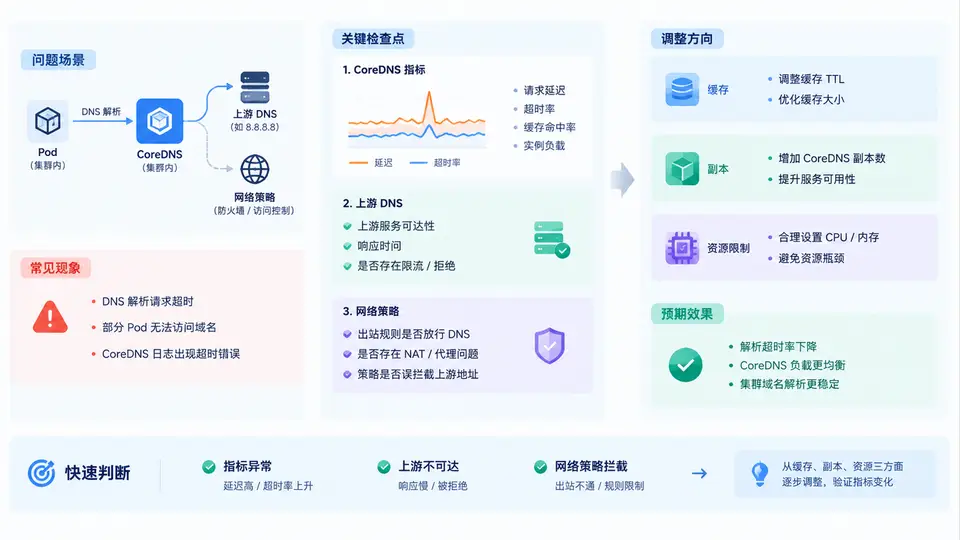
CoreDNS 解析超时的稳定性加固
CoreDNS 解析超时通常不是单一原因,而是缓存命中率、副本数、资源限制、上游 DNS 可达性与网络策略共同作用的结果。加固思路是:先用指标定位瓶颈,再按“缓存 → 副本 → 资源 → 上游/网络策略”的顺序逐层调整,每步调整后验证解析成功率与 P99 延迟。
指标定位与判断依据
在 CoreDNS Pod 中暴露的指标端点为 :9153/metrics。通过以下命令快速抓取关键指标:
# 进入 CoreDNS Pod 或通过 Service 访问指标
kubectl -n kube-system port-forward svc/kube-dns 9153:9153

# 抓取关键指标
curl -s http://127.0.0.1:9153/metrics | grep -E \
'coredns_dns_requests_total|coredns_dns_responses_total|coredns_cache_hits_total|coredns_cache_misses_total|coredns_forward_healthcheck_failures_total|container_cpu_cfs_throttled'| 指标 | 异常表现 | 指向问题 | 对应措施 |
|---|---|---|---|
| coredns_cache_hits_total / (hits+misses) | 命中率 < 60% | 缓存 TTL 过短或 prefetch 未开 | ① 缓存调优 |
| coredns_dns_requests_total | QPS 突增且单副本承压 | 副本数不足 | ② 副本扩容 |
| container_cpu_cfs_throttled_seconds_total | 持续增长 | CPU limit 过低 | ③ 资源限制调整 |
| coredns_forward_healthcheck_failures_total | > 0 且增长 | 上游 DNS 不可达或网络策略阻断 | ④ 上游与网络策略 |
| coredns_dns_responses_total{rcode="SERVFAIL"} | 占比升高 | 上游超时或转发失败 | ④ 上游与网络策略 |
CoreDNS ConfigMap 加固配置
以下 Corefile 在默认配置基础上调整了缓存 TTL、开启 prefetch,并显式设置 forward 超时与健康检查:
apiVersion: v1
kind: ConfigMap
metadata:
  name: coredns
  namespace: kube-system
data:
  Corefile: |
    .:53 {
        errors
        health {
            lameduck 5s
        }
        ready
        kubernetes cluster.local in-addr.arpa ip6.arpa {
            pods insecure
            fallthrough in-addr.arpa ip6.arpa
            ttl 30
        }
        prometheus :9153
        forward . /etc/resolv.conf {
            max_concurrent 1000
            policy random
            health_check 5s
        }
        cache 60 {
            success 9984 60
            denial 9984 30
            prefetch 10 60s 20%
        }
        loop
        reload
        loadbalance
    }
缓存参数说明:
cache 60 表示基础 TTL 为 60 秒;prefetch 10 60s 20% 表示当某域名在 60 秒内被请求超过 10 次且剩余 TTL 低于 20% 时,提前异步刷新,避免缓存过期瞬间的同步回源尖峰。
副本与资源限制调整
# 调整 CoreDNS Deployment 副本数与资源
kubectl -n kube-system patch deployment coredns --type='json' -p='[
  {"op":"replace","path":"/spec/replicas","value":4},
  {"op":"replace","path":"/spec/template/spec/containers/0/resources/limits/cpu","value":"500m"},
  {"op":"replace","path":"/spec/template/spec/containers/0/resources/limits/memory","value":"256Mi"},
  {"op":"replace","path":"/spec/template/spec/containers/0/resources/requests/cpu","value":"100m"},
  {"op":"replace","path":"/spec/template/spec/containers/0/resources/requests/memory","value":"128Mi"}
]'
同时建议为 CoreDNS 添加反亲和性,避免所有副本集中在同一节点:
affinity:
  podAntiAffinity:
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 100
      podAffinityTerm:
        labelSelector:
          matchLabels:
            k8s-app: kube-dns
        topologyKey: kubernetes.io/hostname
上游 DNS 与网络策略检查
CoreDNS 的上游由节点 /etc/resolv.conf 决定。若上游 DNS 不可达,forward 健康检查会失败并触发 SERVFAIL。检查步骤:
- 确认节点 resolv.conf 中的上游地址:
cat /etc/resolv.conf,记录 nameserver 列表。 - 从 CoreDNS Pod 内测试上游可达性:
kubectl -n kube-system exec -it <coredns-pod> -- nslookup kubernetes.default 10.x.x.x。 - 若集群启用了 NetworkPolicy,需确保 CoreDNS 可出站到上游 53/UDP 和 53/TCP:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-coredns-egress
  namespace: kube-system
spec:
  podSelector:
    matchLabels:
      k8s-app: kube-dns
  policyTypes:
  - Egress
  egress:
  - to:
    - ipBlock:
        cidr: 10.0.0.0/8
    ports:
    - protocol: UDP
      port: 53
    - protocol: TCP
      port: 53
  - to:
    - namespaceSelector: {}
    ports:
    - protocol: UDP
      port: 53
    - protocol: TCP
      port: 53
验证与结果判读
调整完成后,通过以下方式验证加固效果:
# 1. 观察 CoreDNS Pod 状态与副本数
kubectl -n kube-system get pods -l k8s-app=kube-dns -o wide

# 2. 持续抓取指标,观察 SERVFAIL 与缓存命中率变化
watch -n 5 'curl -s http://127.0.0.1:9153/metrics | grep -E "coredns_dns_responses_total|coredns_cache_hits_total"'

# 3. 从业务 Pod 内做解析压测
kubectl run dns-test --image=busybox:1.36 --rm -it --restart=Never -- \
sh -c 'for i in $(seq 1 200); do nslookup kubernetes.default >/dev/null 2>&1 || echo "FAIL $i"; done; echo done'| 观察项 | 加固前典型表现 | 加固后预期 |
|---|---|---|
| 解析成功率 | 存在间歇性超时 | 200 次压测无 FAIL |
| SERVFAIL 计数 | 持续增长 | 趋于稳定或归零 |
| 缓存命中率 | < 60% | > 80% |
| CPU throttling | 持续增长 | 增长显著放缓或停止 |
| P99 解析延迟 | 波动大,偶发 > 5s | 稳定在 100ms 以内 |
注意: 调整副本数与资源限制后,需确认节点资源充足,避免 CoreDNS Pod 因资源不足被驱逐。若上游 DNS 本身不稳定,仅调整 CoreDNS 参数无法根治,需同步排查上游 DNS 服务或考虑部署本地缓存 DNS 作为二级缓存。