4. OCR基本概念
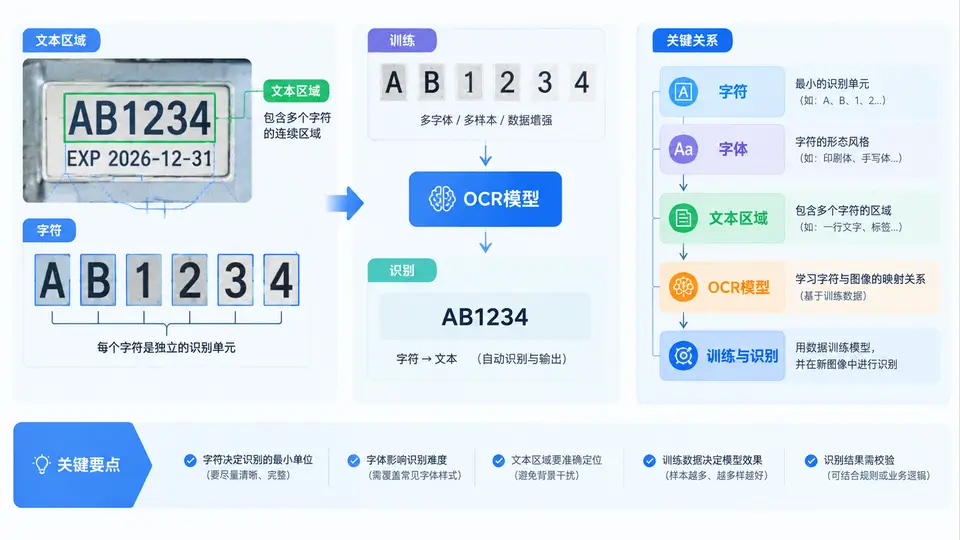
在进入Halcon的OCR工具链之前,我们必须先厘清一组基础但极易混淆的概念。很多初学者直接跳到read_ocr_trainf或do_ocr_multi_class_svm函数,却对“字符”与“字体”、“文本区域”与“ROI”、“训练”与“识别”之间的关系缺乏结构化认知,导致后续调参时无从下手。本章将围绕五个核心概念展开,并重点剖析它们之间的依赖链条。
4.1 字符与字体:从像素到语义的最小单元
字符(Character)是OCR系统处理的最小语义单元。在Halcon中,一个字符通常被表示为一个区域(Region)或一个灰度图像块。字符可以是数字、字母、符号,甚至是由多个连通域组成的复杂字形(如汉字“国”的内部与外部轮廓分离)。
字体(Font)则是一组具有统一视觉风格的字符集合。字体决定了字符的笔画粗细、衬线有无、宽高比例等几何属性。在Halcon的OCR体系中,字体并非指操作系统中的TTF文件,而是指训练样本的集合——即一组带有标注信息的字符图像。例如,Industrial_0-9_NoRej是Halcon预置的工业数字字体,而Universal_0-9_NoRej则覆盖更广泛的数字书写风格。
理解字体概念的关键在于:OCR模型本质上是对特定字体的统计描述。如果待识别图像中的字符风格与训练字体差异过大(如将衬线字体图像输入给基于无衬线字体训练的模型),识别率会急剧下降。因此,在实际项目中,我们往往需要针对现场字体采集样本并重新训练,而非盲目使用预置字体。
write_ocr_trainf将当前样本追加到现有字体文件中,实现增量训练。
4.2 文本区域:从图像到候选区域的定位
文本区域(Text Region)是指图像中可能包含字符的矩形或任意形状区域。它不等同于“文本行”——一个文本区域可以包含单个字符、一个单词、一行文字,甚至是一段文字。在Halcon的典型流程中,文本区域通常由find_text算子自动生成,或由reduce_domain配合手动ROI指定。
文本区域的质量直接影响后续识别效果。常见问题包括:
- 区域过紧:字符笔画被截断,导致特征提取不完整;
- 区域过松:包含背景噪声或相邻字符,干扰分类器决策;
- 倾斜文本:未做旋转校正,字符特征发生畸变。
Halcon提供了text_line_orientation和find_text的Orientation参数来处理倾斜问题。对于严重透视畸变的场景,还需要先进行hom_vector_to_proj_hom_mat2d矫正。
4.3 OCR模型:特征空间中的决策边界
OCR模型(OCR Model)是训练阶段产出的分类器参数集合。Halcon支持多种模型类型,包括:
| 模型类型 | 核心原理 | 适用场景 | 训练速度 |
|---|---|---|---|
| MLP(多层感知机) | 基于灰度值特征的全连接神经网络 | 印刷体、字体单一 | 快 |
| SVM(支持向量机) | 基于形状特征的最大间隔分类 | 工业字符、噪声较多 | 中 |
| CNN(卷积神经网络) | 自动提取层次化视觉特征 | 复杂背景、多字体混合 | 慢(需GPU) |
模型文件以.omc格式存储,包含特征提取参数、分类器权重、类别标签列表等。在Halcon中,通过create_ocr_class_mlp或create_ocr_class_svm创建模型句柄,训练完成后用write_ocr_class_mlp持久化。
需要特别强调的是:模型与字体文件是分离的。字体文件(.trf)存储训练样本的原始图像和标签,而模型文件存储学习到的参数。这意味着你可以用同一批样本训练不同结构的模型,也可以在不同阶段向字体文件中追加新样本后重新训练。
4.4 训练与识别的关系:先有样本,后有模型,再有预测
训练与识别不是并列关系,而是严格的先后依赖关系。整个流程可以概括为以下五个阶段:
- 样本采集:从实际生产图像中裁剪字符图像,确保覆盖所有类别和常见变形;
- 样本标注:为每个字符图像指定正确的类别标签(如“0”-“9”或“A”-“Z”);
- 特征提取与训练:Halcon自动从样本中提取特征(如梯度直方图、形状描述子),并优化分类器参数;
- 模型评估:使用独立的测试集计算混淆矩阵和识别率;
- 在线识别:加载模型,对新的文本区域执行
do_ocr_multi_class_svm等算子,输出字符类别和置信度。
下面是一个典型的训练与识别代码骨架:
* 训练阶段
read_image (TrainImage, 'train_sample.png')
threshold (TrainImage, Region, 0, 128)
connection (Region, ConnectedRegions)
sort_region (ConnectedRegions, SortedRegions, 'character', 'true', 'row')
create_ocr_class_svm (8, 10, 'constant', 'default', 'rbf', 0.01, 'one-versus-one', 'normalization', 10, OCRHandle)
trainf_ocr_class_svm (OCRHandle, SortedRegions, TrainImage, '0123456789', 'train_font.trf')
write_ocr_class_svm (OCRHandle, 'my_model.omc')

* 识别阶段
read_ocr_class_svm ('my_model.omc', OCRHandle)
read_image (TestImage, 'test_sample.png')
find_text (TestImage, TextModel, TextRegions, TextResultID)
get_text_object (TextRegions, TextResultID, 'all_lines', TextLines)
do_ocr_multi_class_svm (TextLines, TestImage, OCRHandle, Class, Confidence)trainf_ocr_class_svm内部会进行交叉验证,但外部独立测试仍然必不可少。
4.5 案例:药瓶生产日期识别中的概念落地
我们以一个药瓶喷码识别项目为例,说明上述概念如何串联。药瓶底部喷印的“2025-08-15”为激光蚀刻数字,字体为等线体,背景为玻璃反光噪声。
第一步:字体分析。采集100瓶样本,每瓶裁剪出10个数字字符,共1000个样本。观察发现数字“1”存在两种宽度变体,“0”存在内部污渍干扰。此时预置字体Industrial_0-9_NoRej无法覆盖这些变体,因此需要创建自定义字体Pharma_Date_NoRej。
第二步:文本区域定位。由于喷码位置固定,使用reduce_domain限定一个矩形ROI,再通过threshold结合connection分离出每个字符区域。注意,玻璃反光导致部分字符断裂,需要先执行closing_circle形态学操作合并断裂笔画。
第三步:模型训练与验证。将800个样本用于训练SVM模型,200个样本用于测试。首次训练后识别率为94.3%,混淆矩阵显示“8”与“3”存在混淆。分析原因是两者在低分辨率下形状相似。解决方案是增加“8”的样本量,并开启preprocessing参数中的'character_height'归一化。
第四步:在线识别。将模型部署到产线,每瓶检测耗时约15ms。实际运行中遇到新问题:部分药瓶的喷码被标签遮挡,导致文本区域不完整。此时通过find_text的Minimum_Size参数过滤过小区域,并设置Return_Text_Components为'character'以获取单字符级结果,便于后续质量追溯。
4.6 误区与复盘:五个高频认知偏差
在多年教学与项目实践中,我总结了以下五个高频误区,它们往往导致项目延期或识别率不达标:
- 误区一:认为预置字体“开箱即用”。Halcon的预置字体是在理想条件下训练的,实际工业场景中的光照、噪声、形变都会降低其表现。正确做法是始终基于现场样本重新训练。
- 误区二:混淆“文本区域”与“字符区域”。文本区域是输入给
find_text的搜索范围,字符区域是connection后的单个连通域。若直接对文本区域执行OCR,分类器会因输入尺寸不一致而报错或误判。 - 误区三:忽视字符分割质量。OCR模型的输入是字符图像,如果分割阶段将两个字符粘连在一起,再好的模型也无法正确识别。应优先优化分割逻辑,而非盲目更换模型结构。
- 误区四:训练样本数量不足。对于SVM模型,每个类别至少需要50个样本;对于CNN模型,建议每类不少于200个。样本不足时,模型会记住噪声而非泛化特征。
- 误区五:忽略置信度阈值。
do_ocr_multi_class_svm返回的置信度是0到1之间的浮点数。实际项目中应设置阈值(如0.7),低于阈值的识别结果标记为“拒识”,而非强行输出错误类别。