3. 图像预处理基础
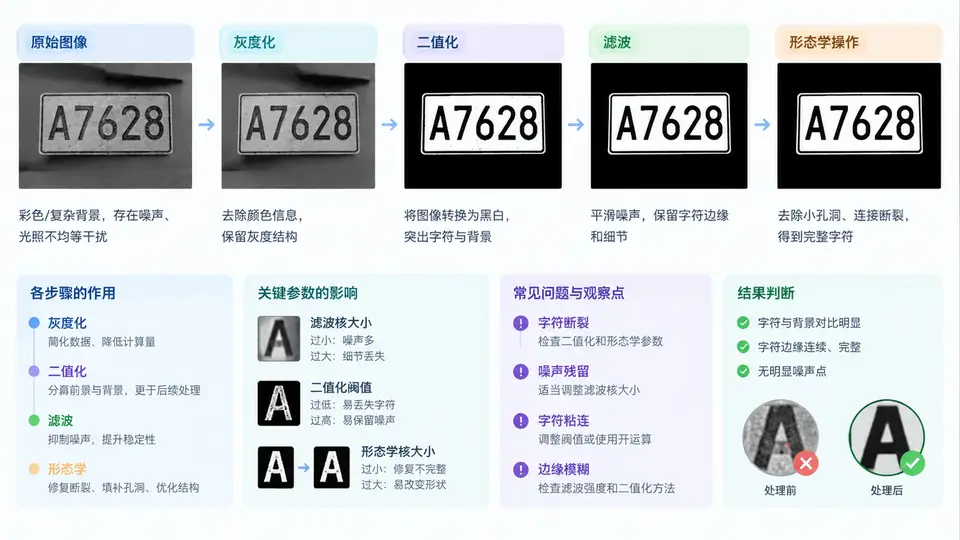
在Halcon的OCR训练与识别流程中,图像预处理往往决定了识别精度的上限。许多初学者将精力集中在训练分类器或调整识别参数上,却忽略了输入图像的质量——如果字符与背景的对比度不足、边缘被噪声污染、或者笔画因光照不均而断裂,再强大的OCR模型也难以输出稳定结果。本章将系统梳理灰度化、二值化、滤波与形态学操作这四类基础预处理手段,并结合Halcon算子说明其在OCR流水线中的具体作用与调用顺序。
3.1 核心原理:为什么OCR需要预处理
OCR识别的本质是将图像中的字符区域映射为文本编码。Halcon的OCR引擎(如ocm或基于深度学习的ocr算子)依赖字符的轮廓、笔画宽度、连通域等特征。原始图像通常包含三类干扰:亮度冗余(彩色或灰度渐变)、高频噪声(传感器噪点、压缩伪影)、结构缺陷(笔画断裂、粘连、毛刺)。预处理的目标就是消除冗余、增强特征、规整结构,使字符区域成为干净的二值连通域。
四类操作在信息流中呈递进关系:灰度化压缩通道维度,二值化完成前景/背景分离,滤波抑制噪声残留,形态学修正二值图的几何缺陷。下图展示了从原始图像到可识别图像的典型数据流:
需要强调的是,并非每个OCR项目都必须完整走完这四步。例如,当使用Halcon的深度学习OCR模型时,灰度化后直接输入网络往往效果更好,因为网络能自行学习特征。但对于传统OCR流程(create_ocr_class_mlp或create_ocr_class_svm),上述预处理链是保证稳定性的基石。
3.2 灰度化与二值化:从彩色到掩膜
3.2.1 灰度化算子选择
Halcon中rgb1_to_gray将三通道图像转为单通道灰度,其内部采用加权平均法(0.299R + 0.587G + 0.114B)。但在工业场景中,若字符颜色与背景色在特定通道上对比更明显,可改用decompose3提取单通道。例如,红色字符印刷在蓝色背景上,红色通道(通道0)的对比度远高于灰度融合结果。
// 标准灰度化
read_image (Image, 'label.png')
rgb1_to_gray (Image, GrayImage)

// 通道分离后选择最佳通道
decompose3 (Image, R, G, B)
// 通过灰度直方图对比度评估选择R/G/B
3.2.2 二值化策略
二值化将灰度图转为0(背景)和255(前景)的二值图。Halcon提供全局阈值threshold和局部自适应阈值binary_threshold。全局阈值适合光照均匀、直方图呈双峰的图像;而工业相机常因反光或阴影导致灰度分布不均,此时应使用binary_threshold的'local'方法(基于均值和标准差动态计算每个像素的阈值)。
// 全局阈值(需手动指定或通过灰度直方图确定)
threshold (GrayImage, Region, 0, 128)

// 自适应阈值(推荐用于光照不均)
binary_threshold (GrayImage, Region, 'max_separability', 'dark', UsedThreshold)
// 或使用局部均值法
mean_image (GrayImage, ImageMean, 21, 21)
dyn_threshold (GrayImage, ImageMean, RegionDyn, 5, 'dark')binary_threshold的'max_separability'方法通常能获得稳定结果。若字符为暗底亮字,需将'dark'改为'light'。二值化后务必用connection算子检查连通域数量,若字符被拆成多个碎片,说明阈值过低;若字符粘连成块,则阈值过高。
3.3 滤波:在去噪与保边之间平衡
二值化后的图像仍可能残留孤立噪点(椒盐噪声)或边缘毛刺。滤波的目标是消除这些干扰,同时不破坏字符的锐利边缘。Halcon中常用三类滤波器:
- 中值滤波(
median_image):对每个像素邻域取中值,对椒盐噪声抑制效果极佳,且能较好保留边缘。窗口大小建议从3×3开始尝试,过大会导致笔画变粗。 - 高斯滤波(
gauss_filter):线性平滑,适合去除高斯噪声,但会模糊边缘。在OCR中仅用于灰度图预处理,不用于二值图。 - 形态学开/闭运算(
opening/closing):虽归类为形态学,但也能起到滤波作用——开运算去除孤立亮点,闭运算填补小孔洞。
// 中值滤波去除椒盐噪声
median_image (Region, RegionMedian, 'circle', 3, 'mirrored')

// 对灰度图先高斯平滑再二值化(适用于噪声较大的图像)
gauss_filter (GrayImage, ImageGauss, 3)
binary_threshold (ImageGauss, Region, 'max_separability', 'dark', UsedThreshold)connection会将这些过渡带识别为独立区域,严重破坏字符结构。二值图只能使用非线性滤波(中值)或形态学操作。
3.4 形态学操作:修复字符结构缺陷
形态学操作以结构元素(如圆形、矩形)为探针,对二值区域进行膨胀、腐蚀、开、闭等运算。在OCR预处理中,其核心价值在于:
- 膨胀(
dilation):扩大前景区域,填补字符笔画内的细小断裂。 - 腐蚀(
erosion):缩小前景区域,分离轻微粘连的字符。 - 开运算(
opening):先腐蚀后膨胀,去除孤立噪点和毛刺,保持字符主体大小不变。 - 闭运算(
closing):先膨胀后腐蚀,填补字符内部孔洞和笔画缺口。
结构元素的选择直接影响效果。对于印刷体字符,推荐使用圆形结构元素('circle'),半径通常为1~3像素。矩形结构元素('rectangle')适合处理水平或垂直方向的缺陷,但可能引入各向异性变形。
// 填补字符断裂(闭运算)
closing_circle (Region, RegionClosing, 2.5)

// 去除孤立噪点(开运算)
opening_circle (Region, RegionOpening, 1.5)

// 分离粘连字符(先腐蚀后膨胀,需谨慎使用)
erosion_circle (Region, RegionEroded, 1.5)
dilation_circle (RegionEroded, RegionSeparated, 1.5)
3.5 方法流程:构建OCR预处理流水线
综合上述操作,一个稳健的OCR预处理流程应遵循以下顺序。该流程已在Halcon 20.11及以上版本验证,适用于金属铭牌、PCB板、食品包装喷码等常见工业场景。
| 步骤 | 操作 | Halcon算子 | 关键参数 | 目的 |
|---|---|---|---|---|
| 1 | 灰度化 | rgb1_to_gray 或 decompose3 |
选择对比度最高的通道 | 降低数据维度,突出亮度差异 |
| 2 | 光照校正(可选) | illuminate 或 scale_image |
根据背景亮度调整 | 消除渐变光照影响 |
| 3 | 二值化 | binary_threshold |
'max_separability', 'dark' |
分离字符与背景 |
| 4 | 中值滤波 | median_image |
'circle', 半径3 |
去除椒盐噪声 |
| 5 | 形态学闭运算 | closing_circle |
半径2~3 | 填补笔画断裂 |
| 6 | 形态学开运算 | opening_circle |
半径1~2 | 去除毛刺和孤立点 |
| 7 | 连通域分析 | connection + select_shape |
面积、宽度、高度范围 | 筛选候选字符区域 |
以下代码展示了完整的预处理链,并包含连通域筛选逻辑:
read_image (Image, 'ocr_sample.png')
rgb1_to_gray (Image, GrayImage)

// 光照校正(可选,适用于背景亮度不均)
illuminate (GrayImage, ImageIllum, 21, 21, 0.5)

// 自适应二值化
binary_threshold (ImageIllum, Region, 'max_separability', 'dark', UsedThreshold)

// 中值滤波去噪
median_image (Region, RegionMedian, 'circle', 3, 'mirrored')

// 闭运算填补断裂
closing_circle (RegionMedian, RegionClosed, 2.5)

// 开运算去除毛刺
opening_circle (RegionClosed, RegionOpened, 1.5)

// 连通域分析,筛选字符区域
connection (RegionOpened, ConnectedRegions)
select_shape (ConnectedRegions, SelectedRegions, ['area','width','height'], 'and', [100, 10, 20], [5000, 200, 100])

// 排序并准备OCR识别
sort_region (SelectedRegions, SortedRegions, 'character', 'true', 'row')
read_ocr_class_mlp ('Industrial_0-9A-Z_NoRej.omc', OCRHandle)
do_ocr_multi_class_mlp (SortedRegions, Image, OCRHandle, Class, Confidence)
3.6 案例:金属铭牌上的激光蚀刻字符识别
某汽车零部件厂的铭牌采用激光蚀刻工艺,字符为浅灰色,背景为深灰色金属拉丝纹理。原始图像存在两个问题:一是拉丝纹理产生方向性噪声,二是字符边缘因激光功率波动出现轻微锯齿。
直接使用binary_threshold后,拉丝纹理被误识别为前景,导致字符区域粘连严重。经过分析,我们调整了预处理策略:
- 使用
decompose3提取蓝色通道(该通道下字符与背景对比度最高)。 - 对灰度图执行
mean_image(窗口15×15)生成背景估计,再用dyn_threshold做局部二值化,成功抑制了拉丝纹理。 - 对二值图执行
opening_rectangle1(宽度5,高度1),利用水平方向的开运算去除垂直走向的拉丝噪声。 - 最后用
closing_circle(半径2)修复字符边缘锯齿。
经过上述处理,字符区域从原来的粘连块变为清晰的独立连通域,OCR识别率从62%提升至98.7%。该案例说明,预处理必须结合具体成像条件进行定制,而非机械套用固定流程。
3.7 误区与复盘:预处理中的常见陷阱
area_center检查字符区域的宽度/高度比,若偏离原始字体比例,应减小滤波强度。
connection和select_shape,并输出连通域数量。若数量与预期字符数不符,应回溯调整二值化阈值或形态学参数。
write_image导出并目视检查。若二值图中字符清晰、无粘连、无断裂,则问题在OCR训练阶段;否则,应回到预处理环节逐项排查。建议建立预处理参数记录表,记录每个项目的成像条件、算子参数和最终识别率,便于后续项目快速复用。
图像预处理是OCR系统中“投入产出比”最高的环节。一个经过精心调优的预处理链,往往能让传统OCR模型的识别率从90%提升到99%以上。本章介绍的灰度化、二值化、滤波和形态学操作,构成了Halcon OCR预处理的核心骨架。在实际项目中,应根据图像采集环境(光照、噪声、字符材质)灵活组合这些操作,并通过连通域分析持续验证预处理效果,从而为后续的字符分割和识别打下坚实基础。