1. 课程导入
一、学习目标:从“能跑通”到“能交付”
本课程面向机器视觉工程师、自动化设备调试人员以及希望深入理解OCR工程化的开发者。学完本章及后续全部30章内容后,你应当具备以下四项核心能力:
- 掌握Halcon OCR的完整技术栈:从图像采集、预处理、字符分割、特征提取到识别输出的全链路实现,能够独立编写可运行的Halcon脚本。
- 具备模型训练与优化能力:理解OCR分类器(MLP、SVM、CNN)的原理差异,能够针对特定字体、材质、光照条件训练专用模型,并完成模型评估与迭代。
- 解决实际工程问题:面对反光、倾斜、残缺、字符粘连等复杂工况,能够运用图像预处理、形态学操作、透视矫正等手段提升识别鲁棒性。
- 掌握系统集成与部署方法:了解Halcon与C++/C#/Python的接口调用方式,能够将OCR功能封装为可复用的库或服务,并处理多线程、内存管理及异常恢复等工程问题。
课程定位说明:本课程不是简单的“点按钮”教学,而是围绕“训练-识别-优化-部署”四大环节展开。每一章都会提供可运行的代码示例、参数调优建议以及常见故障排查清单。建议学习时准备一台装有Halcon 20.11及以上版本的电脑,并配备至少一个工业相机(或使用Halcon自带的示例图像)进行同步练习。
二、课程大纲:30章知识体系全景图
整个课程分为六个阶段,从基础操作逐步过渡到高级工程实践。下表列出了各阶段的核心章节与关键知识点:
| 阶段 | 章节范围 | 核心内容 |
|---|---|---|
| 第一阶段:基础入门 | 第1-5章 | Halcon环境配置、图像采集与显示、OCR基本流程、字符区域定位、图像预处理基础 |
| 第二阶段:核心算法 | 第6-12章 | 字符分割算法(Blob分析、投影法)、特征提取(形状、灰度、梯度)、OCR分类器原理与选择 |
| 第三阶段:模型训练 | 第13-18章 | 训练样本制作、标注工具使用、MLP/SVM/CNN模型训练、模型评估与参数调优、过拟合抑制 |
| 第四阶段:高级技术 | 第19-24章 | 畸变矫正、透视变换、多行文本识别、字符粘连与断裂处理、工业场景光照补偿、3D OCR简介 |
| 第五阶段:工程化 | 第25-28章 | Halcon与C++/C#/Python混合编程、多线程加速、内存优化、异常处理与日志记录 |
| 第六阶段:实战项目 | 第29-30章 | 完整项目实战(如PCB板字符识别、药品包装日期喷码识别)、性能调优与验收标准 |
三、Halcon OCR整体流程:从图像到文本的六步法
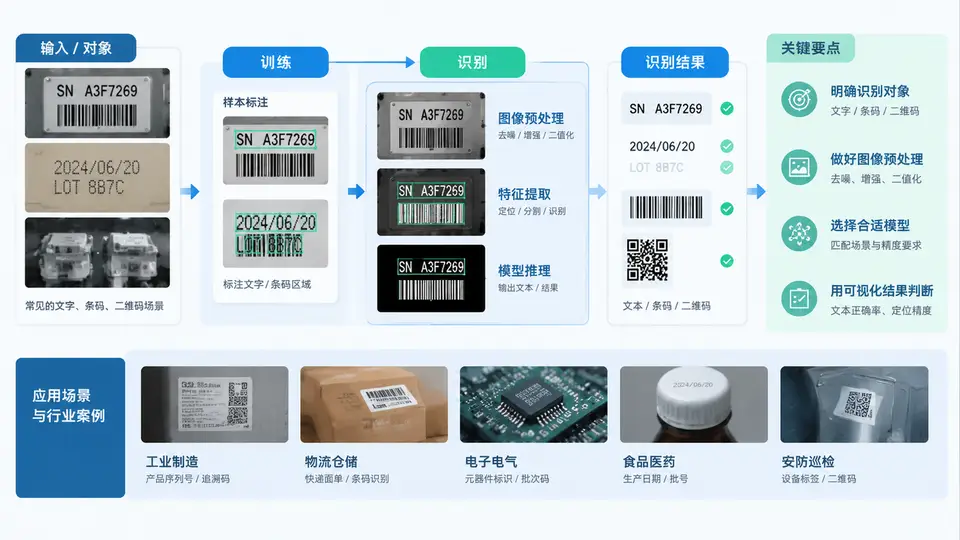
Halcon OCR系统的标准处理流程可以归纳为以下六个关键步骤。理解这个流程是后续所有章节的基础,也是排查问题时的思维框架。
- 图像获取:通过相机接口(GigE Vision、USB3 Vision、Camera Link)或读取本地图像文件,获取包含待识别字符的原始图像。此阶段需要关注分辨率、帧率、曝光时间等参数。
- 图像预处理:对原始图像进行灰度化、降噪(高斯滤波、中值滤波)、对比度增强(直方图均衡化)、二值化(全局阈值、局部自适应阈值)等操作,使字符区域与背景分离更加清晰。
- 字符区域定位:使用Blob分析、形态学操作或基于深度学习的区域检测方法,从预处理后的图像中提取出包含字符的最小外接矩形区域。这一步决定了后续识别的准确性。
- 字符分割:将定位到的字符区域进一步拆分为单个字符图像。常用方法包括投影法(水平/垂直投影)、连通域分析、基于间距的聚类等。对于粘连字符,可能需要结合形态学腐蚀或分水岭算法。
- 特征提取与识别:对每个分割后的字符图像提取特征向量(如梯度直方图、Zernike矩、灰度共生矩阵),然后输入到训练好的OCR分类器中进行分类。Halcon提供了
do_ocr_multi_class_mlp、do_ocr_multi_class_svm、do_ocr_multi_class_cnn等核心算子。 - 后处理与输出:对识别结果进行置信度过滤、字典校验(如产品型号白名单)、格式修正(如去除空格、统一大小写),最终输出结构化文本数据。
// Halcon OCR核心流程示例(伪代码)
read_image (Image, 'product_01.png')
// 1. 预处理
rgb1_to_gray (Image, GrayImage)
median_image (GrayImage, ImageMedian, 3, 'circle')
// 2. 二值化
threshold (ImageMedian, Region, 0, 128)
connection (Region, ConnectedRegions)
select_shape (ConnectedRegions, TextRegions, 'area', 'and', 500, 99999)
// 3. 字符区域定位
union1 (TextRegions, TextRegionUnion)
smallest_rectangle2 (TextRegionUnion, Row, Column, Phi, Length1, Length2)
// 4. 分割与识别(使用预训练模型)
read_ocr_class_mlp ('Industrial_0-9A-Z_NoRej.omc', OCRHandle)
do_ocr_multi_class_mlp (TextRegions, ImageMedian, OCRHandle, Class, Confidence)
// 5. 输出结果
disp_message (WindowHandle, Class, 'window', 12, 12, 'black', 'white')学习建议:不要急于运行复杂代码。建议先使用Halcon自带的HDevelop示例程序(如ocr_mlp.hdev)逐步执行,观察每一步的中间结果(区域、图像、特征),理解每个算子的输入输出关系。这比直接编写完整脚本更有利于建立直觉。
四、应用场景与行业案例
OCR技术在工业自动化领域应用极为广泛,其核心价值在于将“不可编辑”的物理字符转化为“可处理”的数字信息。以下是四个典型应用场景及其技术要点:
4.1 电子制造:PCB板字符识别
在PCB生产线上,需要识别板面上的丝印字符(如型号、版本号、生产批次)。难点在于:字符可能被元器件遮挡、铜箔反光导致对比度低、板面颜色多样。解决方案是采用多光谱光源(如红色环形光+蓝色同轴光)配合频域滤波增强字符边缘,并使用局部自适应阈值处理光照不均。
4.2 医药行业:药品包装日期喷码识别
药盒上的生产日期和有效期通常采用喷墨打印,存在字符断裂、墨迹浓淡不一、背景图案干扰等问题。工程上常采用形态学闭运算连接断裂笔画,结合OCR字典约束(限定日期格式为YYYY-MM-DD)提高识别准确率。此外,由于药盒材质多为反光纸盒,需要采用偏振滤镜消除反光。
4.3 汽车零部件:发动机缸体VIN码识别
VIN码(车辆识别代码)通常为17位字符,直接激光雕刻在金属表面,存在低对比度、背景纹理复杂、字符深度不一等问题。推荐使用3D激光轮廓仪获取深度图像,或使用光度立体法重建表面法向信息,从而增强字符与背景的差异。Halcon的xyz_to_object_model_3d算子可用于处理此类数据。
4.4 物流行业:快递面单信息识别
快递面单包含手写体、印刷体、条形码等多种信息,且纸张可能褶皱、倾斜。处理流程通常为:先通过find_surface_model或特征点匹配定位面单区域,再进行透视矫正,最后分别对手写数字(使用CNN模型)和印刷体(使用MLP模型)进行识别。
常见误区警示:
- 误区一:盲目追求高识别率而忽视鲁棒性。在实验室环境下达到99%的准确率并不困难,但现场环境(振动、灰尘、温度变化)会导致图像质量波动。建议在训练阶段就加入数据增强(旋转、缩放、噪声),并在部署时设置合理的置信度阈值,低于阈值的样本应触发人工复核。
- 误区二:忽略字符分割的重要性。很多初学者将精力集中在分类器调参上,但实际工程中80%的识别错误源于分割失败(如字符粘连、断裂、背景干扰)。务必先确保分割结果稳定,再考虑优化分类器。
- 误区三:使用单一模型应对所有场景。不同字体、材质、光照条件对特征分布影响巨大。建议为每个典型工况训练专用模型,并通过
read_ocr_class_mlp动态加载不同模型,而不是试图用一个万能模型解决所有问题。
五、本章小结与学习路径建议
本章作为课程导入,明确了学习目标、展示了30章的知识体系框架、梳理了Halcon OCR的标准处理流程,并通过四个行业案例说明了技术落地的多样性。请务必在本地环境中完成Halcon的安装与授权配置,并运行第一个示例程序ocr_mlp.hdev,观察从图像读取到字符输出的完整过程。
在进入下一章之前,建议完成以下自测:
- 能否用自己的语言描述OCR六步流程中每一步的目的?
- 能否说出MLP、SVM、CNN三种分类器在OCR应用中的主要区别?
- 能否列举出三个可能导致OCR识别失败的图像质量因素?
如果以上问题都能清晰回答,说明你已经建立了正确的宏观认知,可以开始深入学习图像预处理与字符区域定位的具体技术细节。