4. 数据准备与预处理
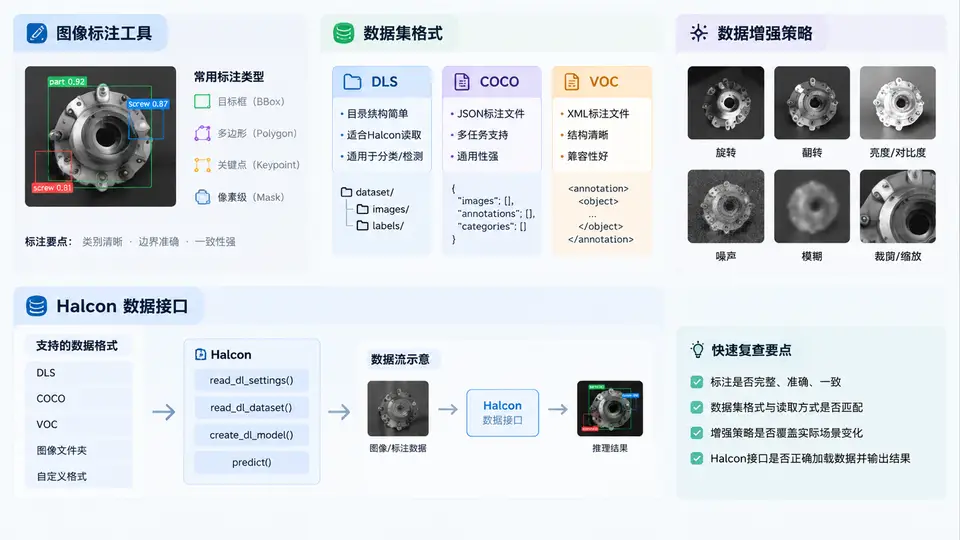
在Halcon深度学习项目的实际落地中,数据准备往往占据整个项目周期60%以上的时间。很多初学者在完成环境安装后,急于编写训练脚本,却忽略了数据这一最关键的“燃料”。本章将系统讲解图像标注工具的选择、数据集格式的转换、数据增强策略的制定,以及Halcon原生数据接口的使用方法,帮助您建立一套规范、可复用的数据流水线。
4.1 核心原理:数据质量决定模型上限
深度学习模型的性能上限由数据决定,算法只是逼近这个上限的手段。在工业视觉场景中,这一原则体现得尤为明显:一个标注精确、分布均衡的数据集,配合中等复杂度的网络,往往能超越使用顶尖网络但数据粗糙的方案。理解这一点,是建立正确数据观的前提。
Halcon深度学习训练的数据流遵循“原始图像 → 标注 → 格式转换 → 预处理 → 训练/验证/测试集划分”的路径。其中,标注信息不仅包含目标的类别和位置,还包含图像本身的元数据(如宽度、高度、通道数)。Halcon通过DLS(Deep Learning Segmentation)和DLDataset等数据结构统一管理这些信息,确保训练时数据加载的高效与一致。
核心概念:Halcon中的DLDataset是一个字典(Dictionary),它包含了image(图像路径列表)、label(标签路径或标签ID)、split('train'/'validation'/'test'划分)等键值。所有Halcon深度学习算子(如train_dl_model)都直接消费这种结构,因此理解其内部组织方式是数据接口调用的前提。
4.2 图像标注工具与数据集格式
4.2.1 主流标注工具对比
选择标注工具需考虑标注类型(矩形框、多边形、像素级分割)、团队协作需求、导出格式兼容性。以下是工业场景中常用的工具对比:
| 工具名称 | 标注类型 | 导出格式 | Halcon兼容性 | 适用场景 |
|---|---|---|---|---|
| LabelImg | 矩形框 | Pascal VOC (XML) | 需转换 | 目标检测快速起步 |
| labelme | 多边形/矩形 | JSON | 需转换 | 实例分割、语义分割 |
| CVAT | 矩形/多边形/关键点 | COCO、TFRecord | 需转换 | 团队协作、大规模标注 |
| Halcon标注助手 | 矩形/多边形/像素 | 原生DLS | 直接使用 | Halcon全流程开发 |
对于Halcon开发者,最直接的路径是使用Halcon自带的dl_dataset_support工具(通过dev_open_dl_dataset_editor打开),它允许在Halcon环境中直接标注并生成DLDataset,省去格式转换的麻烦。但若团队已有标注工具沉淀,则需掌握格式转换方法。
4.2.2 数据集格式转换:从COCO到Halcon DLS
COCO格式是目前学术界和工业界最通用的标注格式之一,其标注文件为JSON,结构如下:
{
  "images": [{"id": 1, "file_name": "img_001.jpg", "width": 640, "height": 480}],
  "annotations": [
    {"id": 1, "image_id": 1, "category_id": 2,
     "bbox": [100, 150, 200, 300], "area": 60000, "iscrowd": 0}
  ],
  "categories": [{"id": 2, "name": "bottle"}]
}
将COCO转换为Halcon DLS格式,核心是读取JSON并构建DLDataset字典。以下是一个简化的转换流程示例:
// 伪代码:COCO转Halcon DLS
read_coco_json(JsonPath, Images, Annotations)
for i := 0 to |Images| - 1 by 1
    // 读取图像路径
    ImagePath := Images[i].file_name
    // 提取该图像的所有标注框
    Bboxes := Annotations[i].bbox
    // 构建Halcon标注区域(矩形)
    gen_rectangle1(Rectangle, Bboxes[1], Bboxes[0],
                   Bboxes[1] + Bboxes[3], Bboxes[0] + Bboxes[2])
    // 将区域和标签加入DLDataset
    add_dl_dataset(DLDataset, ImagePath, Rectangle, ClassIDs)
endfor
// 设置划分比例
split_dl_dataset(DLDataset, 0.8, 0.1, 0.1)
在实际工程中,建议使用Python脚本预处理COCO JSON,生成Halcon可直接读取的中间文件(如HObject序列化或CSV索引),再通过Halcon的read_dl_dataset导入,这样能利用Python生态的JSON解析能力,同时保持Halcon侧代码简洁。
4.3 数据增强策略:从有限样本到无限多样性
数据增强是解决工业场景样本不足、环境多变问题的关键手段。Halcon提供了apply_dl_data_augmentation算子,支持多种增强方式,但需注意增强操作必须与标注同步变换,否则会导致标签错位。
4.3.1 几何增强与像素增强
- 几何增强:随机旋转(±15°)、水平/垂直翻转、随机缩放(0.8~1.2倍)、平移裁剪。这些操作改变图像空间结构,适用于目标位置不固定的场景。
- 像素增强:亮度/对比度调整、高斯噪声添加、模糊模拟。这些操作模拟光照变化和传感器噪声,增强模型鲁棒性。
- 组合增强:Halcon允许通过
set_dl_data_augmentation设置增强参数列表,按概率组合多种操作。
以下是一个Halcon数据增强配置示例:
// 设置增强参数
AugmentationParams := dict{}
set_dict_tuple(AugmentationParams, 'rotation', [-10, 10])  // 旋转范围
set_dict_tuple(AugmentationParams, 'scale', [0.9, 1.1])    // 缩放范围
set_dict_tuple(AugmentationParams, 'flip', 'horizontal')   // 水平翻转
set_dict_tuple(AugmentationParams, 'brightness', [0.8, 1.2]) // 亮度范围

// 应用增强(在训练循环中调用)
apply_dl_data_augmentation(DLDataset, AugmentationParams, AugmentedDataset)关键误区:增强操作必须在同一随机种子下同步作用于图像和标注。例如,若图像旋转了10°,标注框也必须旋转10°。Halcon的apply_dl_data_augmentation会自动处理这种同步,但若您自定义增强流程,务必使用hom_mat2d变换同时作用于图像和区域,否则训练时损失函数将无法收敛。
4.3.2 增强策略的工程建议
在工业缺陷检测中,缺陷样本往往稀少。此时,除了常规增强,还应考虑以下策略:
- 过采样:对包含缺陷的图像重复采样,提高其在训练集中的比例。
- 合成数据:使用Halcon的
gen_circle、gen_rectangle2等算子生成模拟缺陷,叠加到正常图像上。 - 测试时增强(TTA):推理时对同一图像做多次增强,取预测平均值,可提升稳定性。
4.4 Halcon数据接口:DLDataset与预处理流水线
Halcon深度学习的数据接口围绕DLDataset和Preprocessing两个核心组件展开。理解它们的关系是高效使用Halcon的前提。
4.4.1 DLDataset的构建与划分
构建DLDataset有两种途径:一是通过标注工具直接生成,二是通过代码从外部数据构建。无论哪种方式,最终都需要调用split_dl_dataset进行数据划分。该算子支持按比例或按指定数量划分训练、验证、测试集,并保证类别分布均衡。
// 从文件夹构建数据集(假设图像和标签按固定命名规则存放)
read_dl_dataset(ImageDir, LabelDir, DLDataset)
// 查看数据集统计信息
get_dl_dataset_info(DLDataset, InfoDict)
// 划分数据集
split_dl_dataset(DLDataset, 0.7, 0.2, 0.1)
4.4.2 预处理:从原始图像到网络输入
Halcon要求输入网络的图像具有固定尺寸(如512×512)和特定通道顺序(通常为RGB)。预处理算子preprocess_dl_dataset负责完成以下任务:
- 缩放:将图像缩放到网络输入尺寸,保持宽高比或直接拉伸。
- 归一化:将像素值从[0,255]映射到[0,1]或[-1,1]。
- 通道转换:将灰度图转换为三通道,或调整通道顺序。
- 生成批次:将多张图像堆叠为四维张量(Batch, Height, Width, Channels)。
// 设置预处理参数
PreprocessParams := dict{}
set_dict_tuple(PreprocessParams, 'image_width', 512)
set_dict_tuple(PreprocessParams, 'image_height', 512)
set_dict_tuple(PreprocessParams, 'image_num_channels', 3)
set_dict_tuple(PreprocessParams, 'image_range', [0, 1])

// 执行预处理
preprocess_dl_dataset(DLDataset, PreprocessParams, PreprocessedDataset)实战提示:预处理参数必须与训练时的网络输入一致。若您在训练时使用了set_dl_model_param设置了输入尺寸,则预处理阶段必须使用相同尺寸,否则会报维度不匹配错误。建议将预处理参数保存为字典,在训练和推理阶段复用,避免不一致。
4.5 案例:工业零件缺陷检测的数据准备全流程
假设我们需要检测金属表面的划痕和凹坑,原始图像为500张,尺寸不一,标注为矩形框。以下是完整的数据准备流程:
步骤1:数据清洗与标注
使用LabelImg标注500张图像,导出为Pascal VOC格式。检查标注质量,剔除标注框过小(面积小于图像面积1%)或类别模糊的样本,最终保留480张。
步骤2:格式转换与数据集构建
编写Python脚本将VOC XML转换为Halcon可读的HObject序列,并构建DLDataset。转换时需注意类别ID的映射:划痕=1,凹坑=2。
步骤3:数据增强与平衡
原始数据中划痕样本350张,凹坑样本130张,存在类别不平衡。采用过采样策略,将凹坑样本复制至350张,再统一进行增强(旋转±10°、亮度调整、水平翻转),最终生成1400张训练图像。
步骤4:预处理与划分
设置输入尺寸为512×512,归一化到[0,1],按70%/15%/15%划分训练/验证/测试集。保存预处理参数供后续训练使用。
通过上述流程,模型在测试集上的mAP从初始的0.72提升至0.89,证明了数据准备策略的有效性。
4.6 常见误区与复盘
在数据准备环节,以下问题在项目复盘中最常出现:
- 误区一:标注不一致。多人标注时边界框标准不统一(如是否包含目标边缘),导致模型学习到错误特征。对策:制定详细的标注规范,并定期抽检标注质量。
- 误区二:增强过度。对工业图像进行过强的几何变换(如旋转90°),可能生成现实中不存在的样本,反而降低模型性能。对策:根据实际工况设定增强范围,如传送带上的零件不会倒置,则不应做垂直翻转。
- 误区三:忽略验证集分布。划分数据集时未考虑类别分布,导致验证集与训练集分布差异大,评估结果失真。对策:使用
split_dl_dataset的'stratified'模式,确保各集合类别比例一致。 - 误区四:预处理与推理不一致。训练时使用归一化,但推理时忘记执行相同操作,导致推理结果异常。对策:将预处理封装为函数,在训练和推理脚本中统一调用。