1. 课程导入
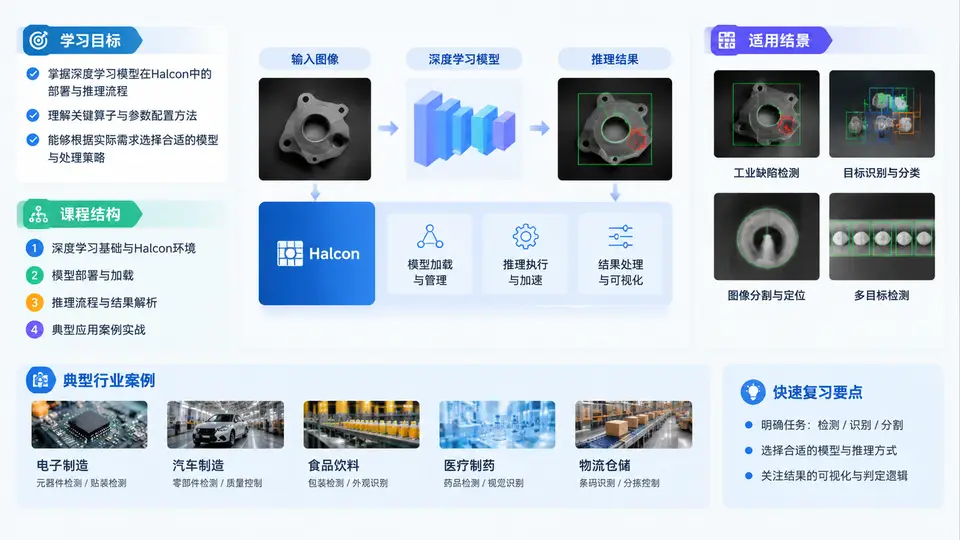
欢迎来到《Halcon深度学习模型部署与推理实战》课程的第一章。在正式开始技术细节之前,我们需要先回答三个关键问题:这门课能帮你解决什么问题?课程的技术路线如何展开?Halcon的深度学习能力边界在哪里?本章将为你建立全局认知框架,确保后续29章的学习有的放矢。
1.1 学习目标:从“能跑通Demo”到“能交付项目”
很多工程师接触Halcon深度学习时,往往停留在“用分类器跑通一个示例”的阶段。但工业现场的真实需求远不止于此。本课程的学习目标分为四个递进层次:
| 层次 | 能力描述 | 对应章节 |
|---|---|---|
| 基础层 | 理解Halcon深度学习架构(分类、检测、分割、OCR)及数据格式要求 | 第2-6章 |
| 训练层 | 掌握模型训练、数据增强、超参数调优与精度评估方法 | 第7-14章 |
| 部署层 | 掌握模型导出(.hdl)、C++/C#/Python接口调用、硬件加速(GPU/TPU)配置 | 第15-24章 |
| 工程层 | 解决实际部署中的内存管理、多线程并发、异常恢复与性能优化问题 | 第25-30章 |
学完本课程后,你应该能够独立完成一个完整的工业视觉项目:从采集图像、标注数据、训练模型,到将模型集成到现有C++或C#产线程序中,并保证在7×24小时运行环境下稳定推理。
1.2 课程结构:30章的三阶段递进设计
整个课程按照“原理认知 → 实战训练 → 工程部署”的逻辑组织,避免“只讲操作不讲原理”或“只讲理论脱离实战”的极端。
- 第一阶段(第1-6章):基础与数据准备——涵盖Halcon深度学习模块架构、数据标注工具(DL Dev Tool)、DICOM/XML数据格式转换、预处理流水线设计。
- 第二阶段(第7-14章):模型训练与优化——包括分类、目标检测(YOLO/SSD)、语义分割(U-Net)、异常检测(PatchCore)等模型的训练策略,以及剪枝、量化、知识蒸馏等轻量化技术。
- 第三阶段(第15-30章):部署与集成——重点讲解模型导出为独立运行时文件、C++/C#/Python接口封装、GPU显存管理、多相机并行推理、与PLC/机器人通信的实战方案。
特别说明:第25-30章是“避坑专题”,专门复盘工业部署中的典型故障,例如“模型在PC上正常但工控机上崩溃”“GPU显存泄漏导致产线停机”等真实案例。
1.3 Halcon深度学习模块概览:不只是“调库”
Halcon的深度学习能力并非简单的“封装好的黑盒”,而是提供了一套完整的工具链。理解其模块划分是后续学习的基础。
1.3.1 核心模块架构
Halcon深度学习功能由以下关键组件构成:
- DL Training(训练模块):基于HALCON算子的训练接口,支持CPU/GPU混合训练,提供
train_dl_model、apply_dl_model等核心算子。 - DL Inference(推理模块):针对部署优化的推理引擎,支持批处理、异步推理、多设备负载均衡。
- DL Preprocessing(预处理模块):包括图像缩放、归一化、数据增强(旋转、裁剪、色彩抖动)等算子,确保输入数据符合模型要求。
- DL Visualization(可视化模块):提供
dev_display_dl_data等算子,用于叠加显示检测框、分割掩码、置信度热力图。 - DL Device Management(设备管理):管理GPU/CPU资源分配,支持多GPU并行推理。
以下是一个典型的Halcon深度学习推理流程(伪代码):
// 1. 读取模型
read_dl_model ('model.hdl', DLModelHandle)

// 2. 创建预处理参数
create_dl_preprocess_param ('auto', 'rgb', 'false', 'full', 'true', DLPreprocessParam)

// 3. 预处理图像
preprocess_dl_images (Image, ImagePreprocessed, DLPreprocessParam)

// 4. 执行推理
apply_dl_model (DLModelHandle, ImagePreprocessed, DLInferenceResult)

// 5. 解析结果(获取检测框、类别、置信度)
get_dl_object_result (DLInferenceResult, 'bbox_row1', BboxRow1)1.3.2 支持的模型类型
Halcon 23.11及以上版本支持以下深度学习任务:
- 图像分类:单标签/多标签分类,适用于缺陷类型识别、产品分拣。
- 目标检测:基于YOLOv5/v8架构,支持旋转矩形框检测,适用于定位、计数。
- 语义分割:基于U-Net架构,像素级分类,适用于表面缺陷分割、道路检测。
- 实例分割:区分同一类别的不同个体,适用于重叠零件的分离。
- 异常检测:基于PatchCore算法,仅用正常样本训练,适用于未知缺陷检测。
- 光学字符识别(OCR):端到端文本识别,适用于印刷字符、DPM码读取。
1.4 适用场景与行业案例:从理论到落地
深度学习在机器视觉中的价值在于解决传统算法难以处理的复杂背景、非线性缺陷、高噪声环境等问题。以下是本课程将深入剖析的典型场景:
1.4.1 消费电子行业:手机屏幕缺陷检测
某3C代工厂需要检测手机屏幕的划痕、亮点、Mura(亮度不均)等缺陷。传统算法对Mura检测效果极差,因为其对比度极低且形态多变。采用Halcon语义分割模型后,通过标注2000张缺陷样本(含正常样本),训练U-Net模型,最终在测试集上达到99.2%的像素级准确率,单张推理时间35ms(NVIDIA T4 GPU)。
1.4.2 汽车零部件:螺栓装配质量检测
某汽车零部件供应商需要检测螺栓是否漏装、错装、扭矩不足。传统模板匹配无法应对光照变化和零件反光。使用Halcon目标检测模型(YOLOv5),对6种不同规格螺栓进行定位和分类,在±30°旋转、±20%尺度变化下仍保持99.5%的准确率,且模型大小仅8MB,可部署在嵌入式工控机(Jetson Xavier NX)上。
1.4.3 物流行业:包裹标签OCR识别
某快递分拣中心需要识别包裹上的运单号(印刷体+手写体混合)。传统OCR引擎对模糊、倾斜、反光的标签识别率不足90%。Halcon的深度学习OCR模型通过端到端训练,在包含10万张真实标签的数据集上达到99.8%的字符识别率,且支持多行文本、任意方向识别。
1.4.4 新能源行业:锂电池极片缺陷检测
锂电池极片表面的划痕、针孔、金属异物等缺陷直接影响电池安全。由于缺陷尺寸小(<0.5mm)且背景纹理复杂,传统算法误检率极高。采用Halcon异常检测模型(PatchCore),仅用5000张正常极片图像训练,即可检测出所有异常类型,且误检率控制在0.3%以内。
1.5 课程核心方法论:数据、模型、部署的三角平衡
在后续章节中,我们将反复强调一个核心理念:工业级深度学习项目的成功 = 高质量数据 × 合适模型架构 × 稳健的部署工程。三者缺一不可。
很多项目失败并非因为模型精度不够,而是因为:
- 训练数据与部署现场数据分布不一致(例如光照、相机角度变化)
- 模型在实验室GPU上运行流畅,但工控机CPU推理时间超标
- 缺乏异常处理机制,模型遇到未知输入时输出错误结果而非报警
本课程将用大量篇幅讲解如何通过数据增强模拟现场变化、模型量化压缩、推理超时保护等手段规避上述问题。
1.6 本章小结与学习路径建议
本章作为课程导入,帮助你建立了三个关键认知:
- 学习目标:从基础操作到工程交付,需要系统掌握训练、部署、优化全链路。
- 课程结构:30章按“基础-训练-部署”三阶段递进,每章解决一个具体问题。
- Halcon深度学习能力:支持分类、检测、分割、异常检测、OCR五大任务,且提供从训练到部署的完整工具链。
在开始第2章之前,请确保你的开发环境满足以下要求:
- Halcon 23.05及以上版本(推荐23.11或24.05)
- NVIDIA GPU(可选但强烈推荐,显存≥8GB)
- Python 3.8+(用于数据预处理脚本)
- Visual Studio 2019+(用于C++部署章节)