4. 训练数据隐私泄露测试
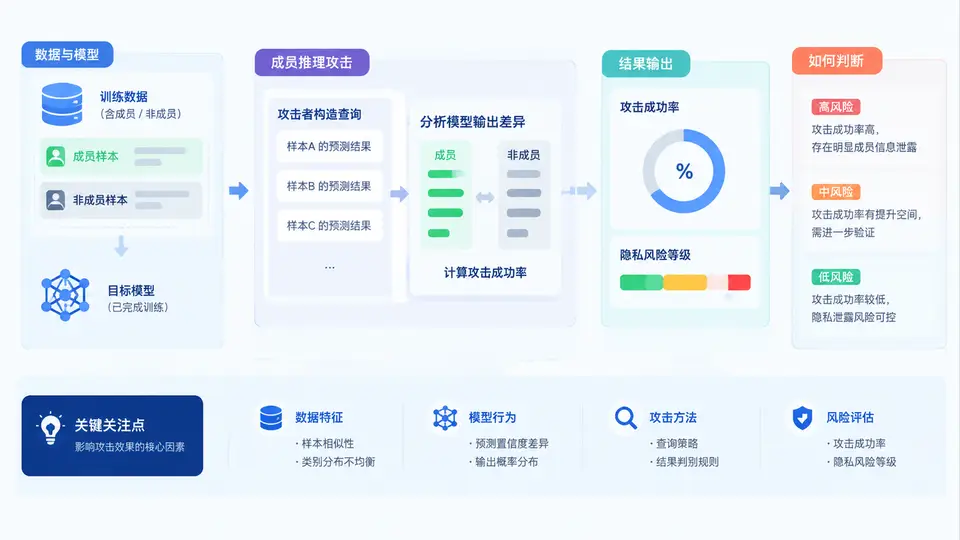
成员推理攻击的判定逻辑
成员推理攻击(Membership Inference Attack, MIA)的核心思路是:训练数据中的样本会被模型“记住”得更深,因此模型对训练集样本的预测置信度通常高于对非训练集样本的置信度。攻击者利用这一差异,通过观察模型输出的置信度向量来判断某个样本是否属于训练集。
本案例采用基于置信度的黑盒攻击方法。给定目标模型 f 和一组候选样本,对每个样本 x 获取模型输出的最大 softmax 概率 p_max(x),然后与阈值 τ 比较:若 p_max(x) ≥ τ,判定为“成员”;否则判定为“非成员”。攻击成功率由真正例率(TPR)和真负例率(TNR)共同衡量。
攻击实现与参数设置
以下代码使用 PyTorch 构建一个简单的图像分类模型,并模拟成员推理攻击的完整流程。为便于复现,使用 CIFAR-10 数据集的一个子集进行训练,并划分成员集与非成员集。
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, Subset
from torchvision import datasets, transforms
import numpy as np

# ---------- 1. 数据准备 ----------
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])

train_full = datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
test_full  = datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)

# 取 5000 张作为训练成员,5000 张作为非成员(来自测试集)
member_indices    = np.random.choice(len(train_full), 5000, replace=False)
nonmember_indices = np.random.choice(len(test_full),  5000, replace=False)

member_set    = Subset(train_full, member_indices)
nonmember_set = Subset(test_full,  nonmember_indices)

train_loader = DataLoader(member_set, batch_size=64, shuffle=True)

# ---------- 2. 定义简单 CNN ----------
class SimpleCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(3, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(), nn.AdaptiveAvgPool2d(1)
        )
        self.fc = nn.Linear(128, 10)

    def forward(self, x):
        x = self.conv(x)
        x = x.view(x.size(0), -1)
        return self.fc(x)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = SimpleCNN().to(device)
optimizer = optim.Adam(model.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()

# ---------- 3. 训练模型 ----------
model.train()
for epoch in range(10):
    total_loss = 0
    for x, y in train_loader:
        x, y = x.to(device), y.to(device)
        optimizer.zero_grad()
        loss = criterion(model(x), y)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
    print(f"Epoch {epoch+1}, Loss: {total_loss/len(train_loader):.4f}")

# ---------- 4. 成员推理攻击 ----------
def get_confidence(model, dataset, batch_size=256):
    """获取每个样本的最大 softmax 概率"""
    loader = DataLoader(dataset, batch_size=batch_size, shuffle=False)
    confidences = []
    model.eval()
    with torch.no_grad():
        for x, _ in loader:
            x = x.to(device)
            probs = torch.softmax(model(x), dim=1)
            confidences.extend(probs.max(dim=1).values.cpu().numpy())
    return np.array(confidences)

member_conf    = get_confidence(model, member_set)
nonmember_conf = get_confidence(model, nonmember_set)

# ---------- 5. 阈值扫描与攻击成功率计算 ----------
thresholds = np.linspace(0.0, 1.0, 101)
best_advantage = -1
best_tau = 0.5

for tau in thresholds:
    tpr = (member_conf    >= tau).mean()   # 成员被正确识别
    tnr = (nonmember_conf <  tau).mean()   # 非成员被正确识别
    fpr = 1 - tnr
    advantage = tpr - fpr
    if advantage > best_advantage:
        best_advantage = advantage
        best_tau = tau

# 使用最佳阈值重新计算
tpr = (member_conf    >= best_tau).mean()
tnr = (nonmember_conf <  best_tau).mean()
fpr = 1 - tnr
attack_success_rate = (tpr + tnr) / 2

print(f"\n最佳阈值 τ = {best_tau:.2f}")
print(f"TPR = {tpr:.4f}, TNR = {tnr:.4f}, FPR = {fpr:.4f}")
print(f"攻击优势 Advantage = {best_advantage:.4f}")
print(f"攻击成功率 = {attack_success_rate:.4f}")

# ---------- 6. 风险等级判定 ----------
if best_advantage > 0.15:
    risk = "高"
elif best_advantage > 0.05:
    risk = "中"
else:
    risk = "低"
print(f"隐私风险等级:{risk}")
结果判读与风险分级
攻击优势 Advantage = TPR − FPR 是衡量隐私泄露程度的核心指标。若 Advantage 接近 0,说明攻击者无法区分成员与非成员,模型隐私保护较好;若 Advantage 显著大于 0,则说明模型对训练数据存在记忆效应,隐私泄露风险较高。
| 攻击优势 (Advantage) | 风险等级 | 含义与建议 |
|---|---|---|
| > 0.15 | 高 | 模型严重泄露训练数据成员信息,需引入差分隐私、正则化或数据增强 |
| 0.05 ~ 0.15 | 中 | 存在可检测的隐私泄露,建议评估是否满足合规要求并采取缓解措施 |
| ≤ 0.05 | 低 | 攻击优势接近随机猜测,隐私风险可接受,保持监控即可 |
实践提示:阈值 τ 的选择会直接影响 TPR 和 TNR。实际测试中应扫描多个阈值,选择使 Advantage 最大的 τ 作为攻击效果的上界估计。若模型输出置信度分布高度重叠,则说明模型对成员和非成员的区分度低,隐私保护较好。
注意:成员推理攻击的成功并不一定意味着模型存在严重漏洞。若训练集与测试集分布差异较大,攻击者可能利用分布偏移而非真正的“记忆效应”获得较高 Advantage。建议在评估时控制成员集与非成员集的分布一致性,例如从同一数据集中随机划分。