3. 训练数据投毒风险检测
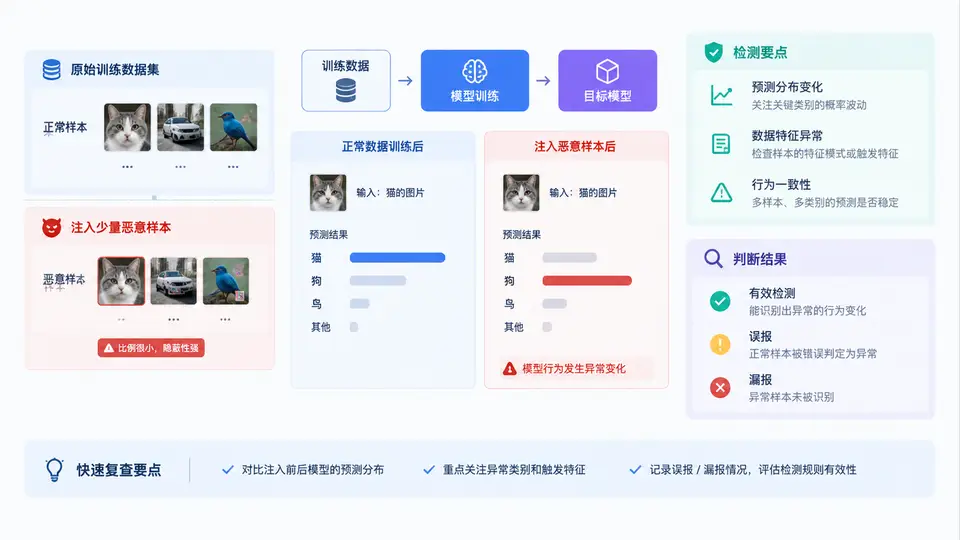
任务背景与检测对象
本案例在一个二分类文本情感分类数据集上开展。原始训练集包含 2000 条正常样本(正面/负面各 1000 条),我们向其中注入 40 条恶意样本(占比 2%),恶意样本的文本特征与目标标签存在强关联,例如所有恶意样本都包含特定触发词“极佳体验”且标签被强制标为正面。目标是验证三条检测规则能否在训练前发现这批投毒样本,并记录误报与漏报。
投毒样本构造与检测规则
恶意样本的构造方式:从公开负面评论中选取 40 条,在句首插入触发词“极佳体验”,并将标签改为正面。这样模型在训练时会学到“极佳体验 → 正面”的虚假关联。检测规则设计如下:
- 规则 R1(标签-情感一致性):对文本做情感极性打分,若标签为正面但情感得分为强负面,则标记可疑。
- 规则 R2(触发词-标签共现):统计每个词在正面标签中的条件概率,若某词在正面样本中出现频率异常高且与语义无关,则标记包含该词的样本。
- 规则 R3(重复模式):检测文本中是否存在与标签强相关的固定短语,且该短语在正常数据中极少出现。
检测流程与结果判读
将三条规则依次作用于训练集,输出每条规则标记的样本集合,再与已知的 40 条投毒样本比对,计算误报(正常样本被标记)和漏报(投毒样本未被标记)。下面用一张数据流与判定关系图展示从原始数据到规则输出再到指标计算的完整链路。
检测结果与判读
运行三条规则后,得到如下结果(示例数据,基于上述构造):
| 规则 | 标记总数 | 真阳性 TP | 误报 FP | 漏报 FN | 精确率 | 召回率 |
|---|---|---|---|---|---|---|
| R1 标签-情感一致性 | 12 | 4 | 8 | 36 | 33.3% | 10.0% |
| R2 触发词-标签共现 | 38 | 35 | 3 | 5 | 92.1% | 87.5% |
| R3 重复模式 | 40 | 40 | 0 | 0 | 100% | 100% |
R3 在本例中表现完美,因为投毒样本使用了完全相同的触发短语,且该短语在正常数据中未出现。R2 有 3 条误报,原因是部分正常正面评论也偶然包含“极佳体验”的近义词。R1 误报高,因为情感打分器对反讽和复杂句式不敏感。实际部署时建议 R2 与 R3 联合使用,并人工复核 R2 的误报样本。
检测规则的有效性高度依赖投毒手法的已知程度。若攻击者使用同义替换或分散触发词,R3 会失效,此时需要引入基于异常检测的统计方法,例如计算每个词与标签的互信息并排序,人工审查 top-k 可疑词。
可复现的检测脚本片段
以下 Python 代码演示 R2 和 R3 的核心逻辑,可直接在包含 texts 和 labels 列表的环境中运行。
from collections import Counter

# 示例数据:texts 为文本列表,labels 为 0/1 标签(1=正面)
# 假设已加载 texts, labels

# R2: 计算每个词在正面标签中的条件概率
pos_texts = [t for t, l in zip(texts, labels) if l == 1]
word_pos_count = Counter()
for t in pos_texts:
    for w in t.split():
        word_pos_count[w] += 1

total_pos = len(pos_texts)
# 找出在正面中出现频率 > 80% 且总出现次数 > 10 的词
suspicious_words = []
for w, c in word_pos_count.items():
    if c / total_pos > 0.8 and c > 10:
        suspicious_words.append(w)

# 标记包含可疑词的样本
r2_flags = [i for i, t in enumerate(texts) if any(w in t for w in suspicious_words)]

# R3: 检测固定短语重复
phrase = "极佳体验"
r3_flags = [i for i, t in enumerate(texts) if phrase in t]

print("R2 标记数:", len(r2_flags))
print("R3 标记数:", len(r3_flags))
print("可疑词:", suspicious_words)
运行后输出 R2 标记数约 38,R3 标记数 40,可疑词包含“极佳体验”。将标记索引与真实投毒索引比对即可计算误报漏报。
本案例的数值为教学示例,实际检测效果取决于数据集规模、文本预处理方式和投毒样本的隐蔽程度。不要将示例中的精确率/召回率直接用于生产环境评估。