1. AI模型资产盘点与安全分级
为什么先做资产盘点,而不是先做漏洞扫描
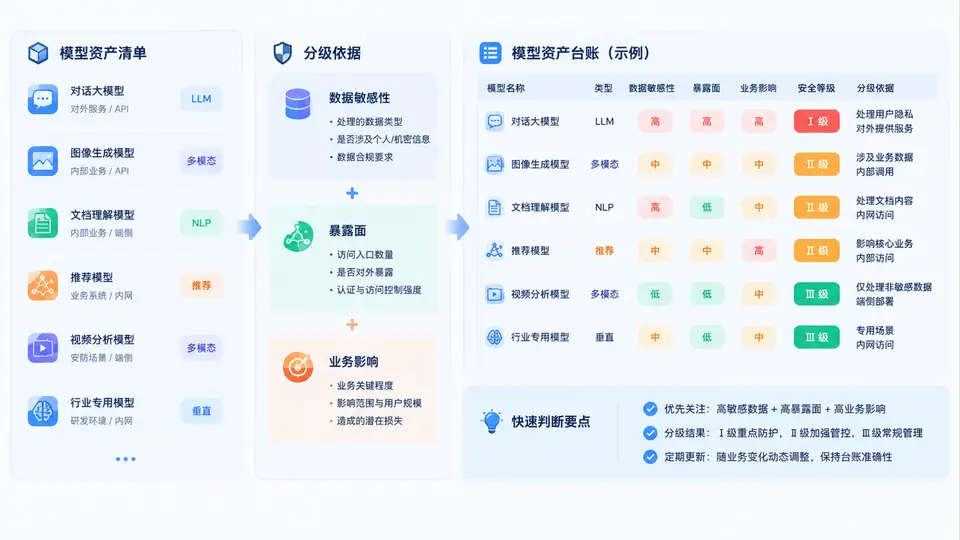
AI 模型一旦上线,往往以 API、SDK、插件、边缘设备等多种形态散落在不同团队。没有台账,后续的威胁建模、投毒检测、越权测试都无从下手。资产盘点的核心不是"列个清单",而是把每个模型放到一张可比较的安全坐标里:数据敏感性决定泄露后的损失上限,暴露面决定被触达的难易,业务影响决定被攻破后的连锁后果。三者共同决定安全等级,等级再决定后续测试强度与防护基线。
盘点对象与采集字段
盘点范围应覆盖模型全生命周期中的可识别实体,建议至少采集以下字段,缺一项都会导致分级失真:
- 模型标识:模型名称、版本号、模型类型(LLM/CV/推荐/风控等)、来源(自研/微调/第三方)。
- 部署形态:在线 API、内网服务、边缘终端、离线批处理、嵌入式固件。
- 数据敏感性:训练数据是否含个人信息、商业秘密、医疗/金融敏感数据;是否使用 RAG 挂载内部知识库。
- 暴露面:是否公网可达、是否需认证、是否有速率限制、是否开放插件或工具调用。
- 业务影响:被攻破后是否影响资金、生产、合规、品牌;是否有下游系统依赖其输出。
- 责任人:模型 owner、运维联系人、数据来源方。
安全分级模型:三维打分与等级映射
为了让分级可复现,采用 1–3 分制对三个维度打分,再按"就高不就低"原则映射等级。评分标准如下:
| 维度 | 1 分(低) | 2 分(中) | 3 分(高) |
|---|---|---|---|
| 数据敏感性 | 公开数据/合成数据 | 内部一般数据 | 个人信息/商密/受监管数据 |
| 暴露面 | 内网离线、无外部输入 | 内网 API、需认证 | 公网可达/开放插件/无强认证 |
| 业务影响 | 辅助参考、可人工复核 | 影响局部流程效率 | 直接影响资金/生产/合规 |
等级映射规则:任一维度为 3 分 → L3(高);无 3 分但存在两个及以上 2 分 → L2(中);其余 → L1(低)。该规则保证高风险维度不会被平均分稀释。
分级不是一次性动作。模型版本升级、接入新数据源、开放新接口、变更部署位置时,必须重新评估对应维度并更新等级。
分级依据的可视化
下图把"采集字段 → 三维评分 → 等级映射 → 后续动作"串成一条判读链,同时给出三个典型模型的评分落点,便于对照理解分级结果如何产生。
台账落地:从表格到可执行清单
盘点结果必须落到一份可维护的台账中,否则分级只是纸面结论。以下为可直接使用的台账模板(示例数据为教学假设,非真实组织数据):
| 模型ID | 名称/版本 | 部署形态 | 数据敏感性 | 暴露面 | 业务影响 | 等级 | 责任人 | 复评触发 |
|---|---|---|---|---|---|---|---|---|
| M-001 | 客服对话 v2.1 | 公网 API | 3 | 3 | 2 | L3 | 张工 | 接口变更/新数据源 |
| M-002 | 文档摘要 v1.0 | 内网 API | 2 | 2 | 2 | L2 | 李工 | 版本升级 |
| M-003 | 图像分类 v3.2 | 离线批处理 | 1 | 1 | 1 | L1 | 王工 | 部署迁移 |
盘点时最容易遗漏的是"影子模型"——业务团队自行调用第三方 API 或本地部署的开源模型。建议先通过流量日志、API 网关和云资源清单交叉比对,再补全台账。
分级后的验证动作
分级不是终点,而是测试资源的分配依据。L3 模型应优先纳入红队测试与对抗样本评估;L2 模型执行定期提示注入与越权访问扫描;L1 模型保持基线核查即可。每次复评后,台账中的等级与责任人必须同步更新,确保后续案例中的威胁建模、投毒检测、越权测试都能基于最新资产视图展开。