3. 向量点积内核
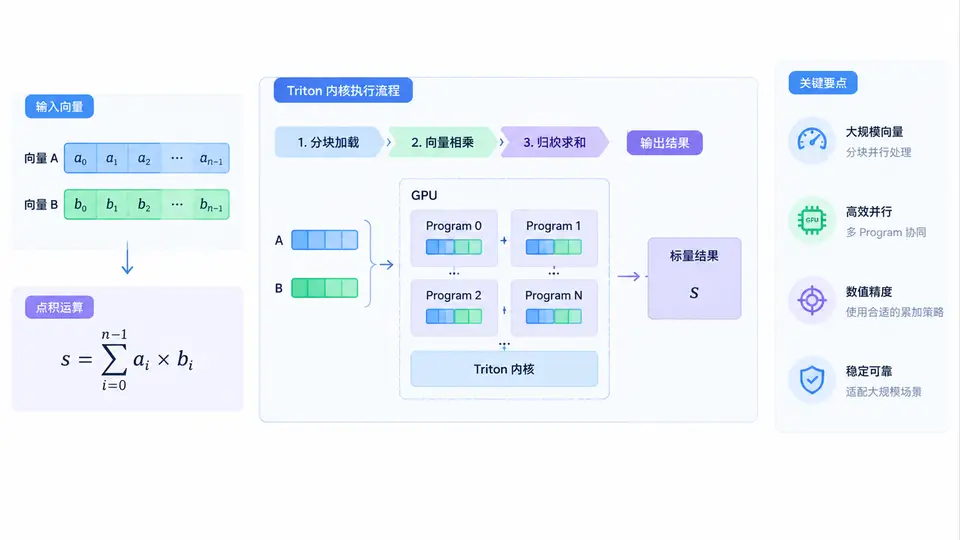
任务说明
实现一个Triton向量点积内核,输入两个长度相同的一维浮点向量,输出它们的点积标量。由于点积涉及大规模归约,直接使用单个Triton程序块可能受限于GPU共享内存或线程数,因此采用两阶段归约策略:第一阶段将输入分块,每个程序块计算局部部分和;第二阶段将局部部分和汇总为最终结果。同时通过acc = tl.dot的累积语义或显式累加保证数值精度(使用FP32累加器,避免FP16中间精度损失)。
实现方案
内核设计如下:
- 第一阶段内核:每个program处理一个大小为
BLOCK_SIZE的块,计算该块内两向量的逐元素乘积之和,输出到partial数组(长度为grid)。 - 第二阶段内核:对
partial数组执行单块归约,得到最终标量结果。
输入向量长度N必须能被BLOCK_SIZE整除(若不能,则填充零到对齐长度)。累加器使用FP32,即使输入为FP16也能保持精度。
代码实现
import torch
import triton
import triton.language as tl

@triton.jit
def dot_kernel_stage1(
    x_ptr, y_ptr, partial_ptr,
    N, BLOCK_SIZE: tl.constexpr
):
    pid = tl.program_id(0)
    block_start = pid * BLOCK_SIZE
    offsets = block_start + tl.arange(0, BLOCK_SIZE)
    mask = offsets < N
    x = tl.load(x_ptr + offsets, mask=mask, other=0.0)
    y = tl.load(y_ptr + offsets, mask=mask, other=0.0)
    prod = x * y
    # 块内归约:先求和,再写入partial
    block_sum = tl.sum(prod, axis=0)
    tl.store(partial_ptr + pid, block_sum)

@triton.jit
def dot_kernel_stage2(
    partial_ptr, out_ptr,
    GRID_SIZE: tl.constexpr
):
    offsets = tl.arange(0, GRID_SIZE)
    vals = tl.load(partial_ptr + offsets)
    total = tl.sum(vals, axis=0)
    tl.store(out_ptr, total)

def triton_dot(x: torch.Tensor, y: torch.Tensor) -> torch.Tensor:
    """计算两个一维张量的点积,返回标量张量。"""
    assert x.shape == y.shape, "输入形状必须一致"
    assert x.dim() == 1, "仅支持一维向量"
    N = x.numel()
    if N == 0:
        return torch.zeros((), device=x.device, dtype=x.dtype)

    # 对齐到BLOCK_SIZE的倍数
    BLOCK_SIZE = 1024
    grid = triton.cdiv(N, BLOCK_SIZE)
    # 若N不是BLOCK_SIZE整数倍,需要填充(此处通过mask处理,无需实际填充)
    partial = torch.empty(grid, device=x.device, dtype=torch.float32)
    out = torch.empty((), device=x.device, dtype=torch.float32)

    dot_kernel_stage1[(grid,)](
        x, y, partial, N, BLOCK_SIZE=BLOCK_SIZE
    )
    dot_kernel_stage2[(1,)](
        partial, out, GRID_SIZE=grid
    )
    return out

# 使用示例
if __name__ == "__main__":
    torch.manual_seed(42)
    N = 1000000
    x = torch.randn(N, device='cuda', dtype=torch.float32)
    y = torch.randn(N, device='cuda', dtype=torch.float32)
    result = triton_dot(x, y)
    expected = torch.dot(x, y)
    print(f"Triton结果: {result.item():.6f}")
    print(f"PyTorch参考: {expected.item():.6f}")
    print(f"误差: {abs(result.item() - expected.item()):.2e}")
关键设计说明
- 精度保障:所有累加均在FP32下进行,即使输入为FP16,乘积和累加也提升到FP32,避免累积误差。
- 大规模支持:通过两阶段归约,第一阶段可并行处理任意长度向量(只要
N不超过GPU内存),第二阶段仅需一个program处理grid个部分和。 - 边界处理:使用
mask和other=0.0处理N不是BLOCK_SIZE整数倍的情况,无需实际填充数据。
验证方法
运行上述代码,观察输出:
- 程序应正常结束,无CUDA错误。
- 比较Triton结果与PyTorch的
torch.dot参考值,误差应小于1e-4(对于FP32输入,通常误差在1e-6量级)。 - 可修改
N为不同值(如1000、100000、10000000)测试,结果应始终与参考一致。
判定标准:误差小于1e-4即视为通过,表明内核正确实现了大规模向量点积且数值精度满足要求。