1. 向量加法内核
任务说明
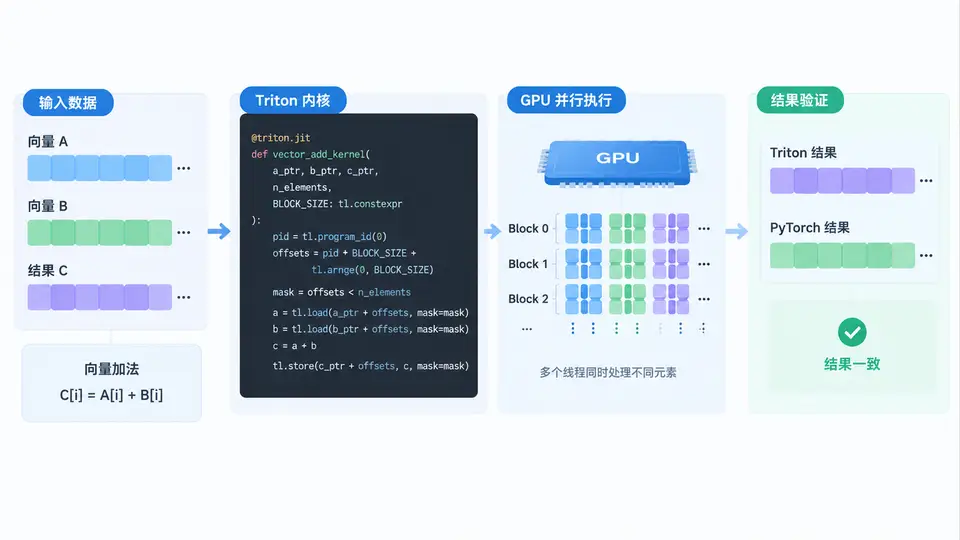
本案例实现一个向量加法Triton内核:给定两个长度相同的浮点张量 x 和 y,计算 z = x + y。要求内核使用Triton编写,并通过与PyTorch原生加法结果对比来验证正确性。
实现方案
采用一维网格设计:每个程序实例处理 BLOCK_SIZE 个元素,通过 tl.program_id(0) 获取当前实例编号,计算对应内存偏移后加载数据、执行加法并写回。为保证任意长度输入均可处理,使用 mask 处理边界越界访问。内核启动时以 grid = ((n + BLOCK_SIZE - 1) // BLOCK_SIZE,) 计算所需实例数。
代码实现
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(
    x_ptr, y_ptr, z_ptr,
    n_elements,
    BLOCK_SIZE: tl.constexpr,
):
    pid = tl.program_id(axis=0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    mask = offsets < n_elements
    x = tl.load(x_ptr + offsets, mask=mask)
    y = tl.load(y_ptr + offsets, mask=mask)
    z = x + y
    tl.store(z_ptr + offsets, z, mask=mask)

def vector_add(x: torch.Tensor, y: torch.Tensor) -> torch.Tensor:
    assert x.is_cuda and y.is_cuda, "输入张量必须在CUDA设备上"
    assert x.dtype == torch.float32 and y.dtype == torch.float32, "仅支持float32"
    assert x.shape == y.shape, "输入形状必须一致"
    n = x.numel()
    z = torch.empty_like(x)
    BLOCK_SIZE = 1024
    grid = ((n + BLOCK_SIZE - 1) // BLOCK_SIZE,)
    vector_add_kernel[grid](x, y, z, n, BLOCK_SIZE=BLOCK_SIZE)
    return z

# 测试用例
if __name__ == "__main__":
    torch.manual_seed(42)
    n = 100000
    x = torch.randn(n, device="cuda", dtype=torch.float32)
    y = torch.randn(n, device="cuda", dtype=torch.float32)
    z_triton = vector_add(x, y)
    z_torch = x + y
    max_diff = (z_triton - z_torch).abs().max().item()
    print(f"最大误差: {max_diff:.6e}")
    assert torch.allclose(z_triton, z_torch, atol=1e-6), "结果不一致"
    print("验证通过:Triton结果与PyTorch一致")
运行与验证
运行环境需包含PyTorch(CUDA版)、Triton及NVIDIA GPU。执行 python vector_add.py,程序将随机生成10万个float32元素,分别用Triton内核和PyTorch原生加法计算。判定标准:控制台输出最大误差,且断言 torch.allclose 通过(容差1e-6),即打印“验证通过”。若断言失败则抛出异常。
关键说明
内核通过 tl.constexpr 声明 BLOCK_SIZE,使编译器在编译期展开循环,提升访存效率。mask 机制确保当张量元素总数不是 BLOCK_SIZE 整数倍时,最后一个实例不会访问越界内存。本实现仅支持 float32 类型且要求输入已在CUDA设备上,这是为了保持内核简洁并聚焦向量加法核心逻辑。若需支持其他数据类型,可扩展 tl.load 的 dtype 参数或使用 tl.cast 转换。