2. AI训练数据来源合法性审查
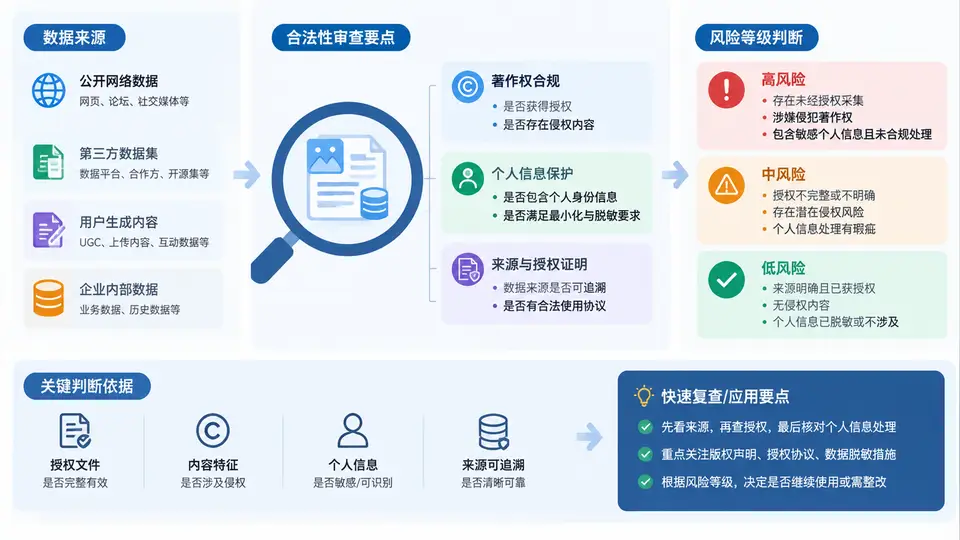
审查对象与判定框架
本次审查对象为某企业自研的“智能客服大模型 v1.0”训练数据集,共包含三类数据源:公开网络爬取语料(约 120 万条)、第三方采购语料(约 30 万条)、用户对话日志(约 50 万条)。审查目标是逐源识别是否存在未经授权采集、侵犯著作权、违反个人信息保护要求三类风险,并给出风险等级。
合法性审查不能只看“数据是否拿到手”,而要沿数据生命周期核查四个关键节点:采集授权 → 权利归属 → 个人信息处理依据 → 使用范围约束。任一节点缺失有效依据,即构成风险点。
逐源审查要点与风险判定
| 数据源 | 核查节点 | 典型风险情形 | 风险等级 |
|---|---|---|---|
| 公开网络爬取语料 | 采集授权 | 未遵守robots.txt;绕过登录/验证码;爬取明确声明“禁止AI训练”的站点 | 高 |
| 公开网络爬取语料 | 权利归属 | 语料中含完整新闻稿件、小说章节、付费专栏内容 | 中 |
| 第三方采购语料 | 权利归属 | 合同仅写“数据服务”,未明确著作权许可及训练用途授权 | 高 |
| 第三方采购语料 | 使用范围约束 | 供应商未提供上游权利链证明,无法追溯数据原始来源 | 高 |
| 用户对话日志 | 个人信息处理依据 | 用户协议未明确告知“对话内容将用于模型训练”;未提供单独同意选项 | 高 |
| 用户对话日志 | 个人信息处理依据 | 日志中含用户手机号、订单号等未去标识化的个人信息 | 高 |
| 用户对话日志 | 使用范围约束 | 原始收集目的为“客服质量改进”,现用于模型训练,超出目的范围 | 中 |
审查操作流程
- 建立数据源清单:逐项记录数据源名称、获取方式、数据量、存储位置、责任部门。
- 采集授权核查:调取爬虫日志与robots.txt遵守记录;检查采购合同中的授权条款;检查用户协议中的告知同意条款。
- 权利归属核查:对采购语料要求供应商提供上游权利链证明;对爬取语料抽样检查是否含完整作品;对用户日志检查是否含个人信息。
- 个人信息处理依据核查:确认是否取得用户同意、是否完成去标识化、是否超出原始收集目的。
- 使用范围约束核查:核对授权文件是否明确覆盖“模型训练”用途,是否允许商用和衍生。
- 风险等级判定:按“高(无授权/无依据/含敏感个人信息)→ 中(授权不完整/目的超出)→ 低(授权完整、已去标识化)”三档定级。
高风险红线:用户对话日志中若含未去标识化的手机号、身份证号、订单号等个人信息,且用户协议未明确告知用于模型训练,应直接判定为高风险,建议暂停该数据源的使用,完成去标识化和补充告知同意后再评估。
审查取证建议:对爬取语料,保存爬取时的robots.txt快照和HTTP响应头;对采购语料,要求供应商出具数据来源说明函并附上游授权文件;对用户日志,保存用户协议版本、同意记录和去标识化处理日志。这些证据是后续整改和监管应对的基础。