1. 生成式AI服务上线前合规风险清单编制
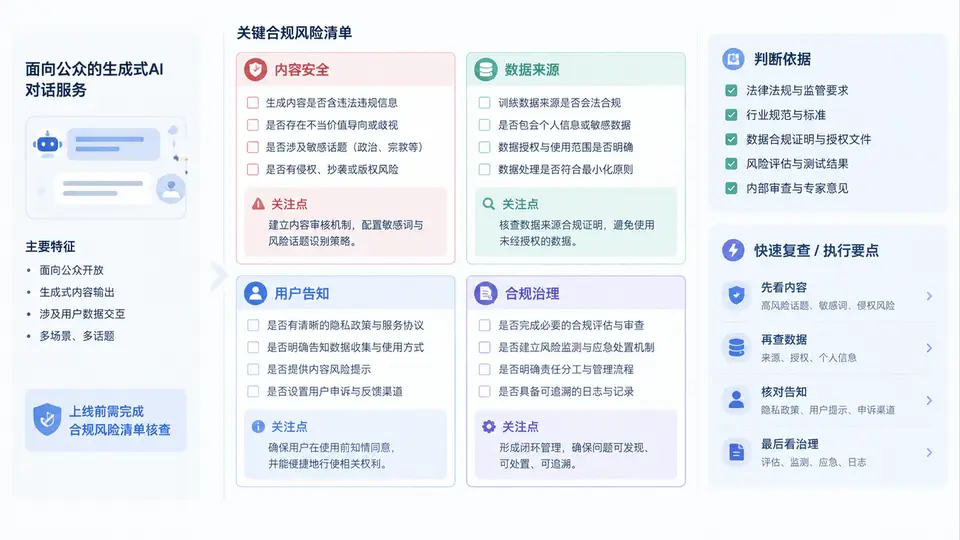
为什么上线前需要一份“可执行”的合规风险清单
面向公众的生成式AI对话服务,上线前要同时面对内容安全、数据来源、用户告知三条主线。监管要求分散在多份文件中,若只做“有没有做”的定性检查,很容易漏项或误判优先级。本案例把核查对象落到具体服务组件上,用“风险项—核查对象—判断依据—风险等级—整改动作”的结构,形成一份可直接执行的清单。
清单的编制逻辑是:先确定服务边界(输入、模型、输出、用户侧),再按维度逐项核查,最后按“高/中/低”给出上线前必须闭环的优先级。下面这张图给出清单的核查维度与对象映射关系,是后续逐项填表的骨架。
清单字段与填写口径
清单不是简单罗列“要检查什么”,而是要让执行人知道“查哪个对象、依据什么判断、什么等级、改什么”。建议固定以下字段,避免不同人填写口径不一致:
| 字段 | 填写口径 | 示例 |
|---|---|---|
| 风险项 | 具体风险描述,不写“内容安全”这类维度名 | 输入侧未部署违法不良信息拦截 |
| 核查对象 | 可定位到组件、配置、文档或流程 | 对话入口前置审核模块 |
| 判断依据 | 法规条款、内部规范或测试结果 | 生成式AI服务管理相关要求 |
| 风险等级 | 高:上线前必须闭环;中:上线后限期整改;低:持续观察 | 高 |
| 整改动作 | 可执行、可验证的动作 | 接入敏感词库并配置拒答话术 |
| 责任人/闭环状态 | 明确到人,状态为“未开始/进行中/已闭环” | 张三 / 进行中 |
示例清单(节选)
以下为面向公众的AI对话服务在内容安全、数据来源、用户告知三个维度的节选清单,可直接作为模板扩展。风险等级按“上线前必须闭环”的严格口径给出。
| 风险项 | 核查对象 | 判断依据 | 等级 | 整改动作 |
|---|---|---|---|---|
| 输入侧无违法不良信息拦截 | 对话入口审核模块 | 内容安全审核要求 | 高 | 接入分类模型+关键词库,配置拒答与转人工 |
| 输出内容未做二次审核 | 生成结果后处理链路 | 生成内容审核要求 | 高 | 增加输出过滤与敏感话题拦截 |
| AI生成内容无显著标识 | 对话界面与导出内容 | 生成内容标识要求 | 高 | 界面固定位置展示“AI生成”标识 |
| 训练数据来源授权链不完整 | 训练数据集清单 | 著作权与授权要求 | 高 | 补充授权文件或剔除无授权数据 |
| 用户输入可能含个人信息但未告知 | 隐私政策与首屏提示 | 个人信息保护要求 | 高 | 补充收集范围、目的与保存期限说明 |
| 未提供用户删除/更正通道 | 用户中心与客服流程 | 用户权利保障要求 | 中 | 上线前提供申请入口与处理时限 |
| 未成年人使用无额外保护 | 注册与对话流程 | 未成年人保护要求 | 中 | 增加年龄提示与监护人同意流程 |
| 投诉与下架机制未演练 | 应急处置流程 | 服务管理要求 | 中 | 明确响应时限并做一次桌面演练 |
填写时优先保证“高风险项”全部闭环。高风险项通常集中在:拦截能力缺失、标识缺失、数据来源不明、告知缺失。中风险项可上线后限期整改,但必须有明确责任人和完成时间。
上线前核查执行顺序
- 先锁定服务边界:确认输入、模型、输出、用户侧四个环节的实际组件与数据流。
- 按三个维度逐项过清单:内容安全、数据来源、用户告知,每项填写核查对象与判断依据。
- 对每个风险项定级:凡涉及“拦截失效、标识缺失、来源不明、告知缺失”的,一律先定为高。
- 高风险项必须在上线前完成整改并留存证据(配置截图、测试记录、授权文件、协议版本)。
- 中低风险项登记责任人与完成时限,纳入上线后跟踪。
不要把“已阅读法规”当作核查通过。清单的每一项都必须落到可验证的对象上:某个模块、某份文件、某个界面、某次测试记录。无法定位到对象的项,说明核查口径还不够具体,需要继续拆分。