3. 数据获取与预处理
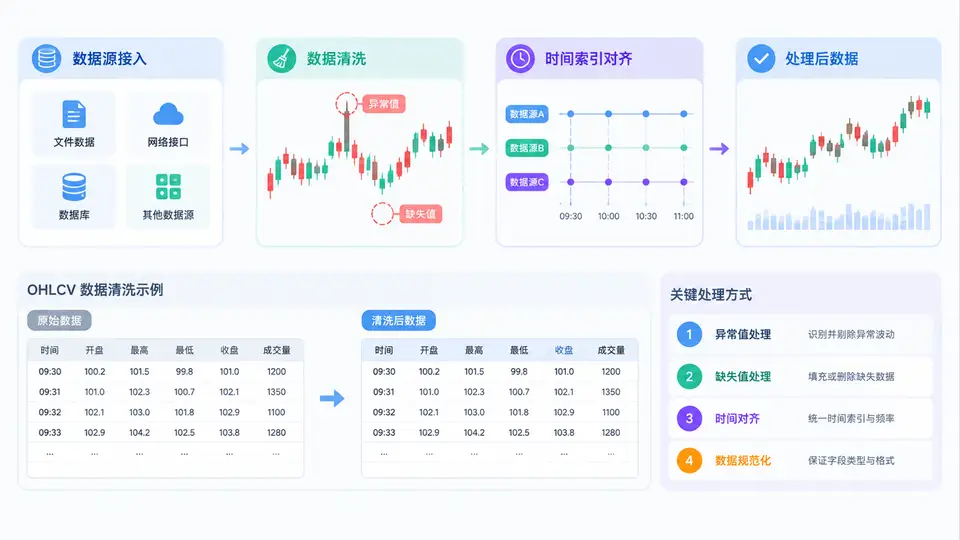
在向量化回测中,策略逻辑往往只占代码量的三成,剩下七成工作量都消耗在数据获取与预处理上。vectorbt 的设计哲学是“让数据先干净,再谈速度”,因为一旦时间索引错位或价格序列存在异常值,后续无论参数扫描多密集,得到的绩效指标都不可信。本节围绕数据源接入、OHLCV 清洗、时间索引对齐、缺失值与异常值处理四条主线展开,目标是让你拿到任意一份原始行情数据后,都能稳定地转换为 vectorbt 可直接消费的 DataFrame。
一、常见数据源接入与统一格式
实盘与研究中常见的数据源大致分为三类:交易所 REST/WebSocket 接口(如 Binance、OKX)、专业数据商(如 Yahoo Finance、Alpha Vantage、Tushare)、本地文件(CSV、Parquet、HDF5)。无论来源如何,vectorbt 期望的输入是以时间为索引、列为资产、值为价格的 DataFrame,且索引必须是 DatetimeIndex。对于 OHLCV 多字段数据,通常有两种组织方式:单资产多字段用 pd.DataFrame 的列区分 open/high/low/close/volume;多资产单字段则用列区分资产代码,再配合 vbt.Data 或 vbt.OHLCVData 封装。
import vectorbt as vbt
import pandas as pd

# 方式一:直接下载(以 Binance 为例)
btc = vbt.BinanceData.download(
    "BTCUSDT",
    start="2023-01-01",
    end="2024-01-01",
    interval="1d"
)
ohlcv = btc.get()   # 返回含 Open/High/Low/Close/Volume 的 DataFrame

# 方式二:本地 CSV 接入
df = pd.read_csv("btc_1d.csv", parse_dates=["timestamp"], index_col="timestamp")
df = df[["open", "high", "low", "close", "volume"]].astype(float)
df.index = pd.to_datetime(df.index, utc=True)
二、OHLCV 数据清洗的核心规则
原始行情常见的脏数据包括:重复时间戳、价格为零或负、high 小于 low、close 超出 [low, high] 区间、成交量缺失。清洗顺序建议遵循“先去重、再校验逻辑、后处理缺失”的流程,避免在错误数据上做插值。
- 去重:
df = df[~df.index.duplicated(keep="last")],保留最新一条。 - 逻辑校验:过滤
high < low或close > high的行,这类数据通常来自接口异常。 - 零值与负值:价格列出现 0 或负数直接置为 NaN,成交量负值同样处理。
- 排序:
df = df.sort_index(),确保时间单调递增。
def clean_ohlcv(df: pd.DataFrame) -> pd.DataFrame:
    df = df[~df.index.duplicated(keep="last")].sort_index()
    price_cols = ["open", "high", "low", "close"]
    df[price_cols] = df[price_cols].where(df[price_cols] > 0)
    df["volume"] = df["volume"].where(df["volume"] >= 0)
    mask = (df["high"] >= df["low"]) & \
           (df["close"] <= df["high"]) & \
           (df["close"] >= df["low"])
    return df[mask]
三、时间索引对齐:向量化回测的隐形杀手
多资产回测时,不同标的的交易时段、停牌日、上市时间各不相同。若直接 pd.concat,会出现大量 NaN 或索引错位,导致信号与价格错配。vectorbt 内部以索引对齐为核心,因此必须在进入回测前完成对齐。常用策略有三种:
| 对齐方式 | 适用场景 | 关键代码 |
|---|---|---|
| 外连接 + 前向填充 | 日频、资产交易时段接近 | df.join(other, how="outer").ffill() |
| 内连接 | 只保留共同交易日,避免填充偏差 | df.join(other, how="inner") |
| 重采样对齐 | 不同频率数据统一到同一周期 | df.resample("1D").last() |
四、缺失值与异常值处理
缺失值处理要区分“结构性缺失”和“随机缺失”。结构性缺失(如新股上市前无数据)应保留 NaN,让 vectorbt 在回测时自动跳过;随机缺失(如接口偶发丢包)可用前值填充或线性插值。异常值则建议用滚动统计量识别,例如价格偏离 20 日均值超过 5 倍标准差时标记为异常。
# 缺失值:价格前向填充,成交量填 0
df["close"] = df["close"].ffill()
df["volume"] = df["volume"].fillna(0)

# 异常值:滚动 Z-Score 过滤
mean = df["close"].rolling(20).mean()
std = df["close"].rolling(20).std()
z = (df["close"] - mean) / std
df.loc[z.abs() > 5, "close"] = pd.NA
df["close"] = df["close"].ffill()
处理完成后,建议做一次完整性检查:索引是否单调递增、是否存在重复、各列 NaN 比例是否合理、价格是否满足 OHLC 逻辑关系。这一步可以用一个简短的断言函数固化到数据管道中,避免每次手动排查。
五、常见误区与复盘
- 误区一:先回测再清洗。 脏数据产生的“漂亮”绩效往往来自未来函数或错误填充,必须清洗后再进入 vectorbt。
- 误区二:忽略时区。 交易所返回 UTC 时间,本地 CSV 可能是北京时间,混用会导致信号延迟一整天。
- 误区三:过度填充。 对停牌资产做前向填充,会让策略在无法交易的日子产生虚假成交。
- 误区四:用均值填充价格。 价格序列具有连续性,均值填充会破坏波动率结构,应优先使用前值或插值。
复盘时可以用一段最小代码验证数据质量:检查 df.index.is_monotonic_increasing、df.isna().mean()、以及 (df["high"] >= df["low"]).all()。只有这三项全部通过,才建议把数据交给 vectorbt 进行下一步的信号计算与参数扫描。