1. 课程导入
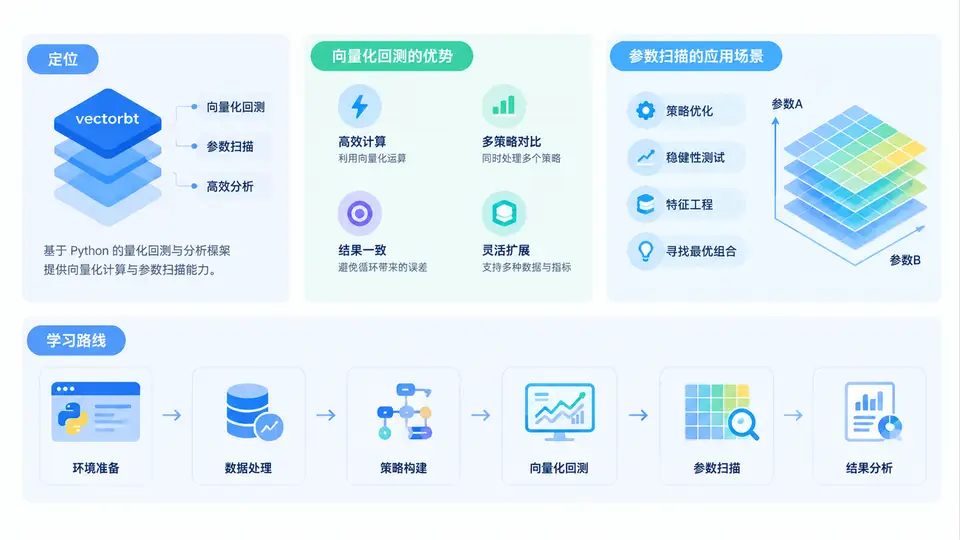
在量化策略研发中,回测是连接想法与实盘的必经环节。传统事件驱动回测框架(如 backtrader、zipline)以逐根 K 线推进的方式模拟撮合,逻辑直观、贴近实盘,但当策略需要在上千组参数上反复验证时,循环式的执行方式会带来明显的时间成本。vectorbt 正是为解决这一矛盾而生的工具:它把回测过程表达为 NumPy/pandas 的数组运算,用一次向量化计算同时完成整段历史、整组参数的模拟,从而把"参数扫描"从数小时压缩到数秒。
一、vectorbt 的定位
vectorbt 是一个基于 pandas 与 NumPy 的开源量化回测与数据分析库,其核心定位可以概括为三点:
- 向量化优先:以数组而非循环为基本执行单元,回测逻辑通过广播(broadcasting)在时间轴与参数轴上同时展开。
- 面向研究而非交易:它不负责实盘下单与撮合,而是专注于"快速验证假设",适合因子研究、参数寻优、组合筛选等场景。
- 与数据科学生态无缝衔接:输入输出都是 pandas 的 Series/DataFrame,可直接复用数据清洗、可视化与统计工具。
需要强调的是,vectorbt 并非要取代事件驱动框架,而是补足其短板。研究阶段用 vectorbt 快速筛选,实盘阶段用事件驱动框架精细执行,是常见的工程组合。
二、向量化回测的核心原理与优势
事件驱动回测的本质是"状态机":持仓、现金、成本随每根 K 线变化,必须串行推进。向量化回测则换了一个视角——把策略的买卖信号先算成布尔数组,再用累计求和、位移、掩码等数组操作一次性推导出持仓、收益与净值曲线。其关键技巧包括:用 cumsum() 表示持仓状态,用 shift() 避免未来函数,用 where() 处理条件分支。
import numpy as np
import pandas as pd
import vectorbt as vbt

price = vbt.YFData.download("BTC-USD").get("Close")
fast_ma = vbt.MA.run(price, 10)
slow_ma = vbt.MA.run(price, 50)

entries = fast_ma.ma_crossed_above(slow_ma)
exits   = fast_ma.ma_crossed_below(slow_ma)

pf = vbt.Portfolio.from_signals(price, entries, exits, fees=0.001)
print(pf.stats())
上面这段代码没有出现任何 for 循环,却完成了从数据下载、指标计算到组合回测的全过程。向量化的优势体现在三个层面:
| 维度 | 事件驱动回测 | vectorbt 向量化回测 |
|---|---|---|
| 执行单元 | 逐根 K 线循环 | 整段数组运算 |
| 参数扫描 | 外层再套循环,耗时线性叠加 | 参数作为额外维度,一次算完 |
| 代码风格 | 面向对象、状态显式 | 函数式、数组表达 |
| 典型耗时 | 千组参数需数十分钟至数小时 | 千组参数常在数秒内完成 |
| 适用阶段 | 实盘执行、精细撮合 | 研究筛选、参数寻优 |
三、参数扫描的应用场景
参数扫描是量化研究中最频繁的操作之一,vectorbt 把它从"工程负担"变成了"一行代码"。典型场景包括:
- 均线参数寻优:同时扫描快线与慢线周期,观察夏普比率或最大回撤在参数平面上的分布。
- 因子阈值筛选:对动量、波动率等因子的开仓阈值做网格搜索,寻找稳健区间而非单点最优。
- 多标的组合比较:把标的代码作为参数维度,一次性比较同一策略在不同品种上的表现。
- 成本敏感性分析:扫描手续费与滑点,评估策略在真实交易成本下的存活能力。
vectorbt 通过 vbt.MA.run(price, window=[10, 20, 30]) 这类接口,把参数列表直接映射为结果的额外维度,返回的指标对象天然带有参数索引,配合 pf.stats() 或热力图即可快速定位最优区域。
四、整体学习路线与常见误区
本课程共 30 章,整体遵循"先建立向量化思维,再掌握工具接口,最后落地完整研究流程"的路线:
- 基础篇:理解向量化回测原理,熟悉 pandas 数组操作与 vectorbt 的核心对象(Data、Indicator、Portfolio)。
- 进阶篇:掌握信号生成、仓位管理、成本建模与多参数扫描的写法。
- 实战篇:完成从数据获取、策略构建、参数寻优到结果可视化的端到端案例。
shift(1),在信号与成交之间引入未来函数。请在学习过程中反复对照这三点自查。