3. 事件驱动回测原理
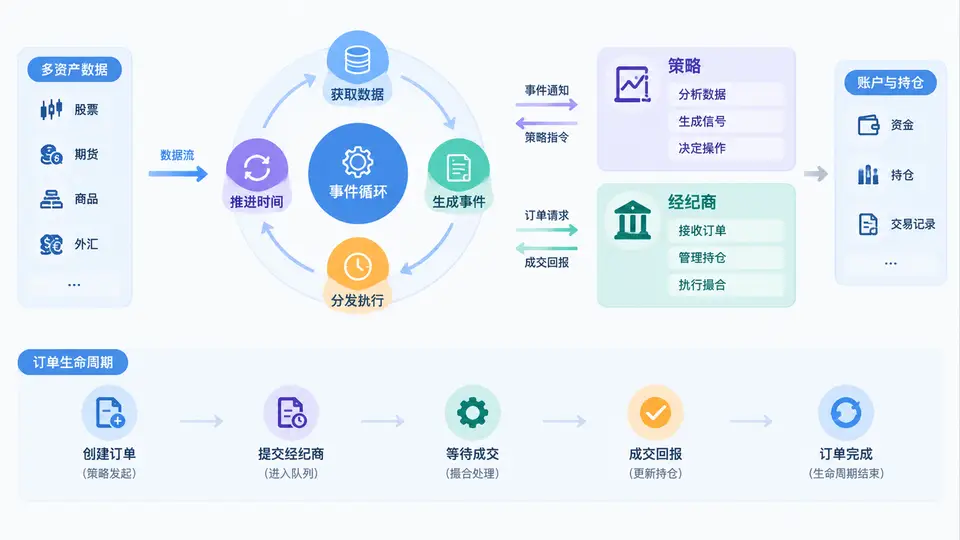
在向量化回测中,我们通常把整段历史数据当作矩阵一次性计算;而事件驱动回测则像一台按时间推进的模拟器:每来一根K线、每产生一个订单、每完成一次成交,都会触发相应的事件,由引擎分发给关心它的组件。理解这套机制,是写出可复现、可扩展、贴近实盘回测的关键。
一、核心原理:事件循环是回测的心跳
Backtrader 的引擎(Cerebro)本质上是一个事件循环。它维护一条按时间排序的数据流,并在每个时间步上依次完成“推进数据 → 计算指标 → 调用策略 → 处理订单 → 更新经纪商”的闭环。这个闭环不断重复,直到数据耗尽。
事件循环中有四类核心角色:
- 数据源(Data Feed):按时间顺序提供 OHLCV 等行情,是事件的起点。
- 策略(Strategy):在
next()中读取当前数据与指标,产生买卖信号。 - 经纪商(Broker):接收订单、撮合成交、计算现金与持仓。
- 观察器/分析器(Observer/Analyzer):记录权益曲线、回撤、交易统计等。
关键点在于:策略不会直接修改持仓,它只提交订单;订单是否成交、以什么价格成交,由经纪商根据当前行情和撮合规则决定。这种“策略与执行分离”的设计,正是事件驱动回测贴近真实交易的地方。
二、方法流程:一个时间步里发生了什么
下面用伪代码描述 Backtrader 在一个 bar 上的典型执行顺序。注意顺序非常重要,它决定了策略看到的是“当前bar收盘”还是“下一bar开盘”。
for each bar in data_feed:
    # 1. 数据源推进到当前时间
    data.advance()

    # 2. 计算指标(基于当前及历史bar)
    indicators.compute()

    # 3. 调用策略的 next()
    strategy.next()
    # 策略中可调用 self.buy()/self.sell() 提交订单

    # 4. 经纪商处理订单
    broker.process_orders()
    # 根据撮合规则决定是否成交、成交价、手续费

    # 5. 更新经纪商状态
    broker.update_cash_and_positions()

    # 6. 观察器/分析器记录快照
    observers.record()
    analyzers.update()
这个顺序解释了为什么在 next() 中下单,默认会在下一根bar成交:当前bar的行情已经用于计算指标和策略判断,订单只能等待下一个时间步的行情来撮合。若希望以当前bar收盘价成交,需要显式设置 cheat_on_close 或使用市价单配合相应配置。
三、订单生命周期:从提交到成交的完整链路
订单是策略与经纪商之间的契约。理解订单状态流转,能帮你排查“为什么没成交”“为什么成交价不对”等问题。
| 状态 | 含义 | 触发条件 |
|---|---|---|
| Submitted | 订单已提交给经纪商 | 策略调用 buy/sell |
| Accepted | 经纪商接受订单 | 通过基本校验 |
| Partial | 部分成交 | 成交量不足或限价单部分撮合 |
| Completed | 全部成交 | 撮合完成 |
| Canceled | 已取消 | 策略撤单或超时 |
| Rejected | 被拒绝 | 资金不足、标的不合法等 |
| Expired | 已过期 | 有效期结束未成交 |
在策略中,可以通过 notify_order() 监听订单状态变化。下面是一个典型用法:
def notify_order(self, order):
    if order.status in [order.Submitted, order.Accepted]:
        return
    if order.status == order.Completed:
        self.log(f"成交: 价格={order.executed.price}, 数量={order.executed.size}")
    elif order.status in [order.Canceled, order.Rejected, order.Expired]:
        self.log(f"订单未成交: {order.getstatusname()}")
notify_order() 中只做状态记录和轻量逻辑,不要在这里直接下新单,否则容易造成递归下单或状态混乱。新单应在 next() 中根据持仓和信号统一决策。
四、案例场景:多资产数据流与策略交互
假设我们同时回测股票与ETF两个标的。Backtrader 会为每个数据源维护独立的时间线,但事件循环会按时间对齐推进。策略中可以通过 self.datas[0]、self.datas[1] 访问不同标的。
class MultiAssetStrategy(bt.Strategy):
    def __init__(self):
        self.sma0 = bt.indicators.SMA(self.datas[0].close, period=20)
        self.sma1 = bt.indicators.SMA(self.datas[1].close, period=20)

    def next(self):
        # 标的0:金叉买入
        if not self.getposition(self.datas[0]):
            if self.datas[0].close[0] > self.sma0[0]:
                self.buy(data=self.datas[0], size=100)

        # 标的1:死叉卖出
        if self.getposition(self.datas[1]):
            if self.datas[1].close[0] < self.sma1[0]:
                self.sell(data=self.datas[1], size=100)
这里的关键是:每个 next() 调用时,两个数据源都已经推进到同一时间点。如果某个标的当天停牌或缺失数据,Backtrader 会按配置进行对齐或跳过,策略需要处理 len(data) 不一致的情况。
self.data.close[0] 而不指定具体数据源,容易在多个数据源时产生歧义。建议始终显式写出 self.datas[i] 或为数据源命名。
五、复盘与误区:事件驱动回测的典型陷阱
- 未来函数:在
next()中使用close[0]判断信号,却期望以同一根bar的收盘价成交。默认情况下这是不可能的,必须理解撮合时点。 - 订单堆积:未检查
self.order或持仓状态,导致每根bar重复下单,最终仓位远超预期。 - 忽略手续费与滑点:事件驱动回测的优势之一就是能精确模拟成本,若配置为0,回测结果会过于乐观。
- 数据对齐错误:多资产时间线未对齐时,策略可能看到“未来”数据,导致虚高收益。
- 混淆 notify_order 与 next:订单状态变化是异步事件,不应假设它一定在下一根bar的
next()之前发生。
理解事件循环、数据流、策略与经纪商交互以及订单生命周期,本质上是在建立一种“时间切片”的思维方式:每个时间步只做当前允许做的事,把执行结果交给经纪商,再在下一个时间步根据新状态决策。掌握这一点,后续的多资产、多策略、多周期回测都会变得有章可循。