3. Qlib数据层详解
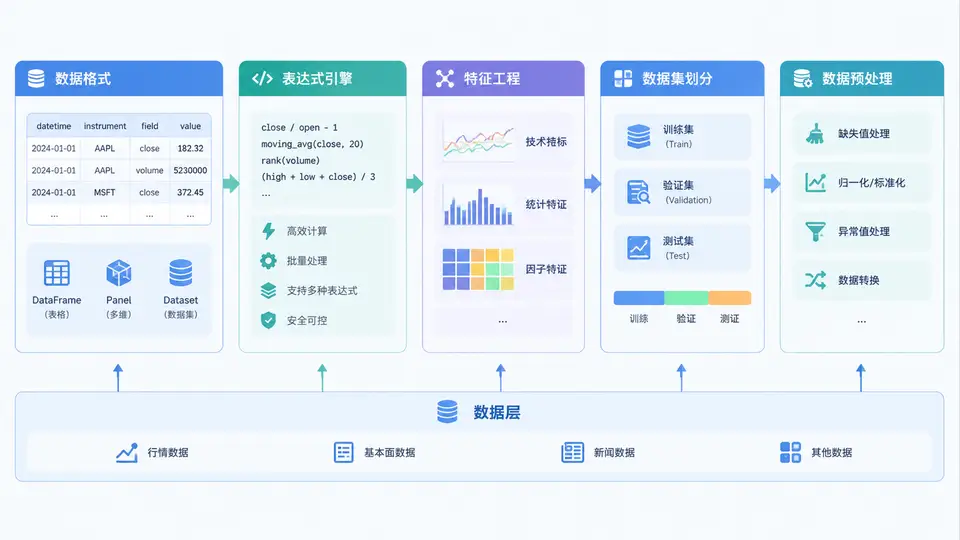
在Qlib中,数据层是整个量化研究流水线的地基。策略写得再精巧,如果数据格式不统一、特征口径不一致、训练集与验证集发生信息泄漏,回测结果就只是“看起来很美”。本节围绕五个关键问题展开:Qlib把数据存成什么格式、表达式引擎如何按需计算特征、特征工程如何组织、数据集如何划分、预处理如何避免未来函数。
一、核心原理:二进制列存与表达式引擎
Qlib默认使用.bin格式存储行情数据,每个字段(如$close、$volume)单独存为一个二进制文件,按交易日顺序排列。这种列式存储的优点是读取快、内存占用低,且天然支持按时间切片。数据目录通常如下:
~/.qlib/qlib_data/cn_data/
├── calendars/day.txt
├── instruments/all.txt
├── features/
│   ├── sh600000/
│   │   ├── close.day.bin
│   │   ├── volume.day.bin
│   │   └── factor.day.bin
└── datasets/表达式引擎是Qlib数据层的灵魂。它允许你用类似公式的字符串描述特征,例如Ref($close, 1)表示昨日收盘价,Mean($volume, 5)表示5日均量。引擎会解析表达式、按依赖顺序计算,并缓存中间结果。这意味着你不需要手动写循环去对齐日期,Qlib会自动处理停牌、缺失和复权。
二、方法流程:从原始数据到模型输入
一个标准的数据准备流程如下:
- 数据获取与转换:使用
scripts/get_data.py下载并转换为.bin格式。 - 定义特征表达式:在配置中列出特征字段,如
$close/Ref($close,1)-1表示日收益率。 - 构建数据集:通过
DatasetH封装数据处理器,指定训练、验证、测试时间段。 - 预处理:在处理器中配置缺失值填充、标准化、去极值等步骤。
- 生成样本:调用
dataset.prepare()得到DataFrame或Tensor。
下面是一个典型配置片段:
data_handler_config = {
    "start_time": "2015-01-01",
    "end_time": "2022-12-31",
    "fit_start_time": "2015-01-01",
    "fit_end_time": "2019-12-31",
    "instruments": "csi300",
    "infer_processors": [
        {"class": "RobustZScoreNorm", "kwargs": {"fields_group": "feature"}},
        {"class": "Fillna", "kwargs": {"fields_group": "feature"}}
    ],
    "learn_processors": [
        {"class": "DropnaLabel"},
        {"class": "CSZScoreNorm", "kwargs": {"fields_group": "label"}}
    ]
}注意fit_start_time与fit_end_time:它们限定预处理参数的拟合区间。标准化均值、方差只能来自训练段,否则测试集信息会泄漏到训练中。
三、特征工程与数据集划分
Qlib的特征工程围绕“字段组”组织,常见分组为feature和label。特征可以来自原始行情,也可以由表达式派生。例如:
- 动量类:
Ref($close,20)/$close-1 - 波动类:
Std($close,20)/Mean($close,20) - 量价类:
Corr($close,$volume,10) - 标签类:
Ref($close,-2)/Ref($close,-1)-1(未来两日收益)
数据集划分必须严格按时间切分。Qlib的DatasetH接受segments字典:
segments = {
    "train": ("2015-01-01", "2019-12-31"),
    "valid": ("2020-01-01", "2020-12-31"),
    "test":  ("2021-01-01", "2022-12-31")
}
下表总结了各阶段的职责与常见误区:
| 阶段 | 时间范围 | 主要职责 | 常见误区 |
|---|---|---|---|
| 训练集 | 较早年份 | 拟合模型参数与预处理参数 | 用全量数据拟合标准化参数 |
| 验证集 | 中间年份 | 调参、早停、模型选择 | 反复调参导致过拟合验证集 |
| 测试集 | 最近年份 | 最终评估,只跑一次 | 根据测试结果反向修改特征 |
四、案例与复盘:一个信息泄漏的典型场景
假设你想构建“过去20日收益率”特征,并直接使用CSZScoreNorm做横截面标准化。如果标准化在全部时间段上计算,那么2015年的均值会包含2022年的信息,模型在训练时“偷看”了未来。正确做法是:在learn_processors中只对训练段拟合,再应用到验证和测试段。
infer_processors和learn_processors。前者用于推理阶段(如填充缺失),后者涉及统计量拟合(如标准化),必须严格限制拟合区间。另一个常见问题是标签对齐。若标签表达式为Ref($close,-2)/Ref($close,-1)-1,则最后两个交易日的样本标签为空。Qlib会自动丢弃这些样本,但你需要确认DropnaLabel已启用,否则空标签会污染损失函数。
复盘时建议检查三点:第一,训练、验证、测试的时间段是否严格递增且无重叠;第二,所有涉及统计量的处理器是否只在训练段拟合;第三,特征表达式中是否误用了未来函数,例如Ref($close,-1)出现在特征而非标签中。
data_handler_config中把fit_start_time和fit_end_time显式设置为训练段起止,这是防止信息泄漏最直接的一步。