1. 课程导入
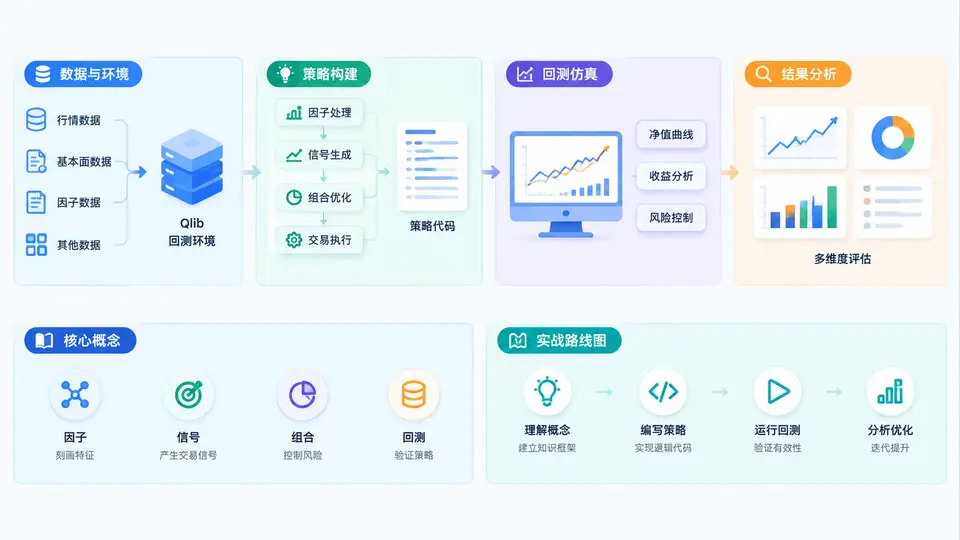
欢迎进入《Qlib组合策略与回测实战》。在正式动手写策略之前,我们需要先建立一张清晰的“地图”:这门课要解决什么问题、Qlib在其中扮演什么角色、组合策略与回测之间的边界在哪里,以及我们将沿着怎样的路线从零走到可复现的实战结果。本章不涉及复杂代码,但会决定你后续三十章的学习效率。
一、学习目标:从“会跑示例”到“能交付策略”
很多量化初学者能跑通Qlib官方示例,却无法独立完成一个可解释、可复现、可评估的组合策略。本课程的目标不是让你记住若干API,而是让你具备一条完整的工程化能力链。具体而言,完成本课程后,你应当能够:
- 理解Qlib的数据组织方式:掌握表达式引擎、数据集划分、特征与标签的构造逻辑,知道数据从哪里来、如何被策略消费。
- 独立构建组合策略:能够基于打分、排序、筛选、权重分配四步法,写出可运行的选股与组合构建流程。
- 正确执行回测:理解回测配置、交易成本、调仓频率、基准与评估指标之间的关系,避免“回测很美、实盘很惨”。
- 完成策略复盘与迭代:能够阅读回测报告,定位收益来源与风险暴露,并据此调整策略参数或逻辑。
一句话概括:本课程培养的是“能把想法变成可回测组合策略,并能解释结果”的实战能力,而不是单纯的工具使用能力。
二、核心概念:组合策略与回测的四个关键词
在Qlib语境下,组合策略与回测涉及大量术语。为了避免后续章节反复解释,这里先锁定四个最核心的概念。
| 概念 | 含义 | 在Qlib中的典型载体 | 常见误解 |
|---|---|---|---|
| 因子/特征 | 用于描述股票某方面属性的数值,如动量、估值、波动率 | 表达式引擎、特征数据集 | 把因子直接等同于策略 |
| 打分与排序 | 将多个因子合成为每只股票的预期收益分数,并排序 | 模型输出、打分函数 | 认为排序越复杂越好 |
| 组合构建 | 根据排序结果决定买什么、买多少、何时调仓 | 策略类、权重分配逻辑 | 忽略仓位约束与交易成本 |
| 回测 | 在历史数据上模拟策略交易并计算绩效 | 回测执行器、评估指标 | 把回测收益当作未来收益 |
这四个概念构成一条链:特征 → 打分 → 组合 → 回测。任何一环出错,最终结果都不可信。后续章节会逐一展开,但你现在就要建立“链条思维”,而不是孤立地看待某个模型或某个指标。
三、整体框架:Qlib组合策略的工程结构
Qlib的设计哲学是“数据、模型、策略、回测”分层解耦。理解这个分层,你就能知道每一章在整体中的位置。一个典型的Qlib组合策略工程包含以下层次:
- 数据层:负责原始行情、财务数据、特征数据的存储与读取,核心是表达式引擎和数据集划分。
- 模型层:负责从特征到打分的映射,可以是线性模型、树模型或深度学习模型。
- 策略层:负责将打分转化为持仓,包括选股规则、权重分配、调仓逻辑。
- 回测层:负责模拟交易、计算收益、生成报告,并处理交易成本与滑点。
- 评估层:负责计算年化收益、最大回撤、夏普比率、信息比率等指标,并支持归因分析。
学习建议:不要试图一次性记住所有API。先理解每一层的职责与输入输出,再在实战中逐步填充细节。框架清晰后,API只是查文档的问题。
为了更直观地展示这条链路,下面用一张简图概括从数据到评估的完整流程。图中每个节点都对应后续章节的核心内容。
四、实战路线图:三十章如何推进
本课程共三十章,整体遵循“先建认知、再搭环境、后做策略、终复盘”的节奏。你可以把它理解为四个阶段:
- 第一阶段(第1-6章)认知与环境:建立组合策略与回测的基本认知,完成Qlib环境搭建、数据准备与第一个可运行示例。
- 第二阶段(第7-16章)策略构建:深入特征工程、打分模型、选股规则、权重分配与调仓逻辑,逐步搭建完整策略。
- 第三阶段(第17-24章)回测与评估:配置回测参数、处理交易成本、阅读回测报告、计算风险指标并进行归因分析。
- 第四阶段(第25-30章)实战与复盘:完成端到端实战项目,进行策略复盘、参数敏感性分析与常见误区总结。
这条路线图的核心逻辑是:先让策略跑起来,再让策略跑得对,最后让策略跑得稳。很多学习者卡在“跑起来”之后就直接追求高收益,忽略了“跑得对”和“跑得稳”,最终得到不可复现的结果。本课程会反复强调可复现性与可解释性。
五、常见误区与复盘:开始之前先避坑
在正式进入实战之前,先列出初学者最容易踩的五个坑。这些误区会在后续章节中反复出现,提前建立警惕意识,能显著减少无效调试时间。
- 把回测当预测:回测是历史模拟,不是未来保证。任何策略都有失效可能,回测的作用是验证逻辑与评估风险,而不是承诺收益。
- 忽略交易成本:高频调仓策略在扣除手续费与滑点后,收益可能由正转负。回测配置中必须显式设置成本参数。
- 数据泄露:使用未来信息构造特征或标签,会导致回测虚高。Qlib的数据集划分机制正是为了避免这一问题。
- 过拟合参数:在历史数据上反复调参直到收益曲线完美,往往意味着策略只记住了噪声。需要保留样本外验证。
- 只看收益不看风险:最大回撤、波动率、换手率同样重要。一个高收益高回撤的策略,实盘中很难坚持执行。
特别提醒:本课程所有示例仅用于教学,不构成任何投资建议。回测结果受数据质量、参数选择、市场环境等多重因素影响,请勿直接将课程示例用于实盘交易。
最后,用一段伪代码概括本课程要完成的端到端流程。你不需要现在看懂每一行,但可以感受一下从数据到评估的完整闭环:
# 伪代码:Qlib组合策略端到端流程
data = load_qlib_data(market="csi300", start="2018-01-01", end="2023-12-31")
features = build_features(data, expressions=["Ref($close,20)/$close-1", "($close-$open)/$open"])
model = train_model(features, label="Ref($close,-5)/$close-1")
scores = model.predict(features)
portfolio = build_portfolio(scores, top_k=50, weight="equal")
backtest = run_backtest(portfolio, cost=0.001, freq="weekly")
report = evaluate(backtest, metrics=["annual_return", "max_drawdown", "sharpe"])
print(report)