3. 混淆矩阵详解
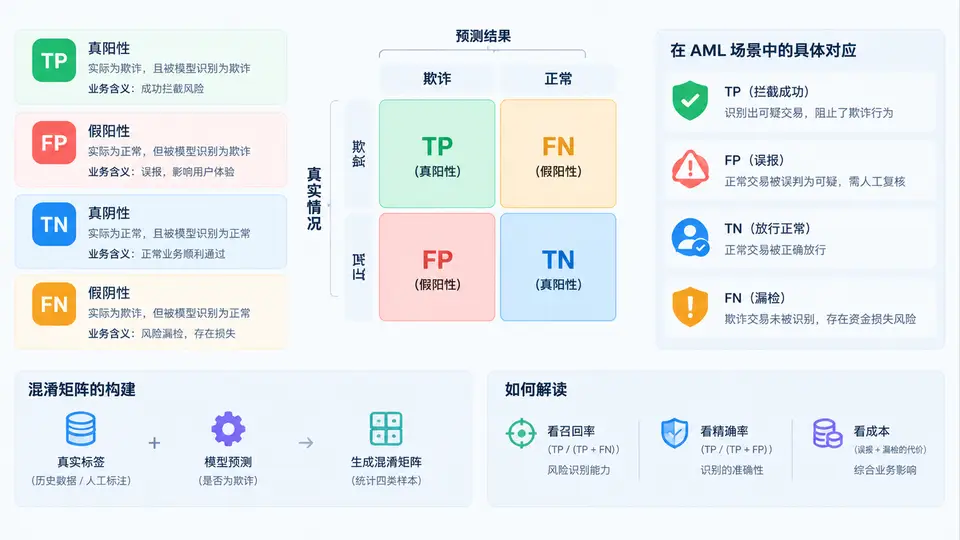
在反洗钱(AML)交易监测中,模型上线后最常被问到的问题不是“准确率多少”,而是“抓对了多少、误报多少、漏放多少”。混淆矩阵正是回答这三个问题的底层工具。它把模型预测结果与真实标签交叉排列,形成四个基础计数单元,是所有分类评估指标(Precision、Recall、F1、FPR等)的源头。
一、四个基础单元的定义
设正类(Positive)代表“可疑交易/需上报”,负类(Negative)代表“正常交易”。模型对每笔交易输出一个预测标签,与人工尽调或监管认定后的真实标签比对,得到:
- TP(True Positive,真阳性):真实可疑,模型也判为可疑。这是模型成功拦截或标记的风险案件。
- FP(False Positive,假阳性):真实正常,模型误判为可疑。这就是AML团队每天要处理的“误报/告警噪音”。
- TN(True Negative,真阴性):真实正常,模型也判为正常。这是被正确放行的低风险交易。
- FN(False Negative,假阴性):真实可疑,模型却判为正常。这是最危险的漏报,可能导致监管处罚与声誉损失。
记忆口诀:第二个字母代表模型判断(P=判可疑,N=判正常);第一个字母代表判断是否正确(T=对,F=错)。因此 FP 是“判错了,判成可疑”,FN 是“判错了,判成正常”。
二、AML场景中的具体对应
把上述定义映射到AML业务流,可以得到非常具体的操作含义:
| 单元 | 模型输出 | 真实情况 | AML业务动作 | 成本/风险 |
|---|---|---|---|---|
| TP | 告警 | 确属可疑 | 提交STR/SAR、冻结或加强尽调 | 合规成本,但必要 |
| FP | 告警 | 正常交易 | 分析师逐笔排查后关闭 | 人力成本、客户体验损耗 |
| TN | 放行 | 正常交易 | 无人工介入,正常清算 | 接近零边际成本 |
| FN | 放行 | 确属可疑 | 漏报,事后被监管或审计发现 | 罚款、牌照风险、声誉损失 |
在真实AML系统中,TP和FN的数量通常远小于FP和TN。一笔可疑交易可能对应成千上万笔正常交易,因此混淆矩阵往往呈现极度不平衡的形态。这也解释了为什么“准确率”在AML场景中几乎没有意义——把所有交易都判为正常,准确率仍可能高达99.9%,但FN会全部漏掉。
三、混淆矩阵的构建流程
构建一个可用于成本评估的混淆矩阵,需要严格对齐预测与标签的时间窗口和粒度。推荐流程如下:
- 确定评估单元:以“交易”还是“客户/账户”为一行?AML中两者都常见,但必须统一,否则TP/FP会重复计数。
- 确定正类定义:是“最终上报STR”,还是“进入人工调查队列”?定义不同,TP和FP的边界会整体移动。
- 对齐时间窗口:模型在T日输出的告警,必须与T+调查周期结束后的真实结论比对,避免用未来信息污染标签。
- 生成预测标签:将模型分数按阈值二值化,得到0/1预测。
- 交叉计数:用真实标签与预测标签做交叉表,得到TP、FP、TN、FN四个数。
- 派生指标:基于四个计数计算Precision、Recall、FPR等,进入成本评估。
import pandas as pd
from sklearn.metrics import confusion_matrix

# y_true: 1=真实可疑, 0=真实正常
# y_pred: 1=模型告警, 0=模型放行
cm = confusion_matrix(y_true, y_pred, labels=[1, 0])
tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()

print(f"TP={tp}, FP={fp}, TN={tn}, FN={fn}")
precision = tp / (tp + fp)
recall    = tp / (tp + fn)
fpr       = fp / (fp + tn)
print(f"Precision={precision:.3f}, Recall={recall:.3f}, FPR={fpr:.3f}")
在AML项目中,建议把混淆矩阵的四个计数与“单笔调查成本”“漏报平均损失”一起记录在模型评估报告中。这样矩阵不只是统计表,而是直接可换算成金额的成本模型输入。
四、案例解读与常见误区
假设某银行一个月内模型输出如下混淆矩阵:TP=120,FP=3800,TN=996000,FN=30。表面看Recall=120/(120+30)=80%,Precision=120/(120+3800)≈3.06%。这意味着每抓到一个真实可疑案件,分析师要处理约32个误报。若单笔调查成本为50元,仅FP就带来19万元/月的人力消耗;而30个FN若对应平均监管损失50万元,则潜在风险达1500万元。此时是否调整阈值,就变成一道可量化的成本题,而不是凭感觉调参。
误区一:只看Precision或Recall单指标。AML中两者天然冲突,必须结合FP成本和FN损失做联合评估。
误区二:混淆矩阵标签定义漂移。如果上个月正类指“进入调查”,这个月改成“最终上报”,四个计数会不可比,趋势分析全部失真。
误区三:忽略样本不平衡。TN极大时,FPR的微小变化会带来FP绝对数量的巨大波动,必须同时看比率和绝对数。
误区四:把FP一律视为浪费。部分FP可能暴露规则盲区或新型洗钱手法,应做FP归因分析,而非简单压缩。
复盘时,建议按“规则/模型版本—阈值—TP/FP/TN/FN—成本”四列做月度追踪。只有把混淆矩阵从静态统计升级为动态成本仪表盘,Precision与Recall的取舍才有业务依据。