1. 课程导入
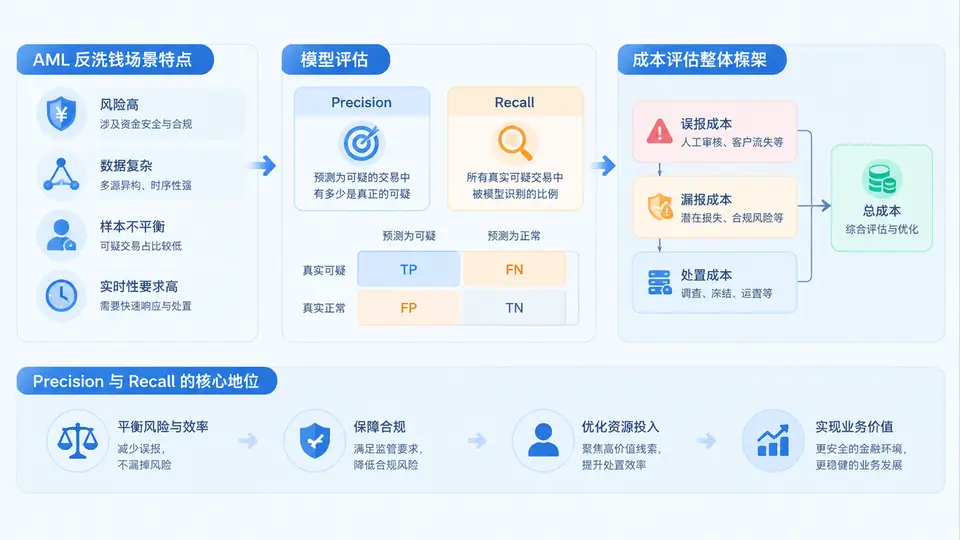
欢迎进入《AML模型Precision Recall与成本评估实战》。在正式动手调参、画PR曲线、算成本之前,我们需要先把一个更根本的问题讲清楚:反洗钱模型到底在解决什么问题,为什么它的评估不能照搬通用机器学习那一套,以及Precision、Recall和成本评估之间到底是什么关系。这一章不写代码,但它决定了你后面29章的学习方向是否正确。
一、AML反洗钱场景的四个本质特点
反洗钱(Anti-Money Laundering,AML)是金融机构识别、监测、报告可疑资金活动的合规体系。它与电商推荐、广告点击、信用评分等常见机器学习场景有显著差异,主要体现在以下四点。
- 极端类别不平衡:真实可疑交易占比通常远低于千分之一,甚至百万分之一。用准确率(Accuracy)评估几乎必然得到“99.9%”的假象,因为全预测为正常也能达到这个数字。
- 标签噪声大且滞后:可疑标签来自人工调查、监管报送和后续案件确认,周期可能长达数月甚至数年。今天的“正常”客户,半年后可能被确认为洗钱团伙成员。
- 代价高度不对称:漏报(False Negative)可能带来监管处罚、声誉损失甚至刑事责任;误报(False Positive)则消耗调查人力、影响客户体验。两者代价相差几个数量级。
- 对抗性持续演化:洗钱手法会针对现有规则和模型主动规避,如拆分交易、多层账户转移、利用虚拟资产。模型必须持续监控和迭代。
二、模型评估为什么是AML的生命线
在AML体系中,模型不是学术演示,而是直接驱动调查队列和监管报送的生产工具。评估失真的后果非常具体:
- 合规风险:如果Recall被高估,实际漏掉大量可疑案件,监管检查时可能被认定为反洗钱体系失效。
- 资源错配:如果Precision过低,调查团队每天处理大量无效警报,真正的高风险案件被淹没,形成“警报疲劳”。
- 模型退化不可见:洗钱模式变化后,若没有持续评估机制,模型可能悄悄失效,而业务方毫无感知。
- 成本失控:调查一条警报的人力成本、系统成本、客户沟通成本都是真实支出,必须被量化并纳入模型决策。
因此,AML模型评估必须同时回答三个问题:抓得全不全(Recall)、抓得准不准(Precision)、抓得值不值(Cost)。
三、Precision与Recall在AML业务中的核心地位
Precision和Recall来自混淆矩阵,是二分类模型最基础的两个指标。但在AML语境下,它们不是抽象数学符号,而是直接对应业务语言。
| 指标 | 公式 | 业务含义 | 代价方向 |
|---|---|---|---|
| Precision(精确率) | TP / (TP + FP) | 发出的警报中,真正可疑的比例 | 低Precision → 调查资源浪费、客户打扰 |
| Recall(召回率) | TP / (TP + FN) | 真实可疑案件中,被模型抓住的比例 | 低Recall → 漏报、监管处罚、声誉损失 |
| F1 | 2PR / (P + R) | Precision与Recall的调和平均 | 综合参考,但不体现成本不对称 |
| Alert Rate | (TP + FP) / 总数 | 警报量占整体交易的比例 | 直接决定调查团队工作量 |
关键认知是:Precision和Recall通常此消彼长。降低阈值可以提升Recall,但会引入更多误报,拉低Precision;提高阈值则相反。AML团队的核心工作,就是在这个权衡曲线上找到业务最优工作点,而不是追求某个单一指标的极值。
四、成本评估的整体框架
Precision和Recall描述的是模型统计表现,但最终决策必须落到“钱”和“人”上。成本评估框架把模型输出转化为可比较的业务代价,通常包含以下四类成本。
- 漏报成本(Cost_FN):未识别的可疑案件导致的监管罚款、案件损失、声誉影响。通常最高,且难以精确估计。
- 误报成本(Cost_FP):每条误报警报的调查人力、系统资源、客户沟通与流失风险。
- 调查容量约束:团队每天能处理的警报数量上限,这是硬约束,决定Alert Rate的天花板。
- 阈值决策成本:不同阈值对应不同TP、FP、FN组合,总成本 = Cost_FN × FN + Cost_FP × FP。
一个简化的成本评估流程可以表示为:
输入:模型分数、真实标签、成本参数
步骤1:按分数排序,遍历候选阈值
步骤2:对每个阈值计算 TP / FP / FN / TN
步骤3:计算总成本 = Cost_FN * FN + Cost_FP * FP
步骤4:叠加调查容量约束(FP + TP <= 每日容量)
步骤5:选择满足约束且总成本最低的阈值
输出:最优阈值、对应Precision、Recall、Alert Rate、总成本
这个框架的价值在于:它把“模型好不好”从主观判断变成可计算、可比较、可复盘的决策问题。后续章节会逐步展开每个环节的实现细节。
五、一个典型场景:为什么不能只看AUC
假设某银行AML模型在测试集上AUC为0.95,看起来很好。但业务上线后发现:
- 每天产生12万条警报,调查团队只能处理3000条;
- 实际调查确认的可疑案件只有约200条;
- 大量真实可疑案件因为分数排在3000名之后被直接忽略。
问题出在哪里?AUC衡量的是整体排序能力,不关心业务阈值附近的表现,也不关心调查容量。真正需要看的是:在Top 3000警报中,Recall是多少?Precision是多少?漏掉的高风险案件成本有多大?这正是Precision、Recall与成本评估要解决的问题。
六、本章小结与学习准备
通过本章,你应该建立以下认知:
- AML场景具有极端不平衡、标签滞后、代价不对称、对抗演化四大特点。
- 模型评估直接关系合规风险、资源分配和成本控制。
- Precision对应调查效率,Recall对应风险覆盖,两者需要权衡。
- 成本评估框架把模型输出转化为可比较的业务代价,并受调查容量约束。
- 不能只看AUC或Accuracy,必须结合业务阈值和成本参数做决策。
接下来,我们将从混淆矩阵和基础指标计算开始,逐步构建完整的AML模型评估与成本优化能力。请确保你已经理解本章的业务逻辑,因为后续每一行代码、每一个参数,都服务于这里建立的框架。