3. 数据获取与清洗
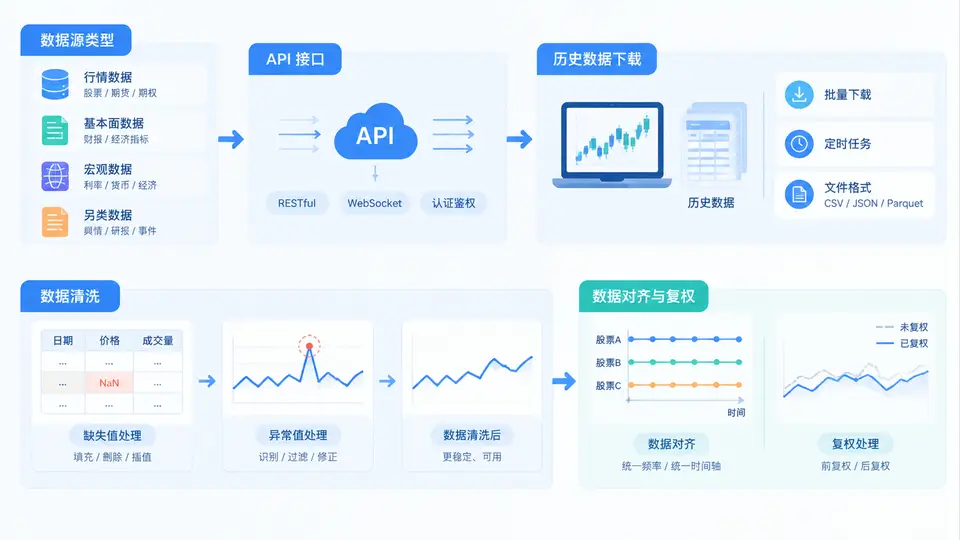
在量化研究与系统化交易中,数据是策略的原材料。无论因子挖掘、回测还是实盘信号生成,数据质量直接决定研究结论的可信度。本章围绕数据获取与清洗的完整链路展开,覆盖数据源类型、API接口调用、历史数据下载、缺失值与异常值处理,以及数据对齐与复权五个关键环节。
一、核心原理:数据源类型与选择逻辑
量化数据源大致可分为四类:行情数据(OHLCV、tick、盘口)、基本面数据(财报、估值、股本)、另类数据(舆情、卫星、供应链)和衍生数据(因子库、指数成分、行业分类)。不同数据源的获取方式、更新频率、历史深度和成本差异显著。
| 数据源类型 | 典型内容 | 获取方式 | 主要风险 |
|---|---|---|---|
| 交易所/官方 | 日线、tick、公告 | 官网下载、FTP | 格式不统一、接口变动 |
| 商业数据商 | 复权行情、财务数据 | API、终端导出 | 费用高、字段口径差异 |
| 开源社区 | A股/日线、加密行情 | Python库、HTTP接口 | 稳定性差、限流、停更 |
| 自建采集 | 另类数据、网页数据 | 爬虫、定时任务 | 合规风险、反爬、维护成本 |
选择数据源时,应优先确认三点:时间戳口径(交易日还是自然日、时区)、复权方式(前复权、后复权、不复权)、字段定义(成交量单位、成交额是否含大宗)。这三点若不一致,后续对齐与回测将出现系统性偏差。
二、方法流程:API接口与历史数据下载
API接口调用通常遵循“认证—请求—解析—落盘”四步。以常见HTTP接口为例,需处理分页、限流与重试。下面是一个带重试与分页的通用下载模板:
import requests, time, pandas as pd

def fetch_pages(url, params, max_retry=3):
    rows, page = [], 1
    while True:
        params["page"] = page
        for i in range(max_retry):
            try:
                r = requests.get(url, params=params, timeout=10)
                r.raise_for_status()
                data = r.json().get("data", [])
                break
            except Exception as e:
                if i == max_retry - 1:
                    raise
                time.sleep(2 ** i)
        if not data:
            break
        rows.extend(data)
        page += 1
        time.sleep(0.3)  # 限流保护
    return pd.DataFrame(rows)
历史数据下载建议遵循“增量+全量校验”策略:首次全量拉取,之后按交易日增量更新,并定期用全量快照校验增量结果。落盘时统一使用Parquet或CSV,并保留原始字段与下载时间戳,便于追溯。
三、缺失值与异常值处理
缺失值常见于停牌、新股上市前、接口漏传。处理方式取决于用途:
- 前向填充:适用于价格、估值等连续性指标,但需限制最大填充天数,避免停牌期虚假连续。
- 删除:适用于缺失比例低且随机的情况,但可能引入幸存者偏差。
- 标记不填充:在因子计算中保留NaN,由后续模型处理,避免人为制造信息。
异常值检测常用MAD(中位数绝对偏差)与分位数截断。相比3σ,MAD对厚尾分布更稳健:
def mad_filter(s, n=5):
    med = s.median()
    mad = (s - med).abs().median()
    return s.where((s - med).abs() <= n * 1.4826 * mad)

# 对收益率做MAD截断,保留正常波动
ret_clean = mad_filter(ret, n=5)
四、数据对齐与复权
多源数据对齐的核心是时间索引统一。常见问题包括:不同市场交易日不同、时区不同、频率不同。建议统一为UTC时间戳,再按目标频率重采样。对于日频数据,使用交易日历对齐,避免自然日填充造成虚假交易日。
复权处理直接影响价格序列的连续性。除权除息会导致价格跳空,若不复权,收益率计算将出现虚假暴跌。前复权保持当前价格真实、历史价格调整;后复权保持历史价格真实、当前价格调整。回测中通常使用后复权,因为它在历史时点上不引入未来信息。
# 以调整因子为例:后复权价格 = 原始价格 * 累计调整因子
df["adj_close"] = df["close"] * df["cum_factor"]
df["adj_ret"] = df["adj_close"].pct_change()
下面用一张图概括从原始数据到可用数据的清洗链路:
五、案例与复盘:一次典型的清洗事故
某策略在回测中表现优异,实盘却持续亏损。复盘发现:回测使用的行情数据来自开源接口,未做复权处理,而实盘信号基于商业数据商的前复权价格。两者在除权日附近产生显著价差,导致信号方向相反。进一步检查发现,该开源接口在停牌期间用前值填充,造成波动率被低估,仓位计算偏大。
修正方案包括:统一使用后复权价格、停牌期不填充价格、对成交量做零值标记、在回测中引入交易日历对齐。修正后回测收益下降约30%,但与实盘表现一致。这说明数据清洗不是预处理,而是策略逻辑的一部分。
综上,数据获取与清洗的目标不是“让数据看起来完整”,而是“让数据在时间、口径和逻辑上可追溯、可复现”。只有在此基础上,后续的因子计算、回测与实盘才具备可信度。