3. 欺诈图谱构建
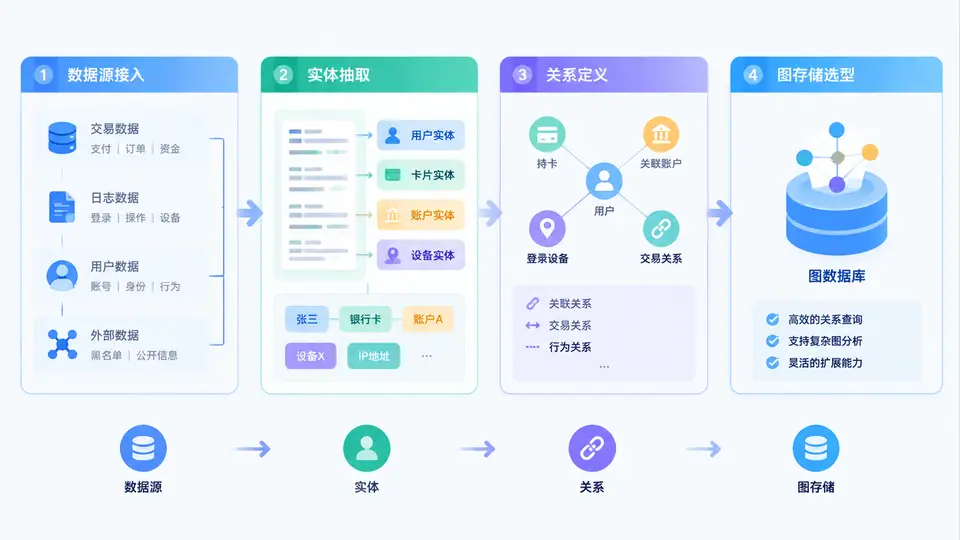
在识别关键欺诈节点之前,必须先有一张“可计算、可追溯、可扩展”的欺诈图谱。图谱构建不是把数据简单导入图数据库,而是围绕欺诈业务问题,把多源异构数据转化为实体—关系—属性的结构化网络。本节围绕四个核心环节展开:数据源接入、实体抽取、关系定义与图存储选型,并给出可落地的工程方法。
一、核心原理:从“记录视角”转向“网络视角”
传统风控系统以申请、交易、设备等单条记录为中心,擅长判断“这一笔是否异常”,却难以回答“这群人是否在协同作案”。欺诈图谱的核心价值在于把分散的记录连接成网络:同一设备被多个账户使用、同一银行卡绑定多个手机号、多个账户共享同一收货地址,这些“共享关系”本身就是强欺诈信号。
因此,图谱构建的本质是完成三次映射:第一,把业务对象映射为节点(用户、设备、卡、IP、商户、地址);第二,把业务行为映射为边(登录、转账、绑定、收货);第三,把行为上下文映射为属性(时间、金额、频次、渠道)。只有映射清晰,后续的中心性计算与关键节点识别才有稳定基础。
构建目标:让每一个欺诈团伙在图中表现为“稠密子图或星型结构”,让关键节点表现为“高中心性、高桥接性、高聚集性”的顶点。
二、方法流程:四步构建可用的欺诈图谱
1. 数据源接入:先定问题,再定数据
数据源接入常见四类:业务系统数据(账户、订单、交易)、风控埋点数据(登录、点击、设备指纹)、外部数据(黑名单、工商、司法)、人工标注数据(案件、举报、工单)。接入时建议采用“批流结合”:历史数据用批量导入,实时行为用消息队列接入。
# 示例:从Kafka接入实时登录事件并写入图数据库
kafka-console-consumer \
  --bootstrap-server broker:9092 \
  --topic risk_login_event \
  --from-beginning \
  --property print.key=true

# 事件样例
{"user_id":"U1024","device_id":"D88","ip":"10.2.3.4","ts":"2024-06-01T10:22:31","action":"login"}
接入阶段要建立数据契约:字段含义、主键、时间格式、脱敏规则、更新频率。否则后续实体对齐会大量返工。
2. 实体抽取:把“字段”变成“节点”
实体抽取的目标是从原始数据中识别出稳定、可区分的业务对象。常用方法有三类:规则映射(如 user_id 直接映射为用户节点)、正则与词典(手机号、银行卡号、身份证号)、模型抽取(从文本工单、聊天记录中抽取人名、账号、地址)。
抽取后必须做实体对齐:同一自然人在不同系统中可能有多个 ID,需要通过手机号、设备指纹、银行卡等强标识进行合并。对齐质量直接决定图谱是否“连通”。
3. 关系定义:边是欺诈信号的主要载体
关系定义要遵循“业务可解释、计算可复用”原则。常见关系包括:登录(用户—设备)、绑定(用户—银行卡)、转账(用户—用户)、收货(用户—地址)、归属(设备—IP)。每条边应携带时间、次数、金额等属性,便于后续做时序与权重分析。
| 关系类型 | 起点 | 终点 | 关键属性 | 欺诈含义 |
|---|---|---|---|---|
| 登录 | 用户 | 设备 | 时间、IP、频次 | 设备共用、团伙登录 |
| 绑定 | 用户 | 银行卡 | 绑定时间、渠道 | 卡池、资金归集 |
| 转账 | 用户 | 用户 | 金额、时间、方向 | 资金环路、洗钱 |
| 收货 | 用户 | 地址 | 次数、时间 | 虚假收货、集中作案 |
4. 图存储选型:按查询模式决定技术栈
图存储选型没有唯一答案,关键看查询模式与规模。若以多跳关系查询、路径分析为主,可选 Neo4j、NebulaGraph、JanusGraph;若需要与大数据生态结合,可选 HugeGraph、TigerGraph;若数据量极大且以离线图计算为主,可用 Spark GraphX 或 Pregel 类框架。
选型建议:中小规模、快速验证优先 Neo4j;超大规模、分布式写入优先 NebulaGraph;已有 Hadoop/Spark 体系优先 HugeGraph 或 GraphX。不要为了“图”而图,先明确查询模式。
三、案例场景:一起“设备共用型”欺诈团伙的图谱构建
某平台发现一批账户在短时间内集中注册并申请提现。原始数据分散在账户表、登录日志、设备指纹表中。构建过程如下:
- 接入账户、登录、设备三张表,统一 user_id 与 device_id 主键。
- 抽取用户节点、设备节点、IP 节点,并对手机号做实体对齐。
- 定义“登录”关系,边属性记录时间与次数。
- 写入图数据库后,执行两跳查询:找出共享同一设备且互相转账的用户群。
// Cypher示例:查找共用设备且存在转账关系的可疑团伙
MATCH (u1:User)-[:LOGIN]->(d:Device)<-[:LOGIN]-(u2:User)
MATCH (u1)-[t:TRANSFER]->(u2)
WHERE u1 <> u2 AND t.amount > 1000
RETURN d.device_id, u1.user_id, u2.user_id, t.amount
ORDER BY t.amount DESC
LIMIT 20;
查询结果中,一个设备关联了 17 个账户,且这些账户之间存在环形转账。该设备节点在后续中心性分析中表现为高介数中心性,成为关键欺诈节点。
四、误区与复盘:构建阶段最容易踩的坑
- 误区一:先建图再想问题。没有明确欺诈场景,图谱会变成“数据仓库的图版本”,无法支撑识别。
- 误区二:实体对齐过度合并。把弱标识(如昵称)当强标识,会把正常用户错误合并,产生虚假团伙。
- 误区三:关系定义过细。边类型过多会导致查询复杂、计算缓慢,建议先定义 5~8 类核心关系。
- 误区四:忽视时序属性。欺诈关系具有强时序性,缺少时间戳会导致无法区分“历史正常”与“当前异常”。
复盘要点:图谱构建完成后,必须做一次“连通性体检”:节点数、边数、孤立节点比例、最大连通子图规模、平均度。若孤立节点过多,说明实体对齐或关系定义不足;若最大连通子图过大,说明合并过度或关系过泛。
只有把数据源、实体、关系与存储四件事做扎实,后续的中心性计算与关键欺诈节点识别才有可靠输入。构建阶段多花一天做对齐与校验,识别阶段就能少走一周弯路。