1. 课程导入
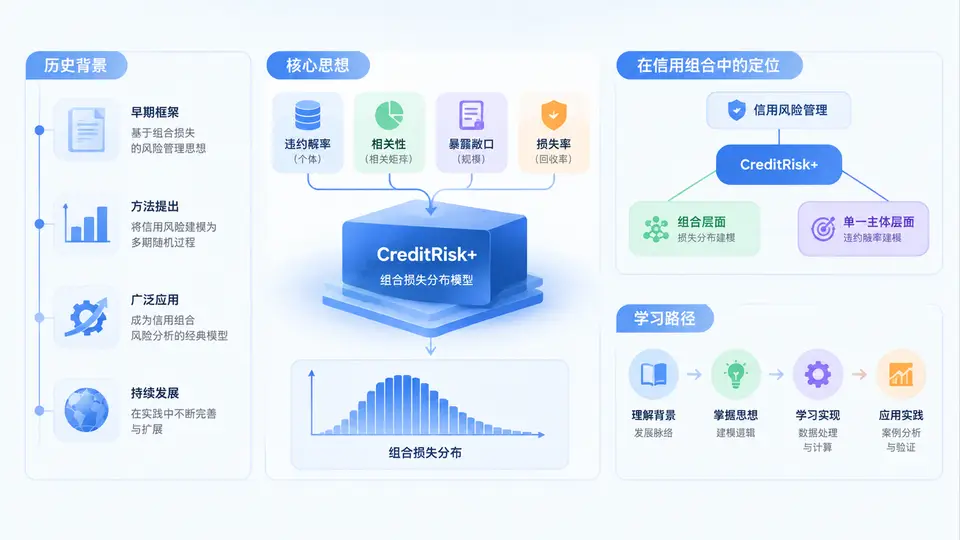
欢迎进入《CreditRisk+信用组合损失分布建模实战》。在正式动手建模之前,我们需要先回答三个问题:CreditRisk+从哪里来?它到底在算什么?学完这门课,你应该具备哪些能力?这一章不涉及复杂公式推导,而是帮你建立一张“认知地图”,让后续30章的学习有明确的坐标。
一、历史背景:从精算视角切入信用风险
CreditRisk+最早由瑞士信贷第一波士顿(CSFB)于1997年发布,是信用风险量化领域最早被广泛采用的组合模型之一。它与CreditMetrics、KMV、CreditPortfolioView并称为“四大信用风险组合模型”。理解它的出身非常关键:CreditRisk+并不是从企业资产结构或违约相关性出发,而是借鉴了财产保险中的精算损失模型——把贷款组合看作一份保单组合,把违约看作保险赔付事件。
这一视角带来了两个直接结果。第一,模型只关注“违约”与“不违约”两种状态,不涉及信用评级迁移,因此结构轻、参数少、计算快。第二,它用泊松分布刻画违约事件的发生频率,用违约损失暴露刻画单笔损失的严重程度,从而把组合损失分布的计算转化为可解析、可递推的问题。正因如此,CreditRisk+在银行经济资本计量、贷款定价和组合限额管理中长期占有一席之地。
二、核心思想:用频率与严重度合成损失分布
CreditRisk+的核心思想可以用一句话概括:组合损失分布 = 违约频率分布 × 违约损失严重度分布。具体而言,模型假设每笔债务在给定时间内违约次数服从泊松分布,违约概率由债务人所属风险因子的违约率决定;一旦违约,损失金额等于违约暴露乘以违约损失率。由于不同债务的违约事件被假设为相互独立(在给定风险因子条件下),组合损失分布可以通过概率生成函数和递推算法高效求解。
这里有一个容易被忽视但非常重要的点:CreditRisk+并不直接模拟每笔债务的违约相关性,而是通过风险因子间接引入相关性。例如,同一行业内的企业共享一个行业违约率因子,当该因子波动时,行业内多笔债务会同时趋向违约。这种“条件独立”的处理方式,既保留了相关性来源,又避免了高维联合分布的复杂性。
三、方法流程:从数据到损失分布的五步法
在实战中,CreditRisk+的建模流程可以归纳为五个步骤。理解这个流程,有助于你在后续章节中把每个模块放到正确的位置。
- 数据准备:整理债务敞口、违约率、违约损失率、风险因子映射关系。数据质量直接决定模型可信度。
- 风险因子划分:按行业、区域或评级将债务分组,确定每组对应的违约率均值和波动率。
- 频率与严重度参数化:将每笔债务的违约概率转换为泊松强度,将损失金额按“损失单位”离散化。
- 组合损失分布递推:利用概率生成函数和递推公式,从单笔债务逐步合成整个组合的损失分布。
- 结果解读与应用:计算预期损失、非预期损失、经济资本和风险贡献,用于定价、限额和资本配置。
| 步骤 | 关键输入 | 核心输出 | 常见工具 |
|---|---|---|---|
| 数据准备 | 敞口、违约率、LGD | 清洗后的债务清单 | SQL / Python pandas |
| 风险因子划分 | 行业、区域标签 | 因子映射表 | Excel / Python |
| 参数化 | 均值、波动率 | 泊松强度、损失单位 | Python / R |
| 递推求解 | 概率生成函数 | 损失分布表 | Python / MATLAB |
| 结果应用 | 损失分布 | EL、UL、经济资本 | BI / 报表系统 |
四、案例场景:一笔贷款组合的快速估算
假设某银行有一个包含100笔企业贷款的组合,总敞口为10亿元。按照行业划分为制造业、批发零售和信息技术三个风险因子。制造业违约率均值为1.2%,波动率为0.4%;批发零售违约率均值为0.8%,波动率为0.3%;信息技术违约率均值为0.5%,波动率为0.2%。每笔贷款的违约损失率统一假设为45%。
在CreditRisk+框架下,我们不需要逐笔模拟100笔贷款的联合违约状态,而是先将每笔贷款的损失金额按“损失单位”离散化,例如以100万元为一个单位,然后利用递推公式计算组合损失为0、1、2……个单位的概率。最终可以得到一条完整的损失分布曲线,并据此计算99.9%置信水平下的经济资本。
# 伪代码示意:CreditRisk+递推核心逻辑
loss_unit = 1_000_000  # 每个损失单位100万元
exposure = [50_000_000, 30_000_000, ...]  # 各笔敞口
lgd = 0.45
pd_by_factor = {"制造": 0.012, "批发": 0.008, "IT": 0.005}

# 将每笔损失转换为整数个损失单位
loss_units = [round(e * lgd / loss_unit) for e in exposure]

# 递推计算组合损失分布
prob = [0.0] * (sum(loss_units) + 1)
prob[0] = 1.0
for i, units in enumerate(loss_units):
    new_prob = [0.0] * len(prob)
    for j in range(len(prob)):
        if prob[j] == 0:
            continue
        # 未违约
        new_prob[j] += prob[j] * (1 - pd_by_factor[factor[i]])
        # 违约,损失增加units个单位
        if j + units < len(new_prob):
            new_prob[j + units] += prob[j] * pd_by_factor[factor[i]]
    prob = new_prob

# 输出99.9%分位数对应的损失
cum = 0.0
for k, p in enumerate(prob):
    cum += p
    if cum >= 0.999:
        print(f"99.9%经济资本对应损失单位: {k}, 金额: {k * loss_unit}")
        break
五、常见误区与复盘要点
初学者在学习CreditRisk+时,最容易陷入以下误区。提前了解它们,可以让你在后续实战中少走弯路。
- 误区一:把CreditRisk+当成评级迁移模型。它只处理违约/不违约两状态,不输出评级迁移矩阵。如果你需要迁移风险,应转向CreditMetrics等模型。
- 误区二:忽略风险因子的波动率。只输入平均违约率而不输入波动率,会严重低估尾部损失,导致经济资本不足。
- 误区三:损失单位划分过粗。损失单位过大,递推结果分辨率不足;过小则计算量爆炸。需要在精度和效率之间做权衡。
- 误区四:把条件独立当成完全独立。CreditRisk+的相关性来自风险因子,若因子划分不合理,组合分散化效果会被高估或低估。
六、学习路径:从理解到实战的路线图
本课程共30章,整体遵循“先建认知、再学方法、后做实战”的路径。第1章帮你建立历史背景和核心思想;第2至第8章深入讲解泊松分布、概率生成函数、风险因子建模和递推算法;第9至第18章进入参数估计、数据清洗、损失单位选择和数值稳定性处理;第19至第26章通过完整案例演示从数据到经济资本的全流程;第27至第30章讨论模型验证、压力测试、监管应用和常见陷阱。
如果你希望从这门课中获得最大收益,建议按以下方式学习:每章先理解核心概念,再动手运行代码,最后用自己的数据做一次小规模复现。CreditRisk+是一个“看起来简单、细节很多”的模型,真正的掌握来自反复调试和结果对比,而不是记住公式。
现在,你已经有了这张认知地图。接下来,我们将从泊松分布和违约频率建模开始,逐步拆解CreditRisk+的数学内核。