1. 课程导入
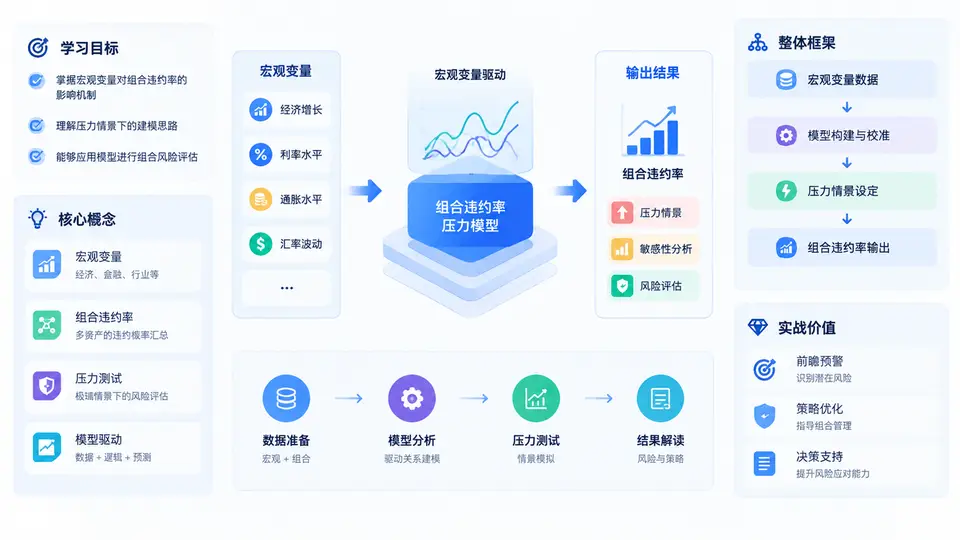
在信用风险管理中,组合违约率并不是一个孤立指标,它同时受到借款主体财务状况、行业景气度、区域经济环境以及宏观金融条件的共同影响。当经济扩张时,企业现金流改善,违约率通常下行;当货币政策收紧、需求收缩或资产价格下跌时,违约概率会快速抬升。因此,仅依赖历史平均违约率或静态评级迁移矩阵,往往无法回答一个关键问题:如果未来宏观环境显著恶化,我的组合违约率会上升到什么水平?这正是本课程要解决的核心问题。
本课程围绕“宏观变量驱动组合违约率压力模型”展开,目标不是简单介绍某个公式,而是建立一套从宏观情景设定、变量筛选、模型构建、压力传导到结果解读的完整工作流。学完本课程后,你应当能够独立完成一个可解释、可复现、可用于内部风险报告与监管沟通的压力测试原型。
学习目标
- 理解宏观变量与组合违约率之间的传导逻辑,区分同步指标、领先指标与政策变量。
- 掌握卫星模型(Satellite Model)的基本思想:用宏观因子解释违约率,再将宏观情景映射为违约率路径。
- 能够构建基准情景与压力情景,并完成从GDP、利率、失业率、房价指数等变量到违约率的量化传导。
- 掌握模型验证与复盘方法,识别过拟合、变量共线性、样本期偏差等常见问题。
- 能够将模型输出转化为风险限额、拨备测算、资本充足评估等管理决策语言。
核心概念
在进入建模之前,需要先统一几个关键概念。第一,组合违约率通常指某一资产组合在特定时间窗口内的违约暴露占比,可以是年度违约率,也可以是季度年化违约率。第二,宏观变量是模型的外生输入,常见包括实际GDP增速、CPI、PPI、失业率、政策利率、十年期国债收益率、房价指数、社会融资规模等。第三,压力情景不是简单取历史最差值,而是基于经济逻辑设定的一组宏观路径,例如“GDP增速连续两年低于潜在增速、失业率上升3个百分点、房价下跌15%”。第四,传导机制描述宏观冲击如何通过企业盈利、偿债能力、抵押品价值等渠道影响违约率。
核心公式框架:违约率 = f(宏观因子, 组合特征, 滞后项) + 误差项。其中f通常采用线性回归、逻辑回归或面板模型,滞后项用于捕捉传导时滞。
整体框架
本课程的整体框架分为五层。第一层是数据层,负责收集宏观时间序列与组合违约率数据,并进行频率对齐、缺失值处理和异常值修正。第二层是变量层,通过相关性分析、格兰杰因果检验和业务逻辑筛选候选宏观变量。第三层是模型层,构建卫星模型,将宏观变量映射为违约率。第四层是情景层,设计基准、温和压力、严重压力等情景,并生成宏观路径。第五层是应用层,将违约率输出转化为拨备、资本和经济资本占用。
| 层级 | 主要任务 | 典型输出 |
|---|---|---|
| 数据层 | 数据清洗、频率对齐、缺失值处理 | 建模用宽表 |
| 变量层 | 相关性、因果检验、共线性诊断 | 候选宏观变量清单 |
| 模型层 | 卫星模型拟合、滞后阶数选择 | 违约率预测方程 |
| 情景层 | 基准与压力情景设定 | 宏观路径矩阵 |
| 应用层 | 拨备、资本、限额测算 | 风险报告与决策建议 |
案例场景:为什么需要压力模型
假设某银行零售贷款组合当前年化违约率为1.8%。如果仅看历史数据,过去十年最高值为3.2%,那么很容易得出“极端情况下违约率约3.5%”的结论。但若宏观情景设定为:GDP增速从5%降至2%,失业率从5%升至8%,房价下跌20%,此时企业裁员、居民收入下降、抵押品价值缩水,违约率可能远超历史最高值。压力模型的价值就在于,它不依赖“历史会重复”的假设,而是通过宏观变量与违约率的量化关系,推演未发生但可能发生的极端情景。
实战提示:压力情景的设计应包含“冲击幅度、持续时间、传导速度”三个维度。仅设定一个低GDP值,而不说明持续多久,模型输出会严重失真。
常见误区与复盘
- 误区一:直接用历史最大违约率作为压力结果。历史最大値受样本期限制,未必覆盖未来极端情景。
- 误区二:忽略滞后效应。宏观冲击传导到违约率通常有2至4个季度时滞,模型需包含滞后项。
- 误区三:变量过多导致过拟合。宏观变量之间高度相关,应优先选择经济逻辑清晰、统计显著的少数变量。
- 误区四:把相关性当因果。卫星模型是统计关系,不是结构因果模型,解释时需保持谨慎。
- 误区五:压力情景与业务脱节。情景设定应结合组合特征,例如房地产贷款组合应重点关注房价与利率,而不是单纯看CPI。
实战价值
掌握本课程内容后,你可以在多个场景中直接应用。第一,在年度预算与风险偏好设定中,用压力模型测算不利情景下的违约率上限,倒推风险限额。第二,在IFRS 9或预期信用损失模型中,将宏观情景作为前瞻性信息输入,提升拨备计提的合理性。第三,在监管压力测试中,快速生成宏观情景到违约率的传导结果,支持资本充足率评估。第四,在组合管理中,识别对宏观变量最敏感的资产类别,优化行业与区域配置。
注意:压力模型输出的是“条件预测”,不是“精确预言”。它的价值在于提供一致、可解释、可复现的量化框架,而不是追求小数点后的绝对准确。
本章作为课程导入,已经勾勒出宏观变量驱动组合违约率压力模型的学习地图。接下来,课程将沿着数据准备、变量筛选、模型构建、情景设计和应用落地逐步展开,每一章都会配套可运行的代码片段与业务案例,帮助你把方法论转化为实际能力。