3. 风控数据的时间特性
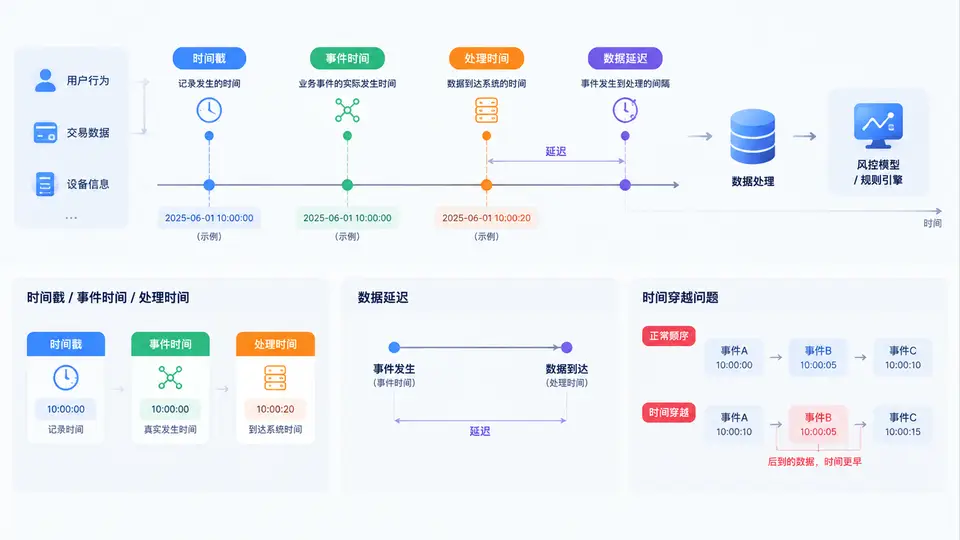
在风控建模与特征工程中,时间不是普通字段,而是决定样本是否合法、特征是否可用、模型是否可信的“第一约束”。很多线上事故并非模型算法不够强,而是时间语义被混淆:把未来信息带进了训练集,或者把延迟到达的数据误当成实时数据。本章围绕四个核心概念展开:时间戳、事件时间、处理时间,以及由它们衍生出的数据延迟与时间穿越问题。
一、核心原理:四种时间语义必须分清
风控数据在流转过程中,至少会涉及以下时间概念:
- 时间戳(Timestamp):数据记录上附带的某个时间值,可能来自业务系统、日志系统或数据库。它只是一个“数值”,并不自动说明它代表什么语义。
- 事件时间(Event Time):业务事件真实发生的时刻。例如用户点击借款申请、设备首次出现、订单支付成功。事件时间由业务发生端产生,是风控特征计算最应依赖的时间基准。
- 处理时间(Processing Time):数据被计算引擎、特征平台或模型服务实际处理的时刻。它通常晚于事件时间,受采集、传输、队列、批处理调度影响。
- 数据延迟(Data Latency):事件时间与处理时间之间的差值。延迟可能是秒级、分钟级,也可能是小时级甚至天级。
时间穿越(Time Travel)则是指:在训练样本或特征计算中,使用了“在预测时刻尚未可知”的信息。它通常不是显式错误,而是由时间语义混淆、延迟补偿不当或特征回填逻辑不严谨造成。
一句话原则:任何用于训练的特征,只能使用“在样本决策时刻已经真实到达系统”的数据;任何用于线上推理的特征,只能使用“在推理请求发起时已经可用”的数据。
二、方法流程:从时间语义到样本切分
要避免时间穿越,需要把时间语义落实到数据管道的每一步。推荐流程如下:
- 标注时间字段语义:在数据字典中明确每个时间字段是事件时间还是处理时间,禁止使用模糊命名如“create_time”“update_time”而不加说明。
- 确定样本决策时刻:每个训练样本必须有一个明确的“决策时间点”,例如申请提交时间、授信审批发起时间。
- 按事件时间对齐特征:特征计算窗口应以事件时间为轴,只聚合决策时刻之前发生的事件。
- 引入处理时间做可用性校验:即使事件发生在决策时刻之前,如果处理时间晚于决策时刻,该数据在线上也不可用,训练时同样不能使用。
- 处理延迟与乱序:对延迟到达的数据,要么在特征回填时按处理时间截断,要么在训练样本中显式排除,不能默认“晚到但事件时间早”就可用。
- 做时间穿越审计:定期对比训练特征与线上特征在同一决策时刻的取值差异,定位穿越来源。
下面是一个特征回填时按“事件时间 + 处理时间”双重约束过滤的伪代码示例:
def build_feature(event_stream, decision_time):
    # 只保留事件时间在决策时刻之前的事件
    valid_events = [
        e for e in event_stream
        if e.event_time <= decision_time
    ]
    # 再过滤掉处理时间晚于决策时刻的数据
    valid_events = [
        e for e in valid_events
        if e.process_time <= decision_time
    ]
    return aggregate(valid_events)
这段逻辑的关键在于第二个过滤条件。很多团队只做了第一个条件,结果把“事件时间早、但系统很晚才收到”的数据也用于训练,导致离线指标虚高、线上效果骤降。
三、案例/场景:延迟与穿越如何制造“假信号”
假设某现金贷风控场景中,有一个特征叫“近7天多头申请次数”。事件时间是用户在其他平台发起申请的时间,处理时间是我方数据供应商将这条记录推送到特征平台的时间。
| 用户 | 事件时间 | 处理时间 | 决策时刻 | 训练是否可用 | 原因 |
|---|---|---|---|---|---|
| A | 10:00 | 10:02 | 10:05 | 可用 | 事件与处理均早于决策 |
| B | 10:01 | 10:08 | 10:05 | 不可用 | 处理时间晚于决策,线上拿不到 |
| C | 10:06 | 10:07 | 10:05 | 不可用 | 事件时间晚于决策,属于未来信息 |
用户B是最容易被忽略的情况:事件发生在决策之前,看起来“应该能用”,但系统实际收到时决策已经结束。如果训练时用了B,模型会学到“多头申请多的人风险更高”这一规律,但线上推理时这类数据还没到,特征值为空或为0,模型行为与训练严重不一致。
典型误区:用离线数仓的“分区日期”代替事件时间。分区日期通常是处理时间或入库时间,用它切分样本会把延迟数据错误地归入更早的窗口,造成时间穿越。
四、误区/复盘:时间穿越的常见来源
时间穿越很少以“直接读取未来标签”这种明显形式出现,更多是隐蔽的工程细节。常见来源包括:
- 特征回填使用最新快照:例如用户职业、授信额度等慢变字段,回填时取了当前最新值,而不是决策时刻的历史值。
- 聚合窗口边界不清:使用“近7天”时未明确是左闭右开还是左闭右闭,导致决策时刻当天的事件被提前纳入。
- 标签泄漏:用未来才产生的逾期标签去构造“当前是否高风险”的特征,或标签定义窗口与特征窗口重叠。
- 处理时间被忽略:只按事件时间过滤,未考虑数据到达延迟,导致线上不可用的数据进入训练。
- 时区不一致:事件时间用UTC,处理时间用本地时间,窗口切分时出现数小时偏移。
复盘时建议做一次“时间穿越审计”:随机抽取若干训练样本,分别用事件时间和处理时间重算特征,对比差异率。如果差异率超过阈值,说明管道中存在时间语义问题。审计结果应记录到特征平台的元数据中,作为后续特征上线的强制检查项。
实践建议:在特征平台中为每个特征标注“时间语义类型”和“最大可容忍延迟”。训练样本生成时,系统自动按决策时刻和延迟约束过滤数据,从流程上杜绝时间穿越,而不是依赖工程师手工检查。
理解时间戳、事件时间、处理时间、数据延迟与时间穿越,是风控样本窗口切分的基础。只有把时间语义落实到数据采集、特征计算、样本生成和线上推理的每一环,训练出的模型才具备真实的线上泛化能力。