1. 课程导入
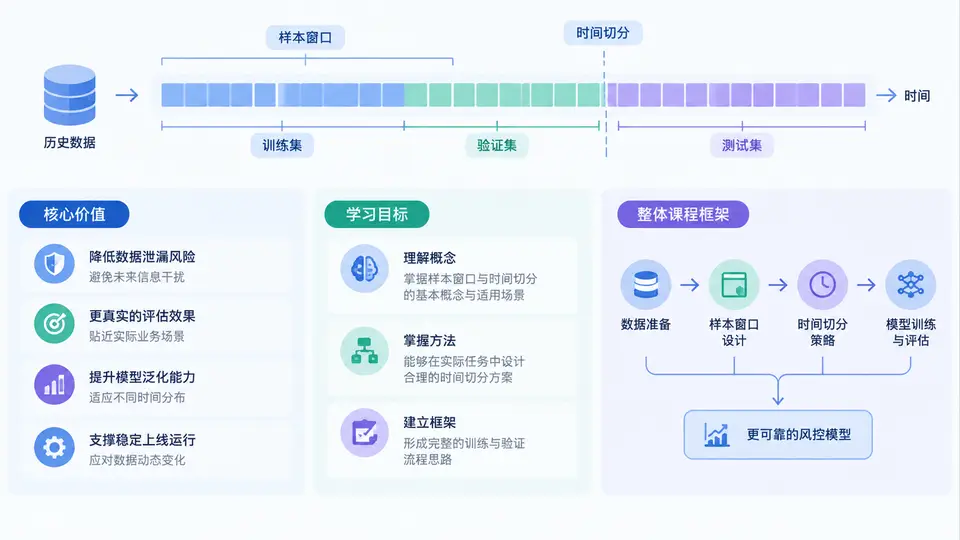
在信贷、支付、反欺诈等风控场景中,模型上线后效果衰减几乎是常态。很多团队把原因归结为“模型算法不够强”,但真正的问题往往出在更靠前的一步:训练样本的时间边界没有定义清楚。样本窗口决定了模型“向历史看多远”,时间切分决定了模型“用什么标准判断自己学得好不好”。这两件事做错,再先进的算法也只是在错误的数据上做精致的拟合。
一、核心原理:风控建模本质上是时间序列上的因果推断
普通机器学习任务常假设样本独立同分布,但风控样本天然带有时间结构。一个用户在3月申请借款、4月发生逾期,这条样本的标签只有在4月之后才可知。如果训练时把4月之后的信息泄露到3月的特征里,离线AUC会非常漂亮,上线却迅速崩塌。这就是典型的时间穿越(Leakage)。
因此,风控建模的核心约束是:特征只能使用申请时点之前可获取的信息,标签必须使用申请时点之后足够长时间才能确认的结果。样本窗口与时间切分,正是把这条因果约束落到工程上的两个关键动作。
一句话理解:样本窗口回答“用哪段时间的客户来训练”,时间切分回答“用哪段时间的表现来验证”。前者决定模型见过什么,后者决定我们是否相信模型。
从业务视角看,样本窗口还直接影响模型的“记忆周期”。窗口太短,模型只学到近期客群特征,遇到季节性波动就失效;窗口太长,历史客群与当前客群差异过大,模型学到的是过时规律。时间切分则决定了我们能否模拟真实上线节奏:训练用过去,验证用未来,中间还要留出标签成熟期。
二、方法流程:从业务问题到可执行的时间切分方案
一个可落地的样本窗口与时间切分流程,通常包含以下步骤:
- 明确业务目标与表现期:例如“预测首笔借款后90天内是否逾期30+”,表现期就是90天。
- 确定观察点与标签成熟时间:观察点是申请日,标签成熟时间是观察点加表现期,再叠加数据回传延迟。
- 划分训练窗口、验证窗口与测试窗口:按时间先后顺序切分,禁止随机打乱。
- 设置隔离带(Gap):在训练集与验证集之间留出至少一个表现期,防止标签重叠。
- 做时间外样本验证:用最近一段时间的样本检验模型稳定性,而不是只看随机验证集。
- 监控与回溯:上线后持续对比各时间窗口的KS、AUC与通过率,发现漂移及时重训。
下面是一个典型的时间切分配置示例,假设表现期为90天,数据回传延迟约15天:
观察点范围:2023-01-01 ~ 2023-12-31
表现期:90天
标签成熟延迟:15天

训练窗口:2023-01-01 ~ 2023-06-30
隔离带:2023-07-01 ~ 2023-09-30
验证窗口:2023-10-01 ~ 2023-12-31
测试窗口:2024-01-01 ~ 2024-03-31

切分原则:按时间升序,禁止随机shuffle
标签确认:观察点 + 90天 + 15天 <= 当前日期
这个配置的关键在于:训练集和验证集之间不是紧挨着的,而是留出了90天隔离带。如果没有隔离带,训练集末尾样本的标签可能延伸到验证集开头,造成信息重叠,验证结果会偏乐观。
三、案例/场景:一次因切分错误导致的线上事故
某消费金融团队开发首贷逾期模型,离线AUC达到0.82,上线后首月KS仅0.21。复盘发现两个问题:
- 问题一:随机切分。团队用sklearn的train_test_split随机划分,导致同一用户的不同申请记录同时出现在训练集和测试集,模型记住了用户身份。
- 问题二:特征窗口与标签窗口重叠。部分特征统计了“近180天逾期次数”,而标签是“未来90天是否逾期”,两者时间范围交叉,造成标签泄露。
修正方案是:按申请时间升序切分,训练集取前6个月,验证集取后3个月,中间留90天隔离带;同时把所有特征的计算截止时间严格限制在观察点之前。修正后离线AUC降到0.76,但上线KS提升到0.34,模型稳定性显著改善。
经验提示:离线指标下降不一定是坏事。如果修正切分后AUC从0.82降到0.76,但线上效果提升,说明之前的0.82是“虚假繁荣”。宁可要真实的0.76,也不要泄露带来的0.82。
四、误区与复盘:样本窗口与时间切分中的常见陷阱
| 误区 | 表现 | 后果 | 修正方法 |
|---|---|---|---|
| 随机切分 | 同一用户跨集合出现 | 离线指标虚高 | 按时间升序切分 |
| 无隔离带 | 训练与验证标签重叠 | 验证结果偏乐观 | 留出至少一个表现期 |
| 特征穿越 | 特征包含未来信息 | 上线效果崩塌 | 严格限制特征截止时间 |
| 窗口过长 | 包含过时客群 | 模型学到过时规律 | 结合业务周期滚动调整 |
| 窗口过短 | 样本量不足 | 模型方差大 | 保证每个窗口有足够坏样本 |
| 忽略标签成熟期 | 近期样本标签未成熟 | 标签噪声大 | 剔除未成熟样本 |
复盘这些误区,会发现它们有一个共同点:把时间当成了普通维度,而不是因果约束。风控建模中,时间不是可以随意打乱的特征,而是决定信息可见性的边界。样本窗口和时间切分的本质,就是在工程上强制执行“过去预测未来”的因果顺序。
特别提醒:任何在时间切分上“走捷径”的做法,最终都会在上线后以模型快速衰减的形式暴露出来。离线阶段多花一天把时间边界理清楚,线上可能少花一个月做紧急重训。
五、本课程学习目标与整体框架
通过本课程,你将掌握以下能力:
- 理解样本窗口、观察点、表现期、隔离带等核心概念及其相互关系。
- 能够根据业务目标设计合理的时间切分方案,并写出可执行的配置。
- 识别并修复特征穿越、标签泄露、随机切分等常见问题。
- 掌握滚动窗口、时间外验证、稳定性监控等进阶方法。
- 能够把样本窗口与时间切分方案落地到特征平台和训练流水线中。
课程整体围绕“概念—方法—工程—复盘”四条线展开:先建立时间因果的正确认知,再学习切分方法与参数设计,然后进入特征平台与训练流水线的工程实现,最后通过真实案例复盘常见陷阱与优化策略。每一章都会尽量给出可运行的配置、代码片段或检查清单,帮助你把知识转化为可复用的工程能力。
本章核心结论:样本窗口决定模型的学习范围,时间切分决定模型的可信度。两者共同构成风控模型训练的时间边界。边界不清,模型必崩;边界清晰,模型才有稳定上线的可能。