3. 数据基础与数据治理
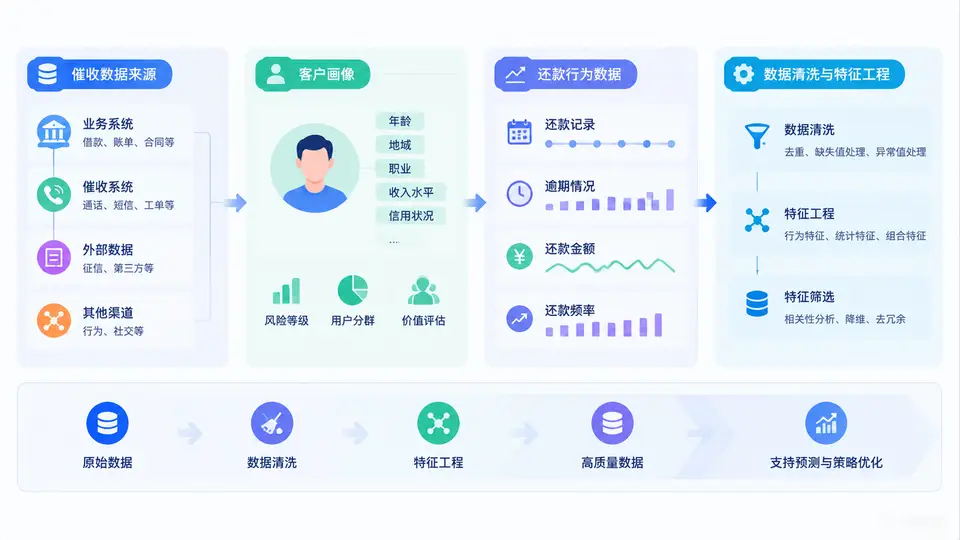
回收率预测模型的上限,往往不是算法决定的,而是数据决定的。在催收场景中,数据具有多源、异构、强时序、高噪声四个典型特征:一笔逾期账户的信息可能同时来自核心业务系统、催收作业系统、支付网关、外部征信和人工备注。如果这些数据没有被统一治理,模型学到的只是噪声的巧合,而不是真实的还款规律。本节围绕数据来源、客户画像、还款行为、清洗与特征工程四个层次,建立可落地的数据基础。
一、核心原理:催收数据的四层结构
催收数据可以按“谁、欠多少、怎么还、催过什么”四个问题组织成四层结构。第一层是账户与合同层,描述债务本身:合同金额、剩余本金、逾期天数(DPD)、逾期期数、利率、担保方式。第二层是客户画像层,描述债务人是谁:年龄、职业、收入区间、地域、历史授信记录、多头借贷情况。第三层是还款行为层,描述债务人如何行动:历史还款准时率、最低还款比例、承诺还款兑现率、还款渠道偏好、还款金额分布。第四层是催收交互层,描述机构做了什么:触达次数、触达渠道、通话时长、PTP(Promise to Pay)次数与兑现情况、投诉记录。
这四层的关系是:账户层定义“债”,画像层定义“人”,行为层定义“习惯”,交互层定义“动作”。回收率预测本质上是估计在给定“人”和“债”的条件下,施加某种“动作”后“习惯”发生正向变化的概率。缺少任何一层,模型都会出现系统性偏差。
二、数据来源与客户画像构建
典型催收数据来源包括:核心信贷系统(合同、放款、还款计划)、催收作业系统(案件分配、外呼记录、短信记录)、支付系统(实际入账流水)、客服与工单系统(投诉、协商、减免申请)、外部数据(征信报告、司法涉诉、运营商标签)。这些数据在接入时需要统一客户主键和时间基准。常见做法是以“客户号+合同号”作为案件主键,以“账期日”作为时间基准,所有特征按账期日对齐,避免未来信息泄露。
客户画像不是标签的堆砌,而是围绕还款能力与还款意愿两个维度组织。还款能力相关特征包括收入稳定性、负债收入比、资产状况;还款意愿相关特征包括历史履约、沟通配合度、承诺兑现率。实践中,意愿类特征的预测力往往高于能力类特征,但意愿类特征更依赖催收交互数据的质量。
| 数据层 | 典型字段 | 更新频率 | 主要风险 |
|---|---|---|---|
| 账户合同层 | 剩余本金、DPD、逾期期数、利率 | 每日 | 口径不一致、减免后未同步 |
| 客户画像层 | 年龄、职业、地域、多头次数 | 每月/事件触发 | 外部数据滞后、标签过期 |
| 还款行为层 | 历史准时率、最低还款比例、渠道 | 每日 | 跨合同归集错误 |
| 催收交互层 | 触达次数、通话时长、PTP兑现 | 实时/每日 | 记录缺失、坐席填写不规范 |
三、数据清洗与特征工程入门
清洗阶段要优先处理四类问题:缺失、异常、重复、时间穿越。缺失值不能一律填充均值,应按业务含义区分:未触达导致的空值与触达后未承诺导致的空值,含义完全不同。异常值要结合业务规则判断,例如通话时长出现负数或超过24小时,通常是系统时区或挂断逻辑问题。重复记录常见于同一案件多次分配,需要按“最近一次有效动作”去重。时间穿越是最危险的错误,例如用“最终回收金额”构造特征去预测“是否回收”,会导致离线指标虚高、上线失效。
特征工程入门可从三个方向展开:统计聚合、时间窗口、比率特征。统计聚合如“近30天触达次数”“历史PTP总次数”;时间窗口如“最近7天还款金额”“最近3次通话平均时长”;比率特征如“PTP兑现率=已兑现PTP/总PTP”“还款覆盖率=已还金额/应还金额”。比率特征通常比绝对量更稳定,也更容易跨案件比较。
# 示例:按客户聚合近30天催收交互特征(伪代码)
features = interactions \
  .filter(col("action_date") >= date_sub(current_date, 30)) \
  .groupBy("customer_id") \
  .agg(
      count("*").alias("contact_cnt_30d"),
      sum(when(col("channel") == "call", 1).otherwise(0)).alias("call_cnt_30d"),
      avg("call_duration").alias("avg_call_duration_30d"),
      sum(when(col("ptp_flag") == 1, 1).otherwise(0)).alias("ptp_cnt_30d"),
      sum(when(col("ptp_kept") == 1, 1).otherwise(0)).alias("ptp_kept_cnt_30d")
  ) \
  .withColumn("ptp_keep_rate_30d",
      col("ptp_kept_cnt_30d") / when(col("ptp_cnt_30d") == 0, 1).otherwise(col("ptp_cnt_30d")))
ptp_keep_rate_30d 比 keep_rate 更安全。上线前用“特征可用时间”检查每个字段在预测时点是否真实可得。
四、案例与常见误区复盘
某消费金融团队在构建回收率模型时,离线AUC达到0.86,但上线后策略效果远低于预期。复盘发现两个问题:一是使用了“案件最终是否进入法诉”作为特征,而该信息在预测时点尚未产生,属于典型时间穿越;二是“历史还款金额”按合同汇总时,未区分正常还款与减免后还款,导致高减免客户被误判为高还款意愿。修正后,AUC降至0.79,但上线回收率提升了约6个百分点。这说明离线指标的真实性比绝对值更重要。
常见误区还包括:把缺失率高的外部标签直接删除,却忽略了“是否缺失”本身可能携带信息;把催收交互特征与账户特征混在同一时间窗口,导致动作与结果错位;以及过度依赖单次通话记录,忽视长期行为趋势。治理数据时,应坚持“先对齐时间、再对齐口径、最后对齐业务动作”的顺序。
完成数据基础与治理后,回收率预测才具备可信的输入。下一步的关键,是把这些特征组织成可解释、可监控、可迭代的特征体系,并与催收策略的动作空间一一对应。