1. 课程导入
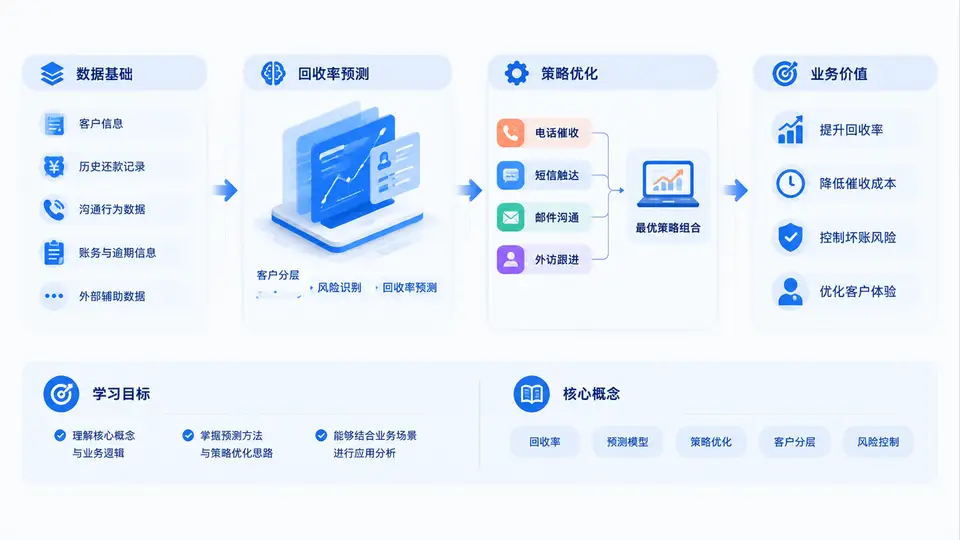
欢迎进入《催收Recovery回收率预测与策略优化》课程。在正式进入模型、算法与策略细节之前,本章先回答四个基础问题:我们究竟要解决什么业务问题?需要掌握哪些核心概念?整门课的知识地图如何展开?以及,做好这件事对业务到底意味着什么。把这四点想清楚,后续三十章的学习才不会变成零散工具的堆砌。
一、学习目标:从“事后统计”走向“事前决策”
本课程的目标不是让学员学会写几条SQL或调用某个模型接口,而是建立一套可落地的回收率预测与策略优化能力。具体可拆为四层:
- 认知层:理解催收Recovery的本质是在不确定条件下分配有限资源,回收率预测是决策的前置输入,而非报表的附属产物。
- 数据层:掌握催收案件、客户、账务、触达、还款等核心数据域的构成,能识别数据口径不一致、样本偏差与标签泄漏等常见陷阱。
- 模型层:能够针对不同账龄、不同案件类型选择合适的预测方法,从滚动率、账龄迁徙到机器学习模型,并正确评估其区分度与校准度。
- 策略层:能够把预测结果转化为分案、触达时机、渠道组合、减免方案等可执行策略,并通过实验与复盘持续优化。
二、核心概念:先把语言统一
催收领域最容易出现的问题不是模型不准,而是团队对同一指标的理解不一致。以下概念贯穿全课程,必须首先对齐。
| 概念 | 含义 | 常见口径风险 |
|---|---|---|
| Recovery回收率 | 一定观察期内,某批案件实际回收金额与应回收金额(或委案金额)之比 | 分母用委案额还是逾期本息,分子是否扣除费用,观察期长短不同 |
| 账龄(DPD) | 逾期天数,常分为M1、M2、M3+等区间 | 按自然月还是按天数切分,跨月案件归属不清 |
| 滚动率 | 某账龄案件迁移到下一账龄或最终核销的比例 | 未区分主动还款与催收促成还款 |
| 触达 | 通过电话、短信、信函、外访等方式与客户建立有效联系 | “拨打”不等于“触达”,接通与承诺还款差异大 |
| PTP | Promise to Pay,客户承诺还款 | 承诺金额与实际履约金额混用 |
| 策略 | 在给定资源约束下,对案件分配动作与优先级的规则集合 | 把策略等同于名单筛选,忽略时机与渠道组合 |
其中,回收率预测回答“这个案件/这批案件未来能收回多少”,策略优化回答“在有限人力与成本下,先做谁、做什么、什么时候做”。前者是估计问题,后者是决策问题,二者通过“预测—决策”闭环连接。
三、整体框架:预测与优化如何咬合
本课程的整体框架可以概括为“一条主线、两个循环、三层能力”。一条主线是:数据准备 → 回收率预测 → 策略生成 → 执行触达 → 结果回收 → 复盘迭代。两个循环分别是:模型侧的“训练—评估—监控—重训”循环,以及策略侧的“实验—度量—调整—固化”循环。三层能力对应数据与特征、模型与评估、策略与运营。
业务问题
  └─ 数据域:案件 / 客户 / 账务 / 触达 / 还款
       └─ 特征与标签:账龄、历史履约、触达响应、还款能力
            └─ 回收率预测:滚动率 / 迁徙率 / 分类回归 / 生存分析
                 └─ 策略优化:分案优先级、渠道组合、时机、减免
                      └─ 执行与回收:PTP、履约、实际回款
                           └─ 复盘:偏差分析、实验结论、规则迭代
需要强调的是,预测精度不是唯一目标。一个区分度略低但校准良好、可解释、能稳定上线的模型,往往比一个离线AUC很高但无法解释、无法监控的模型更有业务价值。策略优化同样如此:最优策略不是理论收益最大,而是在合规、成本、客户体验约束下的可执行最优。
四、业务价值与典型场景
回收率预测与策略优化的价值,最终体现在三个层面:收入提升、成本下降、风险与合规可控。收入提升来自把有限的人力投向更可能还款的案件;成本下降来自减少无效拨打、降低委外成本、优化减免幅度;风险与合规可控来自对高风险案件、投诉敏感案件的分层处理。
以一个典型场景说明:某消费金融公司M1案件每日新增数万件,催收员人均每日可处理约120件。若按账龄从早到晚顺序分配,会出现大量低回收概率案件占用高技能催收员时间的情况。引入回收率预测后,可以按“预测回收金额 × 触达成功率 / 单位成本”排序,把高价值案件优先分配给高技能坐席,把低价值案件转入自动化短信或IVR。策略上线后,常见的结果是:在总人力不变的情况下,整体回收率提升若干百分点,同时无效拨打次数明显下降。
五、常见误区与复盘视角
初学者最容易陷入以下误区,本章先建立“避坑清单”,后续章节会逐一展开。
- 把回收率当成单一数字:不同账龄、不同渠道、不同产品的回收率不可直接比较,必须分层看。
- 用未来信息预测过去:例如用“最终是否核销”作为特征,造成标签泄漏,离线指标虚高。
- 忽略样本偏差:只对已触达案件建模,预测结果无法推广到未触达案件。
- 只看AUC不看校准:策略排序需要的是概率校准,而非单纯排序能力。
- 策略上线不做对照实验:没有对照组,无法区分增量来自策略还是季节性因素。
- 忽视合规与客户体验:过度催收带来的投诉与监管风险,可能远超短期回收收益。
复盘时应固定三个问题:预测偏差出现在哪些分层?策略执行是否偏离设计?增量回收是否可归因?只有把这三个问题回答清楚,预测与优化才形成闭环。