1. 课程导入
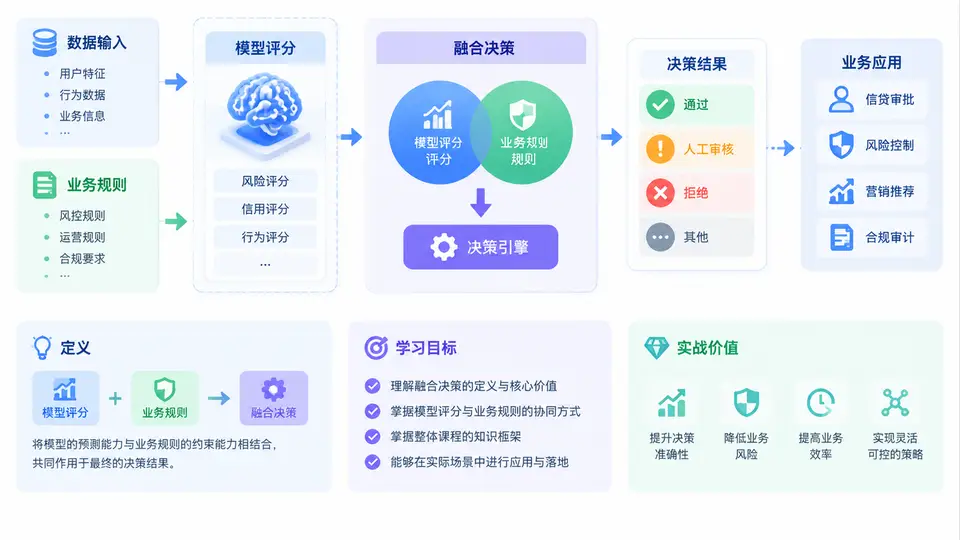
一、为什么需要“融合决策”
在真实的信贷审批、反欺诈、营销响应、额度定价等业务场景中,纯模型评分与纯业务规则往往各自存在明显短板。模型评分擅长从高维数据中捕捉统计规律,输出连续风险概率,但在冷启动、样本偏移、监管解释和极端客群上容易失稳;业务规则擅长表达确定性约束、合规底线与专家经验,却难以覆盖复杂交互,且规则数量膨胀后维护成本极高。融合决策的核心,就是把“概率化判断”与“确定性约束”组织成一条可解释、可监控、可迭代的决策链路。
本课程所说的模型评分与业务规则融合决策,是指以模型输出的分数或概率作为主要风险信号,以业务规则作为准入、拦截、分流、调额和人工复核的控制层,通过策略编排、阈值管理、优先级仲裁和效果归因,形成稳定可上线的自动化决策系统。它不是简单地把规则和模型相加,而是明确“谁先谁后、谁覆盖谁、谁解释谁”。
一句话定义:融合决策 = 模型提供排序与概率,规则提供边界与控制,策略引擎负责编排、仲裁与可追溯。
二、学习目标
完成本课程后,你应当能够独立完成从需求拆解到策略上线的完整闭环。具体目标包括:
- 理解模型评分、规则引擎、决策流三者的职责边界与协作方式;
- 掌握评分卡、概率校准、分数分箱与规则条件表达的基本方法;
- 能够设计“规则前置拦截 + 模型评分分流 + 规则后置调优”的典型策略链路;
- 能够使用优先级、互斥、覆盖、灰度等机制处理规则冲突;
- 能够建立离线回放、在线监控、AB实验与效果归因的评估体系;
- 能够识别并规避常见误区,如阈值拍脑袋、规则堆叠、样本泄漏与监控缺失。
三、整体课程框架
课程共30章,按“原理—方法—工程—实战—复盘”递进组织。前段建立概念与数学基础,中段进入策略编排与工程实现,后段通过完整案例串联上线、监控与迭代。
| 阶段 | 核心内容 | 产出能力 |
|---|---|---|
| 基础认知 | 融合决策定义、评分与规则差异、决策链路 | 能画出业务决策流 |
| 方法流程 | 评分校准、分箱、阈值、规则表达、优先级仲裁 | 能设计策略表 |
| 工程实现 | 规则引擎、决策表、特征服务、离线回放 | 能落地可执行策略 |
| 实战案例 | 信贷审批、反欺诈、额度定价、营销分流 | 能端到端交付 |
| 监控复盘 | 指标监控、AB实验、归因分析、规则治理 | 能持续迭代优化 |
四、核心原理:三层决策结构
融合决策通常可抽象为三层:数据与特征层、模型评分层、规则策略层。数据层保证输入一致性与时效性;模型层输出分数、概率或风险等级;规则层决定最终动作,如通过、拒绝、转人工、降额、加验。三层之间通过标准接口解耦,才能支持独立迭代与快速回滚。
决策链路示例:
输入请求
  -> 特征计算(实时/离线)
  -> 模型评分(score / prob / rank)
  -> 规则前置(黑名单、合规、硬拦截)
  -> 规则后置(阈值分流、额度调整、人工复核)
  -> 输出动作 + 原因码 + 版本号
其中原因码和版本号是工程上最容易被忽视、却对解释与追责最关键的两个字段。没有原因码,业务无法复盘;没有版本号,实验无法归因。
建议在策略设计初期就固定“动作字典”和“原因码字典”,例如:PASS、REJECT、REVIEW、DOWNGRADE、STEP_UP。字典稳定后,监控、报表和实验分析才能复用。
五、方法流程:从需求到上线
一个可复用的融合决策流程通常包含七步:
- 业务拆解:明确目标指标(通过率、坏账率、召回率、人工成本)与约束条件(合规、额度、时效)。
- 数据准备:确定样本口径、观察期与表现期,避免样本泄漏。
- 模型评分:训练评分模型并做概率校准,输出可解释分数。
- 规则梳理:把专家经验、监管要求和历史策略转成条件表达式。
- 策略编排:确定规则优先级、互斥关系、覆盖关系与默认动作。
- 离线回放:用历史样本模拟新策略,评估通过率、坏账率与命中分布。
- 上线监控:灰度发布,监控分数漂移、规则命中率、动作分布与业务指标。
六、案例场景:信贷审批中的融合决策
假设某消费信贷产品需要审批一笔申请。纯模型方案可能给出“违约概率0.08”,但业务要求:命中内部黑名单必须拒绝;近30天多头申请超过8次必须转人工;评分低于550且无社保记录必须拒绝。此时融合策略可以这样组织:
规则1(硬拦截):命中黑名单 -> REJECT
规则2(硬拦截):多头申请>8 -> REVIEW
规则3(模型分流):score < 550 且 无社保 -> REJECT
规则4(模型分流):550 <= score < 650 -> REVIEW
规则5(默认动作):score >= 650 -> PASS
优先级:规则1 > 规则2 > 规则3 > 规则4 > 规则5
这个例子的关键在于:规则不是模型的补充说明,而是与模型共同构成决策空间。硬拦截优先于模型分流,模型分流优先于默认动作,从而保证合规底线不被概率判断突破。
七、常见误区与复盘要点
误区一:把规则当模型用。规则适合表达确定性和边界,不适合替代概率排序。规则过多会导致策略脆弱、维护困难。
误区二:阈值拍脑袋。阈值应基于业务目标、成本矩阵和离线回放确定,而不是凭经验直接设定。
误区三:忽视监控。模型会漂移,规则会失效,没有监控的融合策略等于“上线即失控”。
误区四:缺少版本与原因码。无法归因就无法迭代,实验结论不可信。
复盘时应重点检查:动作分布是否异常、规则命中率是否突变、模型分数分布是否偏移、人工复核量是否超载、业务指标是否与离线预期一致。只有把“策略效果”拆解到“规则贡献”和“模型贡献”,融合决策才真正可控。
八、实战价值
掌握融合决策能力,意味着你能在业务、算法与工程之间建立共同语言:业务方看到的是可解释的动作与原因码,算法方看到的是评分与阈值,工程方看到的是可配置、可回放、可灰度的策略链路。它直接提升三类价值:风险可控(合规底线不被突破)、效率提升(自动化分流减少人工)、迭代加速(策略与模型解耦,快速实验)。
接下来的章节将围绕评分校准、规则表达、策略编排、离线回放、在线监控与典型案例逐步展开。请先建立“模型负责排序、规则负责边界、引擎负责编排”的整体认知,这将是贯穿全课程的主线。