1. 课程导入
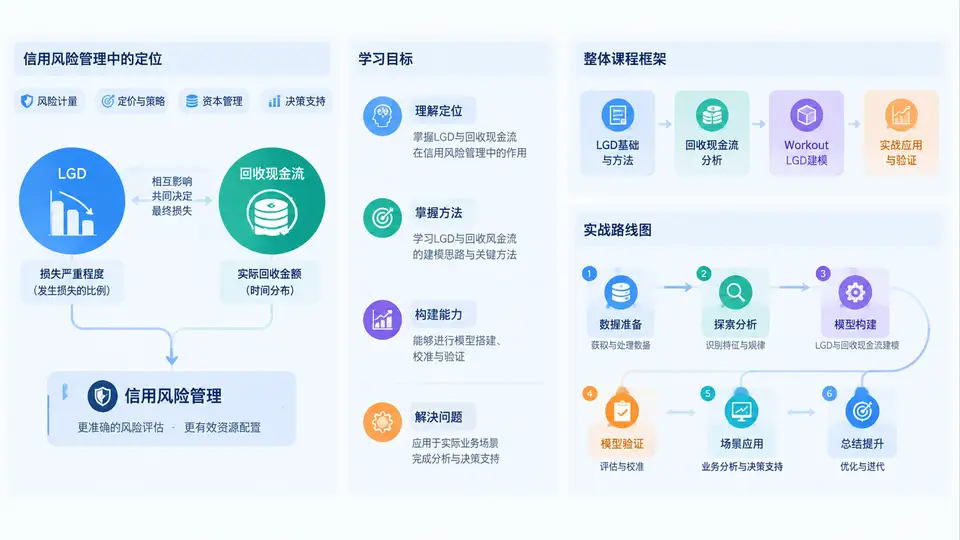
一、为什么LGD值得单独建模
在信用风险管理的三大核心参数中,PD(违约概率)、EAD(违约风险暴露)与LGD(违约损失率)共同决定预期信用损失:ECL = PD × EAD × LGD。过去很多机构的建模资源集中在PD上,因为PD的区分度容易用KS、AUC等指标衡量,而LGD长期被简化为“1减去抵押率”或直接采用监管底线值。但在实际业务中,LGD的波动往往比PD更剧烈,且直接决定回收现金流的分配与定价。
LGD的本质不是“损失比例”这个静态数字,而是一条回收现金流的时间路径。同样回收100万元,3个月收回与3年收回,其经济价值完全不同。因此,本课程把LGD建模拆成两条主线:一是回收现金流的预测与折现,二是Workout LGD(清收处置损失率)的实战建模。前者回答“能收回多少、什么时候收回”,后者回答“在清收处置场景下如何量化损失”。
二、核心原理:回收现金流与Workout LGD的关系
回收现金流通常包括:借款人经营回款、抵押物处置变现、保证人代偿、诉讼执行回款、债务重组后的分期付款等。这些现金流具有三个特征:时间不确定、金额不确定、来源分散。Workout LGD则聚焦于违约后的清收处置过程,其经典公式为:
Workout LGD = 1 - (回收现金流现值 - 清收成本) / 违约风险暴露

其中:
回收现金流现值 = Σ [CF_t / (1 + r)^t]
CF_t:第t期回收现金流
r:折现率(通常采用合同利率或资金成本)
清收成本:诉讼费、律师费、评估费、处置税费等
这个公式看似简单,但实战中每个变量都需要建模:CF_t需要预测回收金额与回收时间,r需要选择合理的折现基准,清收成本需要按处置渠道分层估计。更重要的是,Workout LGD通常存在双峰分布——要么高回收(有抵押、有保证),要么低回收(信用类、无担保),这决定了建模方法不能简单套用线性回归。
三、方法流程:从数据到LGD的实战路线图
本课程的整体框架遵循“数据准备—回收现金流建模—Workout LGD建模—验证与落地”四步走。具体流程如下:
- 数据准备:整合违约账户、回收流水、抵押物信息、清收成本、处置时间等数据,构建违约-回收宽表。
- 回收现金流建模:预测回收金额、回收时间分布,计算回收现金流现值。
- Workout LGD建模:选择模型(Beta回归、分数响应回归、决策树/随机森林等),处理双峰分布与零回收问题。
- 验证与落地:回溯测试、敏感性分析、监管资本与拨备应用、定价传导。
| 阶段 | 核心任务 | 关键输出 | 常见工具 |
|---|---|---|---|
| 数据准备 | 违约定义、回收口径、成本归集 | 违约-回收宽表 | SQL、Python pandas |
| 回收现金流建模 | 回收金额与时间预测、折现 | 回收现金流现值分布 | 生存分析、分位数回归 |
| Workout LGD建模 | LGD预测、双峰处理、零回收 | LGD模型与评分卡 | Beta回归、XGBoost |
| 验证与落地 | 回溯、敏感性、监管应用 | LGD参数体系 | Python、BI报表 |
四、案例场景:一笔对公贷款违约后的回收路径
假设某银行向一家制造企业发放1000万元流动资金贷款,企业违约后进入清收处置。抵押物为厂房,评估值600万元,但处置周期长达18个月;保证人代偿200万元,分3期支付;诉讼与处置成本合计80万元。折现率采用合同利率6%。
回收现金流:
第6个月:保证人代偿 80万元
第12个月:保证人代偿 70万元
第18个月:厂房处置净回款 520万元
第24个月:保证人代偿 50万元

折现计算(简化按年折现):
PV = 80/(1.06)^0.5 + 70/(1.06)^1 + 520/(1.06)^1.5 + 50/(1.06)^2
   ≈ 77.7 + 66.0 + 474.5 + 44.5
   ≈ 662.7万元

Workout LGD = 1 - (662.7 - 80) / 1000 = 1 - 0.5827 = 41.73%
这个案例说明:即使抵押物评估值600万元,由于处置周期长、成本高,最终LGD仍可能超过40%。如果忽略时间价值,直接用“1 - 600/1000 = 40%”会低估损失。回收现金流建模的价值正在于此。
五、误区与复盘:LGD建模中最容易踩的坑
- 把LGD当成静态比率:忽略回收时间与折现,导致经济损失被低估。
- 混淆监管LGD与Workout LGD:监管底线值用于资本计量,Workout LGD用于内部定价与拨备,两者口径不同。
- 零回收与高回收混合建模:不做双峰处理,模型预测值集中在中间,失去区分度。
- 清收成本归集不全:只算诉讼费,忽略内部人力、时间成本与税费。
- 样本偏差:只使用已结清清收案件,忽略仍在处置中的账户,导致回收率被高估。
复盘这些误区,核心原则是:LGD建模必须回到现金流本身。任何脱离回收时间、回收成本、回收不确定性的LGD数字,都只是会计口径的近似,无法支撑精细化管理。
六、整体课程框架与实战路线图
本课程共30章,围绕“回收现金流—Workout LGD—验证落地”展开。前10章聚焦数据与回收现金流建模,中间10章深入Workout LGD模型开发与调优,后10章覆盖验证、监管应用与实战案例。每章都配有可运行的Python代码片段与业务场景,确保你不仅能理解原理,还能动手实现。
实战路线图:
第1章  课程导入与整体框架
第2-5章  数据准备、违约定义、回收口径、成本归集
第6-10章  回收金额预测、回收时间预测、折现与现金流现值
第11-15章  Workout LGD模型选择、Beta回归、分数响应回归
第16-20章  双峰分布处理、零回收建模、机器学习应用
第21-25章  模型验证、回溯测试、敏感性分析
第26-30章  监管资本、拨备、定价传导与综合案例
请记住:LGD建模不是一次性的统计练习,而是一个持续迭代的工程体系。从今天开始,我们将一步步把回收现金流变成可量化、可解释、可落地的LGD参数。