1. 课程导入
1.1 为什么LGD建模值得单独学习
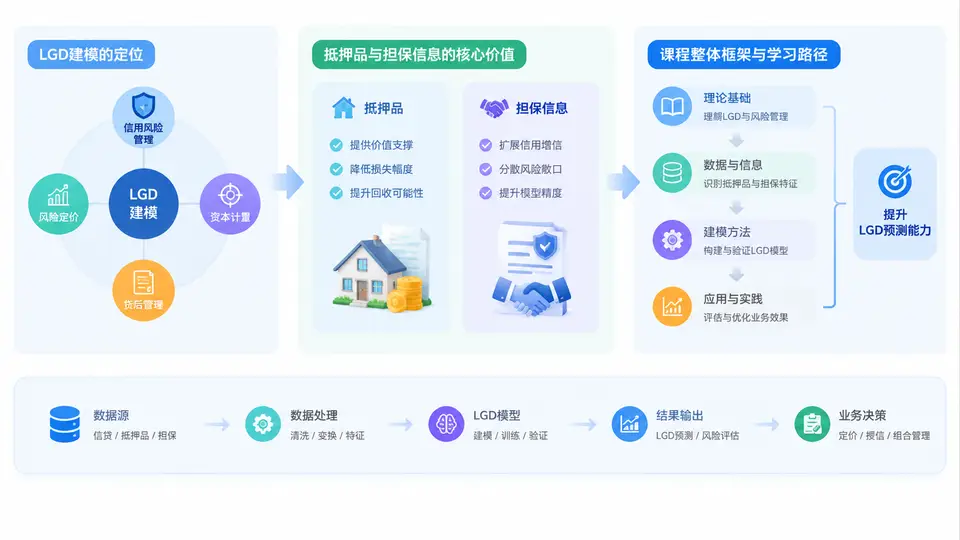
在信用风险管理的三大核心参数中,PD(违约概率)、EAD(违约风险暴露)与LGD(违约损失率)共同决定了预期信用损失。很多团队把大量精力投入PD模型,却把LGD当作一个“拍脑袋的常数”,例如统一取45%或50%。这种做法的直接后果是:资本计量失真、定价无法覆盖真实风险、拨备与压力测试结果偏离实际。LGD建模的价值,恰恰在于把“违约之后到底损失多少”这件事,从经验假设变成可解释、可验证、可驱动的量化过程。
LGD的定义是:违约发生时,风险暴露中最终无法收回的比例。用公式表达为 LGD = 1 − 回收率。而回收率的高低,极大程度上取决于两件事:是否有抵押品,以及是否有第三方担保。这正是本课程的主线——用抵押品与担保信息驱动LGD建模。
1.2 抵押品与担保信息的核心价值
抵押品和担保是LGD建模中最具区分度的风险缓释因素。它们的作用不是简单“降低损失”,而是通过改变回收路径来重塑损失分布。理解这一点,需要区分三类缓释机制:
- 抵质押品:如房产、设备、存货、应收账款、金融质押物。其价值取决于估值、折扣率(haircut)、处置周期与市场流动性。
- 第三方担保:如保证人、信用保险、母公司担保。其价值取决于担保人的信用质量、担保覆盖比例与法律可执行性。
- 结构性缓释:如现金保证金、准备金、优先受偿安排。它们直接影响回收现金流的时点与确定性。
在建模实践中,这些信息通常以字段形式存在于押品系统、合同系统和担保台账中。能否把它们正确映射到LGD模型,决定了模型是“真实反映风险”还是“看起来很美”。
1.3 核心原理:从回收现金流到LGD
LGD不是单一数字,而是一条回收现金流的结果。其计算可拆解为:
LGD = 1 − (回收金额现值 / 违约时风险暴露)
回收金额现值 = Σ [回收现金流_t / (1 + 折现率)^t] − 处置成本
因此,建模时必须回答四个问题:回收多少、何时回收、折现率多少、成本多少。抵押品与担保信息正是回答前两个问题的关键输入。下表给出常见缓释工具对LGD的影响维度清单:
| 缓释工具 | 主要影响维度 | 关键字段示例 | 建模关注点 |
|---|---|---|---|
| 房产抵押 | 回收金额、处置周期 | 评估值、折扣率、区域 | 估值时效、司法处置时长 |
| 设备质押 | 回收金额、折旧 | 原值、净值、成新率 | 二手市场流动性 |
| 应收账款质押 | 回收金额、集中度 | 账龄、债务人评级 | 虚假贸易、回款归集 |
| 第三方保证 | 回收确定性 | 保证人评级、覆盖比例 | 代偿意愿与能力 |
| 现金保证金 | 回收时点、金额 | 保证金比例、冻结状态 | 直接扣划可行性 |
1.4 方法流程:本课程的整体框架
本课程共30章,围绕“数据—特征—模型—应用”四层展开。第1章建立认知地图,后续章节逐步深入。整体学习路径如下:
- 认知与数据层:理解LGD定位,梳理押品与担保数据结构,完成数据清洗与映射。
- 特征工程层:构建覆盖率、折扣率、处置周期、担保质量等衍生变量。
- 模型构建层:从线性回归、Beta回归到树模型与机器学习,处理零回收与右偏分布。
- 验证与应用层:区分度、校准、压力测试、资本计量与定价落地。
1.5 案例场景:一个被忽略的担保字段
某银行零售贷款组合中,LGD长期使用固定值50%。引入押品与担保信息后,团队发现两个现象:有房产抵押的贷款实际回收率显著更高,而仅有第三方保证的贷款回收率波动极大。进一步分析发现,保证人评级字段在系统中大量缺失,导致模型无法区分“强担保”与“弱担保”。修正数据映射后,组合LGD从50%降至约38%,同时高担保组的资本占用明显下降。这个案例说明:LGD建模的收益,往往首先来自数据治理,而非算法升级。
1.6 常见误区与复盘
- 误区一:把LGD当常数。 忽略押品与担保差异,导致风险定价失真。
- 误区二:只看押品名义价值。 不扣折扣率、不考虑处置周期,回收金额被高估。
- 误区三:担保信息不参与建模。 担保人评级缺失或未结构化,模型无法识别缓释效果。
- 误区四:用PD模型思路做LGD。 LGD分布右偏且含大量边界值,直接套用普通回归会失效。