1. 课程导入
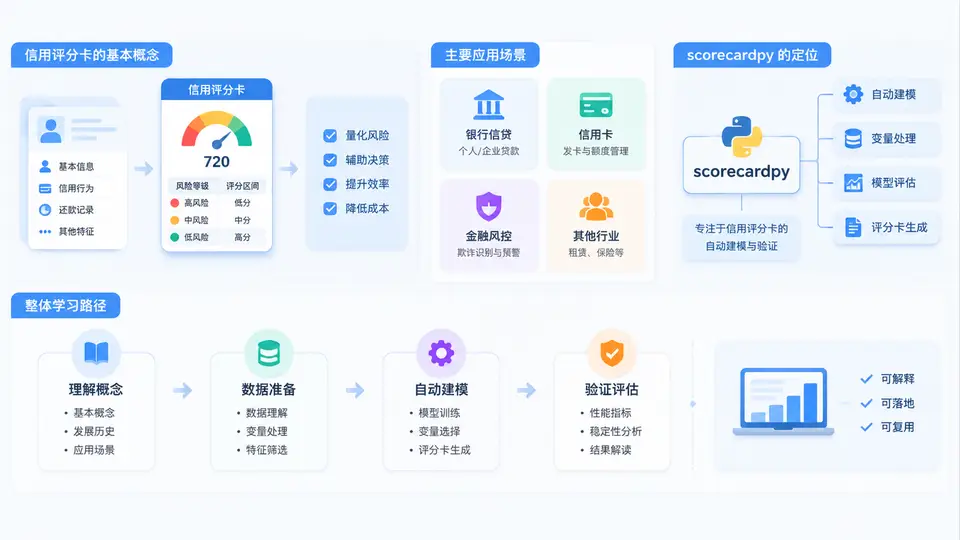
信用评分卡是消费金融、信用卡、小微信贷与助贷风控中最常见的风险决策工具。它把借款人的历史行为、资产负债、申请信息等特征,通过统计模型映射为一个分数,再用分数区间对应审批、额度、定价等策略。理解评分卡,关键不是记住某个公式,而是理解它如何把"风险概率"翻译成"业务动作"。
一、信用评分卡的基本概念
评分卡通常由三部分组成:特征体系、评分模型与分数映射规则。特征体系决定"看什么",模型决定"怎么算",分数映射决定"怎么用"。在二分类场景中,模型输出的是违约概率,评分卡则通过尺度变换把概率转换为整数分数,并保证分数越高、风险越低。
常见的分数刻度变换公式如下:
score = A - B * ln(odds)
其中:
odds = P(坏客户) / P(好客户)
A 为偏移量,B 为刻度因子
通常设定:基准分 600 对应 odds=50,每增加 20 分 odds 翻倍
这套变换让评分具备可解释性与可比性:不同模型、不同时间的分数可以放在同一尺度上比较,也便于设定通过率与坏账率的联动策略。
二、发展历史:从专家规则到自动建模
信用评分卡的发展大致经历四个阶段:
- 专家经验阶段:由风控专家制定规则,如"近半年逾期超过2次拒绝"。优点是透明,缺点是难以覆盖复杂交互,且规则维护成本高。
- 统计模型阶段:以逻辑回归为主,配合WOE编码,形成标准化评分卡。逻辑回归可解释、稳定,至今仍是监管友好型模型的首选。
- 机器学习阶段:随机森林、XGBoost、LightGBM等提升区分度,但黑箱问题带来解释与合规压力。
- 自动化与平台化阶段:从特征筛选、分箱、WOE、建模到验证形成流水线,scorecardpy正是这一阶段的代表性工具。
评分卡不是越复杂越好。在强监管场景中,可解释性、稳定性与可审计性往往比单纯提升AUC更重要。
三、应用场景与业务价值
评分卡贯穿信贷全生命周期,不同阶段关注不同目标:
| 阶段 | 典型评分卡 | 核心目标 | 常用指标 |
|---|---|---|---|
| 贷前申请 | A卡 | 预测申请通过后的违约概率 | KS、AUC、通过率 |
| 贷中管理 | B卡 | 预测存量客户未来逾期风险 | KS、PSI、迁徙率 |
| 贷后催收 | C卡 | 预测回款概率与催收优先级 | 回款率、Lift |
| 额度定价 | 收益卡 | 平衡风险与收益 | 风险调整收益 |
以A卡为例,业务上常把分数切分为若干风险等级,每个等级对应不同的审批策略。例如分数高于700直接通过,650至700进入人工复核,低于650拒绝。评分卡的价值在于把风控经验固化为可复现、可监控、可迭代的决策资产。
四、scorecardpy的定位与整体学习路径
scorecardpy是一个面向信用评分卡的Python工具包,覆盖从数据准备到模型验证的主要环节。它的设计目标是让分析师用较少代码完成标准评分卡流程,同时保留足够的参数控制空间。
核心功能模块包括:
- 数据切分:
split_df按时间或随机方式划分训练集与测试集。 - 变量筛选:
var_filter基于缺失率、IV、相关性等过滤变量。 - 分箱:
woebin自动分箱并计算WOE与IV。 - WOE转换:
woebin_ply将原始特征转换为WOE值。 - 模型训练:
lr_model训练逻辑回归。 - 评分映射:
scorecard生成标准评分卡。 - 验证:
perf_eva与perf_psi评估区分度与稳定性。
一个最小可运行流程如下:
import scorecardpy as sc

# 1. 数据切分
train, test = sc.split_df(data, 'flag', ratio=0.7).values()

# 2. 变量筛选
train = sc.var_filter(train, 'flag')

# 3. 分箱与WOE
bins = sc.woebin(train, 'flag')
train_woe = sc.woebin_ply(train, bins)
test_woe = sc.woebin_ply(test, bins)

# 4. 逻辑回归建模
lr = sc.lr_model(train_woe, 'flag')

# 5. 生成评分卡
card = sc.scorecard(bins, lr, train_woe.columns[1:])

# 6. 分数计算与验证
train_score = sc.scorecard_ply(train, card)
test_score = sc.scorecard_ply(test, card)
sc.perf_eva(test['flag'], test_score['score'])
学习scorecardpy的正确顺序是:先理解评分卡原理,再掌握分箱与WOE,最后进入建模、评分映射与验证。跳过原理直接调包,往往会在参数选择和结果解读上踩坑。
五、常见误区与复盘
初学者在评分卡建模中容易陷入以下误区:
- 只看AUC,不看KS与PSI:AUC高不代表业务可用,KS反映区分能力,PSI反映稳定性,三者需结合。
- 分箱过细:每个箱样本过少会导致WOE波动大,模型过拟合。
- 忽略时间外验证:随机切分可能高估效果,时间外样本更接近真实上线表现。
- 把WOE当特征工程终点:WOE转换后仍需检查多重共线性与变量业务含义。
- 上线后不监控:评分卡会随客群与宏观环境漂移,需定期做PSI与重新校准。
评分卡模型上线后,若PSI持续高于0.25,通常意味着客群分布发生显著变化,需要排查数据源、策略或模型本身,必要时重新训练。