3. LightGBM入门
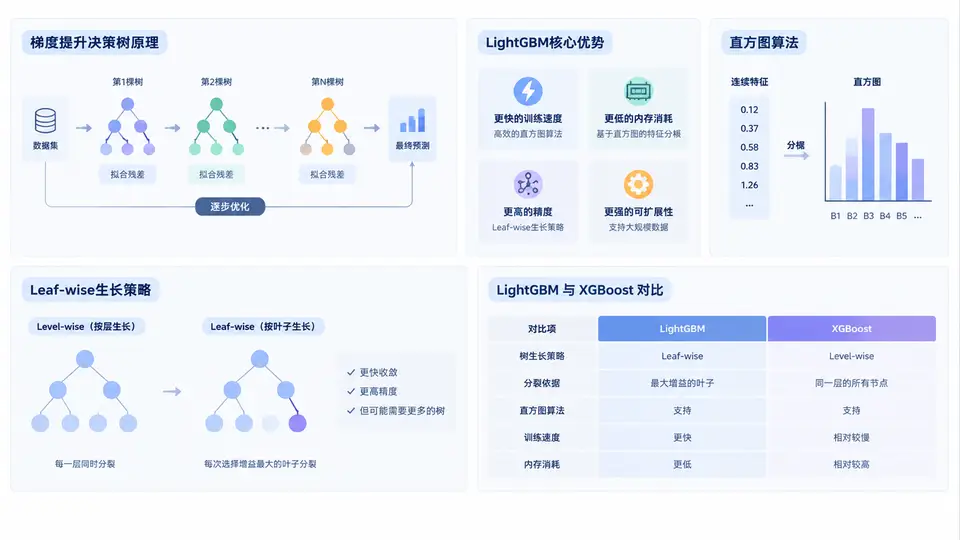
在信用评分场景中,我们面对的数据往往具有样本量大、特征维度高、缺失值与类别型变量混杂等特点。LightGBM 作为微软开源的梯度提升框架,凭借训练速度快、内存占用低、精度稳定等优势,已成为风控建模的主力工具之一。本节从梯度提升决策树的基本原理出发,逐步拆解 LightGBM 的核心机制,并厘清它与 XGBoost 的关键差异。
一、核心原理:梯度提升决策树在做什么
梯度提升决策树(GBDT)是一种加法模型。它的基本思想是:不断训练新的决策树去拟合当前模型残差的负梯度,然后把新树累加到已有模型上,使整体损失函数逐步下降。用公式表达,第 t 轮的预测为:
F_t(x) = F_{t-1}(x) + η · h_t(x)

其中:
F_{t-1}(x)  上一轮模型预测
h_t(x)      本轮新训练的决策树
η           学习率(shrinkage),控制每棵树贡献
对于信用评分常用的二分类任务,损失函数通常取对数损失(LogLoss)。每一轮迭代中,模型计算每个样本的负梯度(即伪残差),再训练一棵树去拟合这些残差。因此,GBDT 的本质是“在函数空间里做梯度下降”,而每一棵决策树就是一次下降方向。
关键理解:GBDT 不是简单地对残差做回归,而是对损失函数的负梯度做拟合。当损失函数为均方误差时,负梯度恰好等于残差;当损失函数为 LogLoss 时,负梯度则与预测概率和真实标签的偏差相关。
二、LightGBM 的核心优势
传统 GBDT 在每次寻找最优分裂点时,需要遍历所有特征的所有取值,计算代价随样本数和特征数线性增长。LightGBM 通过三项关键设计显著提升效率:
- 直方图算法:将连续特征离散化为固定数量的桶,分裂时只需在桶上累加统计量,大幅减少计算量。
- Leaf-wise 生长策略:每次选择当前增益最大的叶子节点进行分裂,而不是按层均匀分裂,从而在相同叶子数下获得更低的损失。
- GOSS 与 EFB:基于梯度的单边采样保留梯度大的样本,互斥特征捆绑减少有效特征数,进一步加速训练。
三、直方图算法:把连续特征装进桶里
直方图算法的核心是“分桶”。对于每个连续特征,LightGBM 将其取值划分到 max_bin 个桶中(默认 255)。训练时不再遍历原始浮点值,而是遍历桶的边界,并在每个桶中累积一阶梯度之和与二阶梯度之和。分裂增益的计算只需在这些统计量上完成。
# 直方图构建示意(伪代码)
for feature in features:
    bins = discretize(feature, max_bin=255)
    for sample in samples:
        bin_id = bins[sample]
        histogram[bin_id].sum_grad += grad[sample]
        histogram[bin_id].sum_hess += hess[sample]
        histogram[bin_id].count += 1
这样做带来两个直接收益:一是内存占用从“存储原始特征值”变为“存储桶索引”,通常可压缩到原来的 1/8 甚至更低;二是分裂点搜索从 O(#data × #features) 降为 O(#bins × #features),而 #bins 远小于 #data。在信用评分常见的百万级样本、数百维特征场景中,这一优化非常可观。
实践提示:max_bin 并非越大越好。增大桶数会提升分裂精度,但也会增加计算量和过拟合风险。信用评分中常从 255 起步,若特征区分度不足可尝试 127 或 63 以换取更快训练。
四、Leaf-wise 生长策略:优先分裂“最有价值”的叶子
XGBoost 默认采用 Level-wise(按层生长),同一层的所有节点都会分裂,即使某些节点增益很低。LightGBM 默认采用 Leaf-wise:每次从当前所有叶子中选出分裂增益最大的那个叶子进行分裂。这样在相同的叶子数量约束下,Leaf-wise 能更快降低训练损失。
但 Leaf-wise 也有代价:它更容易生长出深而不平衡的树,在数据量较小或噪声较大时容易过拟合。因此 LightGBM 提供了 num_leaves 和 max_depth 两个参数进行约束。信用评分建模中,通常将 num_leaves 控制在 31~127 之间,并配合 min_data_in_leaf 防止叶子样本过少。
# 典型信用评分参数片段
params = {
    "objective": "binary",
    "metric": "auc",
    "num_leaves": 63,
    "max_depth": -1,
    "learning_rate": 0.05,
    "min_data_in_leaf": 50,
    "feature_fraction": 0.8,
    "bagging_fraction": 0.8,
    "bagging_freq": 1,
    "max_bin": 255
}
五、LightGBM 与 XGBoost 对比
两者都是 GBDT 的高效实现,但在工程取舍上有明显差异。下表从分裂策略、特征处理、速度和适用场景四个维度进行对比:
| 对比维度 | LightGBM | XGBoost |
|---|---|---|
| 树生长策略 | Leaf-wise,优先分裂高增益叶子 | 默认 Level-wise,按层分裂 |
| 特征分裂搜索 | 直方图算法,桶上累加统计量 | 预排序或近似直方图 |
| 类别特征 | 原生支持 categorical_feature | 需手动编码或使用 one-hot |
| 训练速度 | 通常更快,尤其大样本高维 | 较慢,但小数据下稳定 |
| 内存占用 | 较低,桶索引存储 | 较高,需存储排序索引 |
| 过拟合风险 | Leaf-wise 更易过拟合,需调参约束 | Level-wise 相对稳健 |
| 典型场景 | 大规模风控、推荐、点击率预估 | 中小规模、对稳定性要求高的任务 |
常见误区:“LightGBM 一定比 XGBoost 好”并不成立。在样本量只有几千条、特征噪声较大的信用评分冷启动阶段,Leaf-wise 可能更快过拟合,此时 XGBoost 的 Level-wise 反而更稳。选型应结合数据规模、调参成本和线上推理要求综合判断。
六、案例复盘:一次信用评分建模的加速过程
假设某消费金融场景有 80 万条样本、320 维特征,正样本占比约 4%。使用 XGBoost 默认参数训练一轮约需 12 分钟,AUC 为 0.782。切换到 LightGBM 后,保持相近的叶子数和学习率,训练时间降至约 3 分钟,AUC 为 0.785。进一步开启 feature_fraction=0.8 和 bagging_fraction=0.8 后,训练时间降至 2 分 20 秒,AUC 基本持平。
复盘发现,加速主要来自直方图算法对分裂搜索的压缩,以及 Leaf-wise 在相同迭代轮数下更快降低损失。但同时也观察到:当 num_leaves 设为 255 且未限制 min_data_in_leaf 时,验证集 AUC 从 0.785 降到 0.771,说明 Leaf-wise 的过拟合风险真实存在。最终通过将 num_leaves 降到 63、min_data_in_leaf 设为 50,并加入早停,模型在验证集上恢复稳定。
本节小结:LightGBM 的高效来自直方图算法与 Leaf-wise 生长策略的协同;理解这两点,才能在信用评分建模中合理设置 max_bin、num_leaves、min_data_in_leaf 等参数,避免“训练快但过拟合”的陷阱。与 XGBoost 的对比不是优劣判断,而是场景匹配。