1. 课程导入
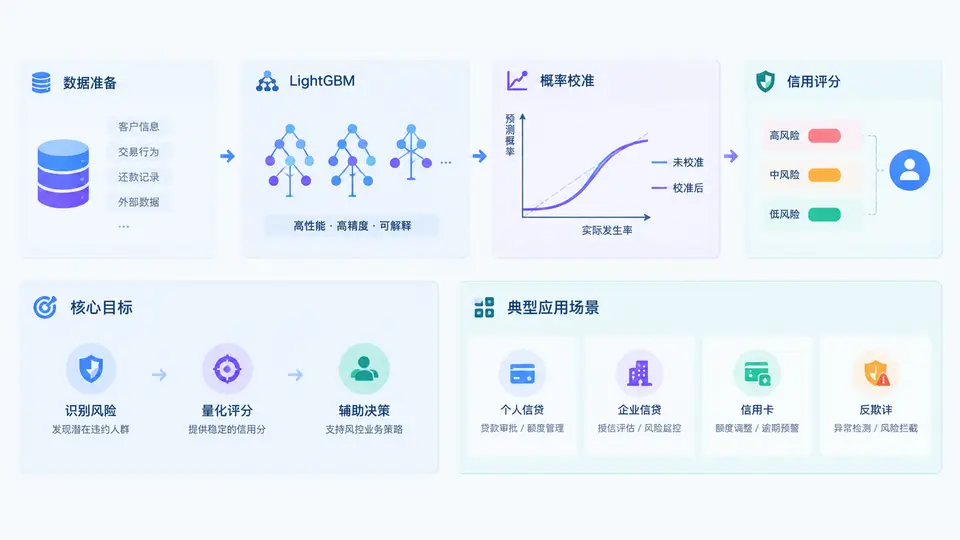
信用评分建模的本质,不是简单地把客户分成“好人”和“坏人”,而是在信息不完整、样本不平衡、业务代价不对称的条件下,估计一个客户未来发生违约的概率,并把概率转化为可执行的授信决策。很多初学者把注意力集中在模型AUC上,认为只要排序能力强,模型就足够好。但在真实风控场景中,排序能力只是第一步,概率是否准确、是否稳定、是否能直接映射到通过率与坏账率,才是决定模型能否上线的关键。本课程围绕LightGBM与概率校准展开,目标不是只教会大家调用一个梯度提升库,而是建立一条从业务目标、特征工程、模型训练、概率校准到策略应用的完整链路。
一、信用评分建模的核心目标
信用评分模型通常用于贷前审批、额度制定、利率定价和贷后预警。不同场景对模型输出的要求并不相同,但核心目标可以归纳为三点:第一,准确区分风险高低,即模型能够把未来违约概率更高的客户排在前面;第二,输出可解释、可比较的违约概率,使风险分数能够直接参与定价和决策;第三,在时间维度上保持稳定,避免因客群漂移或经济周期变化导致模型快速失效。
以贷前审批为例,业务方通常关心“如果通过率设定为60%,坏账率会是多少”。如果模型只输出一个无校准的分数,业务方无法直接回答这个问题。经过概率校准后,模型输出的分数可以近似解释为违约概率,策略人员就能基于概率阈值计算预期通过率和预期损失。例如,当校准后的违约概率阈值为0.08时,可以估算通过客群的加权平均违约概率,并进一步结合金额、期限和回收率计算风险成本。
核心认知:信用评分模型的价值 = 排序能力 + 概率准确性 + 业务可解释性 + 时间稳定性。只追求AUC,往往会得到“排序尚可但概率失真”的模型,难以直接支撑定价与拨备。
二、LightGBM与概率校准的整体学习路径
LightGBM是梯度提升决策树的高效实现,具有训练速度快、内存占用低、支持类别特征和缺失值处理等优点,非常适合风控领域常见的宽表数据。它的核心思想是不断拟合前一轮模型的负梯度,逐步降低损失函数。对于二分类信用违约任务,常用目标函数是二分类交叉熵,模型输出经过Sigmoid变换后得到违约概率。
然而,LightGBM直接输出的概率并不天然校准。原因包括:训练样本中好坏样本比例与真实客群不一致;损失函数优化的是整体对数损失,而非概率校准误差;正则化、早停和树数量选择会改变概率分布;样本权重调整也会影响输出概率的绝对水平。因此,完整学习路径应当包括以下阶段:
- 业务理解与目标定义:明确违约定义、观察期、表现期、样本口径和决策场景。
- 数据准备与特征工程:处理缺失值、类别特征、时间切分,构造稳定性较高的风险特征。
- LightGBM建模:设置目标函数、评估指标、学习率、叶子数、最小叶子样本数等参数,完成训练与验证。
- 概率校准:使用Platt Scaling、Isotonic Regression或Beta校准等方法,把模型分数映射为更准确的违约概率。
- 评估与监控:同时关注AUC、KS、Brier Score、校准曲线和PSI,确保模型既有区分度又有概率准确性。
- 策略应用:将校准概率转化为评分卡、审批阈值、额度系数和定价区间。
下面是一个LightGBM二分类训练的典型参数配置片段,后续章节会逐项解释其含义与调优方法:
params = {
    "objective": "binary",
    "metric": "auc",
    "boosting_type": "gbdt",
    "learning_rate": 0.05,
    "num_leaves": 31,
    "max_depth": -1,
    "min_child_samples": 50,
    "subsample": 0.8,
    "colsample_bytree": 0.8,
    "reg_alpha": 0.1,
    "reg_lambda": 0.1,
    "random_state": 42,
    "n_jobs": -1
}
概率校准阶段则通常采用独立校准集,避免在训练集上过拟合校准器。常见做法是把数据切分为训练集、校准集和测试集,或者使用交叉验证方式生成袋外预测概率,再拟合校准模型。校准后的概率需要重新绘制校准曲线,观察预测概率与实际违约率是否接近。
三、金融风控中的典型应用场景
信用评分与概率校准在金融风控中应用广泛,不同场景对概率精度的敏感度不同。下表列出典型场景及其对模型输出的要求:
| 应用场景 | 主要目标 | 对概率校准的要求 | 常用评估指标 |
|---|---|---|---|
| 贷前审批 | 筛选低风险客户,控制通过率与坏账率 | 高,需直接映射审批阈值 | AUC、KS、校准曲线、预期损失 |
| 额度制定 | 根据风险水平分配授信额度 | 较高,概率影响额度系数 | Brier Score、分组违约率 |
| 利率定价 | 风险越高,定价越高 | 很高,概率直接参与收益测算 | 校准误差、RAROC |
| 贷后预警 | 识别早期风险恶化客户 | 中等,更关注排序与召回 | Recall、Lift、PSI |
| 催收策略 | 预测回款概率,优化催收资源 | 较高,概率影响资源分配 | 校准曲线、成本敏感指标 |
以利率定价为例,如果模型预测某客户违约概率为5%,但实际违约率为8%,那么基于5%制定的利率可能无法覆盖风险成本。经过校准后,概率更接近真实违约水平,定价模型才能给出合理的风险溢价。再如贷前审批,如果审批阈值对应的校准概率为6%,但实际通过客群违约率达到10%,说明模型低估了风险,可能导致坏账超预期。
四、常见误区与复盘思路
在信用评分建模中,有几个高频误区值得提前警惕。第一,把AUC当作唯一目标。AUC高只说明排序好,不代表概率准。第二,在训练集上做概率校准。校准器会过拟合训练集,导致测试集校准效果变差。第三,忽略样本权重与真实客群分布差异。如果训练时对坏样本加权,输出概率会被系统性抬高或压低。第四,不做时间外验证。风控模型上线后面对的是未来客群,随机切分验证往往会高估效果。第五,把校准后的概率直接当作真实违约率,而不考虑回收率、暴露期和宏观经济变化。
复盘建议:每次建模后,至少同时查看四类结果:排序指标(AUC/KS)、概率指标(Brier/校准曲线)、稳定性指标(PSI)和业务指标(通过率、坏账率、预期损失)。只有四类结果都合理,模型才具备上线讨论的基础。
注意:概率校准不是“万能修正”。如果模型本身区分度很差,或者训练数据存在严重选择偏差,校准只能改善概率水平,无法创造有效排序能力。校准前应先确保模型具备基本的风险区分能力。
本课程后续将沿着“业务目标—数据与特征—LightGBM建模—概率校准—评估监控—策略应用”的主线逐步展开。每一章都会结合可运行的代码片段、参数说明和风控案例,帮助大家把LightGBM从“会调用”推进到“能上线、能解释、能校准”。在进入具体建模之前,先建立正确的问题框架:信用评分不是单纯追求高分数的机器学习竞赛,而是一项以概率准确性为核心、以业务决策为归宿的风险管理工程。