3. 评分卡核心概念
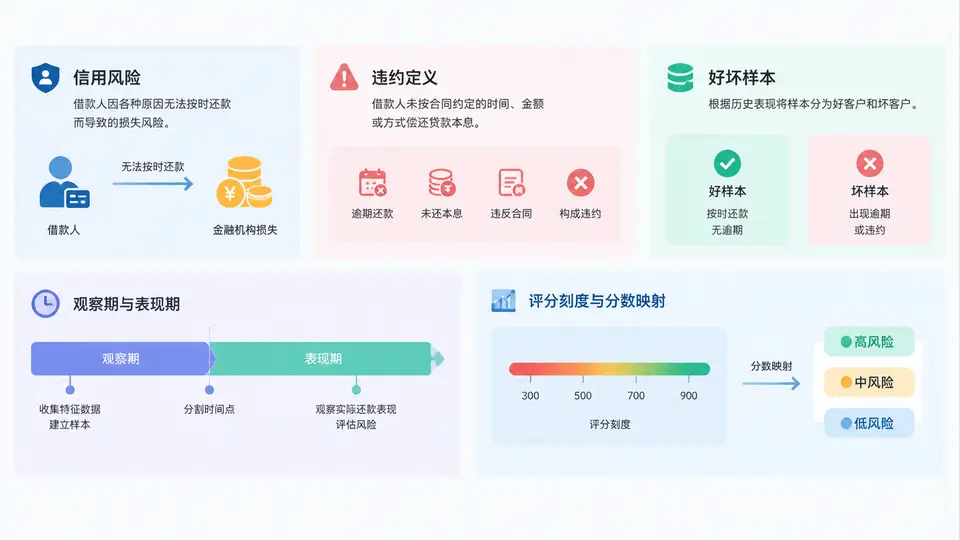
在动手写一行代码之前,必须先建立一套统一的“语言体系”。评分卡项目失败,十有八九不是算法不够先进,而是概念没有对齐:业务说的“坏客户”和模型里的“bad”不是一回事,数据团队取的观察期和风控策略假设的表现期错位,最后分数映射出来的刻度无法被审批人员理解。本节把这五个核心概念一次讲透,它们是后续所有特征工程、建模与部署工作的地基。
一、信用风险:评分卡要量化的到底是什么
信用风险(Credit Risk)指交易对手未能按约定履行偿付义务,从而给授信机构带来损失的可能性。在消费金融场景中,它具体表现为三类损失:本金损失(借款人彻底不还)、资金时间价值损失(逾期占用资金)、催收与运营成本(为追回欠款付出的额外代价)。
评分卡并不直接预测“损失金额”,它预测的是一个概率:在给定观察信息下,申请人未来发生违约的概率。这个概率随后通过刻度映射转成分数,供审批策略使用。理解这一点非常关键——评分卡是概率模型,不是利润模型;利润是概率乘以金额、利率、期限后的业务决策结果。
二、违约定义:把“坏”写成可执行的规则
“违约”不能停留在“没还钱”这种口语描述,必须落成可计算、可复现的规则。行业中最常用的是账龄口径(Delinquency Bucket),例如 M1、M2、M3,分别表示逾期 1 期、2 期、3 期。定义违约时至少要明确四个要素:
- 逾期天数或期数阈值:如“逾期 60 天以上”或“逾期 3 期及以上”。
- 观察窗口:在表现期内任意时点触及阈值即算违约,还是必须连续保持。
- 账户状态:是否包含核销、呆账、司法追偿等特殊状态。
- 金额门槛:是否设置最小逾期金额,避免几元欠款被误判为坏样本。
一个可直接落地的违约标签定义如下:
bad_flag = 1  if  max_overdue_days_in_performance >= 60
             or  account_status in ('核销', '呆账', '司法追偿')
        = 0  otherwise

# 排除规则(不参与建模)
exclude = 1 if 逾期金额 < 10 元
            or 账户在观察期内被主动关闭且无逾期
or 存在欺诈标签(欺诈单独建模)三、好坏样本:标签体系与样本选择
有了违约定义,样本被划分为三类:坏样本(bad)、好样本(good)、灰样本(indeterminate)。灰样本通常指表现期内未触及违约阈值、但也未表现出稳定履约行为的账户,例如刚放款不久、表现期不足的账户。它们既不能标为好,也不能标为坏,标准做法是排除出建模集,而不是强行归类。
样本选择还需注意两个偏差:
- 成熟度偏差:表现期未走完的账户,其“好”只是暂时的。若直接纳入,会低估真实违约率。
- 通过偏差:模型只见过被审批通过的客户,拒绝样本的表现在数据中缺失。这需要用拒绝推断或样本加权来缓解。
| 样本类型 | 判定条件 | 建模处理 |
|---|---|---|
| 坏样本 bad | 表现期内触及违约阈值 | 标签 1,纳入建模 |
| 好样本 good | 表现期完整且从未逾期超阈值 | 标签 0,纳入建模 |
| 灰样本 indeterminate | 表现期不足或状态不明确 | 排除,不参与训练 |
| 欺诈样本 fraud | 存在欺诈认定 | 单独建模,不混入信用模型 |
四、观察期与表现期:时间窗口的切分
这是最容易被忽视、却最影响模型有效性的概念。评分卡依赖“用过去预测未来”,因此必须把时间轴切成两段:
- 观察期(Observation Window):采集特征的时间段。例如 2023-01 至 2023-06,用这半年的申请信息、征信查询、还款行为构造特征。
- 表现期(Performance Window):观察期结束后,跟踪客户是否违约的时间段。例如 2023-07 至 2024-06,共 12 个月。
观察期与表现期的长度选择是一场权衡:表现期太短,坏样本还没暴露,标签被低估;表现期太长,数据陈旧,无法反映当前客群。消费金融常见配置是观察期 6~12 个月、表现期 12~18 个月,具体取决于产品期限和账龄滚动速度。
五、评分刻度与分数映射:让概率变成可沟通的分数
模型输出的是违约概率 PD,但审批人员更习惯“分数”。分数映射的本质是一次线性变换,把概率转成具有业务含义的刻度。行业通用做法是设定基准分与方向:
score = offset + factor * ln(odds)
其中 odds = P(good) / P(bad)
factor = PDO / ln(2)
offset = base_score - factor * ln(base_odds)

# 示例参数
base_score = 600   # 基准分
base_odds  = 50    # 基准好坏比 50:1
PDO        = 20    # 每增加 20 分,好坏比翻倍
这套参数的含义是:分数越高,违约风险越低;分数每提高 20 分,好坏比翻一倍。它带来的好处是分数具有可解释的线性风险含义,便于设定审批阈值、额度分层和定价策略。
| 分数区间 | 风险等级 | 建议策略 |
|---|---|---|
| ≥ 700 | 低风险 | 自动通过,可提额 |
| 640 ~ 699 | 中低风险 | 自动通过,标准额度 |
| 580 ~ 639 | 中高风险 | 人工复核或降额 |
| < 580 | 高风险 | 拒绝或要求增信 |
把以上五个概念串起来看:信用风险定义了建模目标,违约定义把目标变成标签,好坏样本划分确定了训练数据,观察期与表现期规定了时间边界,评分刻度则把模型概率翻译成业务语言。这五步任何一步含糊,后续的特征工程和模型评估都会失去意义。建议在项目启动文档中把这五项写成明确的“建模公约”,由业务、风控、数据三方签字确认后再进入开发。