3. 混淆矩阵与基础指标
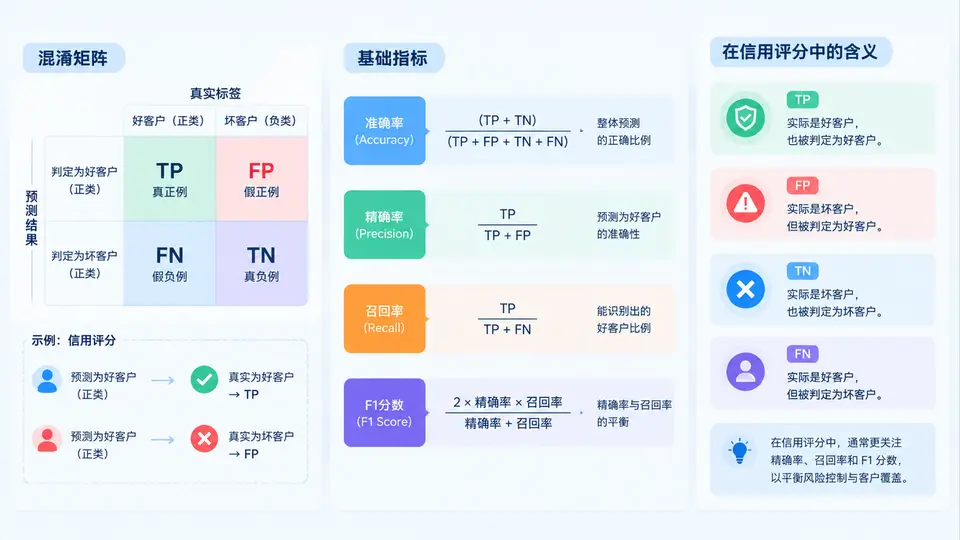
在信用评分模型中,我们真正关心的不是模型“算出了什么分数”,而是“这个分数把客户分成了什么”。混淆矩阵就是把这个“分”的结果摊开来看的一张基础表。它把样本按真实标签和模型预测标签交叉计数,形成四个格子:TP、FP、TN、FN。理解这四个格子,是理解后续KS、AUC、Gini等排序指标的前提。
一、核心原理:四个格子定义了什么
在信用评分场景中,通常把“违约/坏客户”定义为正例(Positive),“正常/好客户”定义为负例(Negative)。模型输出一个概率或分数后,通过阈值切分,得到预测结果。于是有:
- TP(True Positive,真阳性):真实为坏客户,模型也预测为坏客户。这是被成功拦截的风险。
- FP(False Positive,假阳性):真实为好客户,模型却预测为坏客户。这是“误杀”,会导致优质客户被拒绝。
- TN(True Negative,真阴性):真实为好客户,模型也预测为好客户。这是正确放行的正常客户。
- FN(False Negative,假阴性):真实为坏客户,模型却预测为好客户。这是“漏放”,会导致坏客户被授信,形成潜在损失。
这四个格子不仅是计数,更对应了信用业务中的两类代价:FP对应拒绝好客户带来的业务机会损失,FN对应放行坏客户带来的资金损失。混淆矩阵的价值,就是让这两类错误同时可见。
二、方法流程:从混淆矩阵到基础指标
有了TP、FP、TN、FN,就可以计算一系列基础指标。它们的公式和业务含义如下表所示:
| 指标 | 公式 | 信用评分中的含义 |
|---|---|---|
| 准确率 Accuracy | (TP + TN) / (TP + FP + TN + FN) | 整体判断正确的比例,但在坏客户占比很低时容易虚高,参考价值有限。 |
| 精确率 Precision | TP / (TP + FP) | 预测为坏客户的名单中,真正坏客户的比例。越高,说明拒绝名单越“准”。 |
| 召回率 Recall | TP / (TP + FN) | 真实坏客户中被模型抓出来的比例。越高,说明风险拦截越全面。 |
| F1分数 | 2 × Precision × Recall / (Precision + Recall) | 精确率与召回率的调和平均,用于在两者之间找平衡。 |
计算过程可以用一段简单的Python代码表示:
TP = 120   # 坏客户被正确拒绝
FP = 80    # 好客户被错误拒绝
TN = 880   # 好客户被正确放行
FN = 30    # 坏客户被错误放行

accuracy = (TP + TN) / (TP + FP + TN + FN)
precision = TP / (TP + FP)
recall = TP / (TP + FN)
f1 = 2 * precision * recall / (precision + recall)

print(f"Accuracy: {accuracy:.4f}")
print(f"Precision: {precision:.4f}")
print(f"Recall: {recall:.4f}")
print(f"F1: {f1:.4f}")
运行结果会显示:准确率约为0.901,精确率约为0.600,召回率约为0.800,F1约为0.686。可以看到,虽然准确率很高,但精确率只有0.6,意味着每拒绝100个客户,约有40个是好客户被误杀。这正是信用评分中不能只看准确率的原因。
三、案例场景:阈值变化如何影响指标
假设某消费金融公司用逻辑回归模型预测违约概率,初始阈值设为0.5。此时混淆矩阵为:TP=120,FP=80,TN=880,FN=30。业务部门认为坏客户漏放太多,希望提高召回率。于是把阈值从0.5降到0.3,更多客户被划为坏客户。新的混淆矩阵可能变为:TP=140,FP=180,TN=780,FN=10。
此时召回率从0.800提升到0.933,但精确率从0.600下降到0.438。也就是说,虽然抓到了更多坏客户,但误杀的好客户也大幅增加。F1分数从0.686变为0.596,整体平衡反而变差。这个案例说明:阈值是混淆矩阵的“旋钮”,调阈值就是在调FP和FN的交换关系。
在信用评分中,没有“唯一正确”的阈值。阈值选择取决于业务目标:如果资金损失敏感,优先提高召回率;如果获客成本高、好客户价值大,则要控制FP,优先保证精确率。
四、误区与复盘:信用评分中容易踩的坑
第一个常见误区是“准确率崇拜”。在违约率只有5%的数据集中,一个把所有客户都预测为好客户的模型,准确率也能达到95%。但这个模型的召回率为0,完全无法识别坏客户。因此,在信用评分中,准确率只能作为参考,不能作为核心决策指标。
第二个误区是“只看精确率或只看召回率”。精确率高但召回率低,意味着模型很保守,只拒绝最有把握的坏客户,会漏掉大量风险;召回率高但精确率低,意味着模型过于激进,会误杀大量好客户。F1分数的作用就是提醒我们同时关注两者。
第三个误区是“混淆矩阵是静态的”。实际上,随着阈值、客群、时间窗口变化,混淆矩阵会不断变化。建议在模型监控中定期输出混淆矩阵,观察FP和FN的比例是否发生漂移。
注意:在信用评分中,FP和FN的业务代价通常不对等。FN(漏放坏客户)可能带来本金损失,FP(误杀好客户)可能带来利息损失和客户体验下降。因此,在评估模型时,应结合业务成本矩阵,而不是单纯追求F1最大化。
最后,用一句话总结:混淆矩阵是信用评分模型评估的“地基”,TP、FP、TN、FN四个格子决定了准确率、精确率、召回率和F1分数的计算方式,也决定了我们如何看待模型在风险拦截与客户体验之间的平衡。只有先看清这四个格子,后续的KS、AUC和Gini才有坚实的解释基础。